Как работают алгоритмы рекомендаций: от первых экспертных систем до современного искусственного интеллекта

Как работают алгоритмы рекомендаций в 2024 году: от YouTube до маркетплейсов. Разбираем историю, технологии и мифы об информационном пузыре
Павел Ельцов 16 сентября 2026 в 08:35

Задумывались ли вы когда-нибудь, кто выбирает, какой ролик показать вам первым при запуске YouTube? Алгоритмы рекомендаций окружают нас повсюду — даже эту статью вы, скорее всего, нашли благодаря им. Причём не только в социальных сетях: почти во всех современных сервисах и приложениях теперь есть рекомендации. В интернет-магазинах, стриминговых платформах, голосовых ассистентах и даже в списке приложений на смартфоне — везде.

Несмотря на широкое распространение, мало кто знает, как именно работают алгоритмы рекомендаций. Из-за этого возникает множество мифов и догадок. Например, что алгоритмы помещают нас в информационный пузырь и не дают никакого выбора в плане контента. То есть сервисы теперь якобы за нас решают, что нам слушать, смотреть и даже покупать. Так ли это на самом деле?
Чтобы максимально точно ответить на этот вопрос, давайте пройдём всю историю систем рекомендаций, посмотрим, как это работает сейчас, как анализируются песни и фильмы, и почему на главной странице маркетплейса вам предлагают купить именно эти товары.

История рекомендательных систем: от научных лабораторий к повседневной жизни

Первые алгоритмы рекомендаций появились ещё в середине 1960-х годов прошлого века. Тогда они назывались экспертными системами и советовали не кино на вечер, а помогали с решением научных вопросов. Такие системы разрабатывались, чтобы вобрать в себя все знания экспертов из определённой области, а затем самостоятельно интерпретировать данные на основе этих знаний.
Самая первая такая система была создана в 1965 году учёными Стэнфордского университета. Она называлась Dendral и определяла молекулярную структуру химического соединения по спектральному анализу. В систему на вход подавалась информация о веществе и данные спектрометрии — грубо говоря, в каком спектре оно сильнее всего светится. А система, в свою очередь, выдавала диагноз в виде соответствующей химической структуры.

Как это работало? Внутри системы существовала большая база данных, а поиск происходил путём поэтапного отбрасывания тех вариантов, которые точно не подходили. Например: «соединение точно газообразное? Здесь не сходится». Такой метод, когда путём задавания наводящих вопросов или уточнения данных сужается область поиска, назвали эвристическим программированием. Кстати, с него и началась история машинного обучения, которое позже сыграет значительную роль в становлении и развитии современных рекомендательных алгоритмов.

А пока что существовали только экспертные системы, и они хорошо работали в научной сфере, где важна точность, а изменения вносятся не так уж часто. Но были и другие проблемы: всё это оказалось дорого, долго и неудобно. Нужен был другой подход — более гибкий, адаптивный и простой для пользователей.

Первая современная рекомендательная система

Примером такого нового подхода, первой рекомендательной системы в современном понимании, принято считать онлайн-библиотеку Grouplens (GBIB). Этот сервис спрашивал пользователя о предпочтениях и выделял их в группы по интересам, а затем формировал для каждой группы подборки книг. То есть информация о пользователе собиралась не на основе истории чтения, а на базе опроса.
Этот подход был раскритикован в научном сообществе, и не зря. По мнению учёных, в подобных опросах большинство людей указывают не объективную информацию о себе, а скорее такую, которая сможет их как-то выигрышно выделить среди окружающих. Читали ли вы, например, всего Шекспира? Из этого получаются неточные рекомендации.
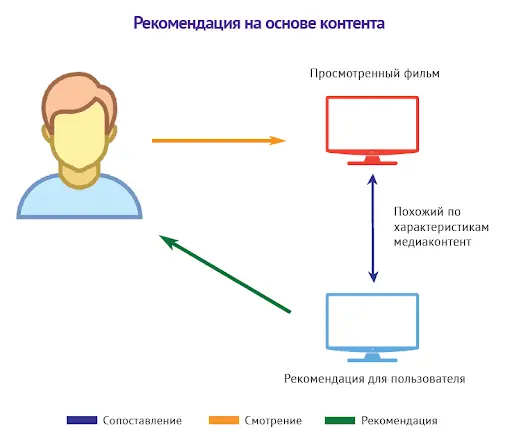
Несмотря на это, система стала отличным концептом того, на что могут быть способны рекомендательные системы, если подойти к ним более грамотно. Для дальнейшего развития рекомендаций надо было разобраться с двумя проблемами: во-первых, как вообще определить похожих пользователей, и во-вторых, как рекомендовать что-то, не задавая или почти не задавая вопросов о предпочтениях пользователя.

Современные алгоритмы рекомендаций: как компьютер находит похожих пользователей

Большинство современных алгоритмов рекомендаций выстраиваются вокруг того, что двум похожим пользователям рекомендуется, например, один и тот же товар или один и тот же фильм. Нам с вами довольно просто понять, похож ли один человек на другого, совпадают ли его вкусы. Но как это сделать компьютеру, в котором нет ничего, кроме нулей и единиц?
Алгоритмы, основанные на памяти

Для этого существуют два основных типа алгоритмов: основанные на памяти и основанные на модели. Алгоритмы, основанные на памяти, анализируют и хранят информацию о предыдущих взаимодействиях с контентом или оценках, которые поставили пользователи, а потом находят похожих пользователей.

Например, есть пользователь номер один — он читает Достоевского, Толстого и Некрасова и ставит хорошие оценки их произведениям. Есть пользователь номер два — он читает Достоевского и Некрасова. Алгоритм посчитает, что эти пользователи похожи, и предложит второму ознакомиться с творчеством Толстого. Вроде бы неплохо.
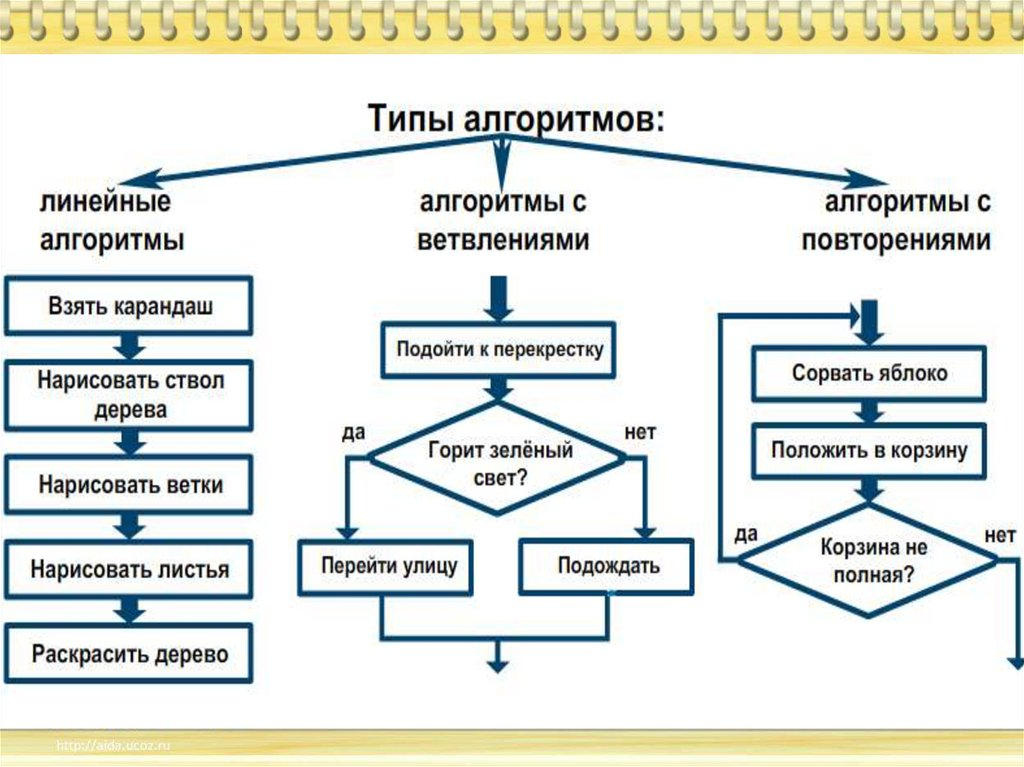
Но если первый пользователь вдруг начнёт читать Донцову, то второму пользователю алгоритм предложит ту же самую книгу. И такая рекомендация не факт что будет релевантной. Из-за таких неточностей от алгоритмов, основанных на памяти, уже довольно давно отказались.

Алгоритмы, основанные на модели

Сейчас похожих пользователей определяют алгоритмы, основанные на модели. Они строят математическую модель, которая учитывает сходство между пользователями с помощью различных математических методов, а также нейросетей. Алгоритм ищет смысловые закономерности или скрытые факторы, связанные с интересами пользователей.
Например, анализируется поведение человека на сайте. Да, некоторые сайты записывают абсолютно все ваши действия. Но за счёт такого большого комплексного подхода уменьшается количество ошибок, которые могут возникнуть из-за непоследовательности в поведении пользователя.

Кстати, вопреки распространённому мнению, любые алгоритмы поиска похожих пользователей работают с обезличенными данными. Алгоритмам не интересна личная информация людей — они сразу же её отсекают, так как она не несёт никакой полезной информации для рекомендаций.

Коллаборативная фильтрация

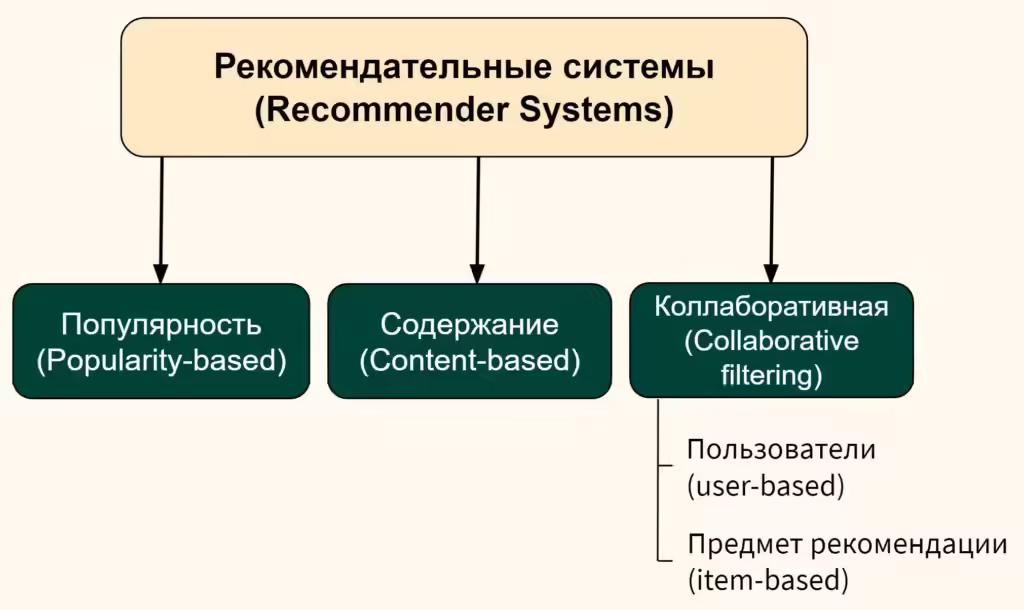
Оба рассмотренных алгоритма — это части рекомендательных систем со сложным названием «коллаборативная фильтрация». В них рекомендации формируются более естественным путём, нежели в экспертных системах. Нет необходимости в опросе пользователя — он просто заходит в сервис, начинает им пользоваться, и алгоритм постепенно формирует его профиль и устанавливает связь между пользователями.

Революция Amazon: рекомендации на основе похожести товаров

Широко применять коллаборативные алгоритмы одними из первых начали в компании Amazon. Там эти алгоритмы использовались для рекомендации товаров. В 1998 году основатель Amazon Джефф Безос сказал: «Если у нас есть 4,5 миллиона клиентов, у нас должен быть не один интернет-магазин — их должно быть 4,5 миллиона».
Однако у алгоритмов Amazon была небольшая особенность. Дело в том, что Amazon выстраивает свой алгоритм не на основе похожести пользователей, а на основе похожести товаров. То есть наоборот: на основе покупок пользователей алгоритм определяет, какие товары вместе оказались в корзине.
Получается множество таких цепочек из товаров. Например, кто-то вместе с тарелками купил вилки, а другие пользователи вместе с вилками купили средство для мытья посуды. Значит, алгоритм будет предлагать тарелки, вилки и средства для мытья посуды вместе.

Проблема непредсказуемых покупок

Здесь есть нюанс. В общем случае и для небольших покупок такой алгоритм будет работать скорее всего хорошо. Но люди, приобретающие большое количество товаров за раз, только запутаются. Или те, кто вместе со смартфоном покупает ушную палочку или гель для душа — бывает и такое.
Как же отличить действительно связанные товары от человеческой непосредственности? Мы уже рассматривали эту проблему, когда говорили о похожих пользователях. Но в конце девяностых годов ещё не было достаточно продвинутых алгоритмов искусственного интеллекта.

Фильтрация на основе знаний

Было найдено другое решение — немного вмешаться в работу алгоритмов и создать базу знаний. В ней к каждой категории товаров прикреплены смежные с ними товары. Например, к телефонам прикрепляются чехлы и стёкла, а к фотоаппаратам — карты памяти. Алгоритму остаётся только подсказать подходящий чехол или карту памяти нужного стандарта.
Такая система называется системой с фильтрацией на основе знаний. Несмотря на стремительный взлёт алгоритмов искусственного интеллекта в последние годы, такая фильтрация на основе знаний до сих пор используется и остаётся актуальной. Система знаний и искусственный интеллект дополняют друг друга для максимально точных рекомендаций.
Именно так, например, работают рекомендации Яндекс Маркета. Вопреки расхожему мнению, что в маркетплейсах алгоритмы настроены так, чтобы рекомендовать товары, которые сервису выгодно продать, это не так. Дело в том, что если показывать пользователю вместо товаров по его бюджету какие-то другие, гораздо более дорогие, он просто не станет их покупать. К тому же это создаёт впечатление общей дороговизны маркетплейса, что может привести к оттоку покупателей.

Поэтому отсутствие таких вмешательств и максимально точные рекомендации на основе знаний о товарах и персонального опыта использования сервиса выгодны всем — и покупателям, и самому сервису.

Проблема холодного старта и её решения

У коллаборативных алгоритмов есть определённые недостатки. Главный из них — проблема холодного старта. Когда интернет-магазин или любой другой сервис только начинает работу, в его базе данных ещё нет информации о пользователях. В этом случае рекомендательной системе не на что опираться при подборе товаров или контента.
Сбор и анализ данных о пользователях необходимо начать как можно раньше. Но в первое время рекомендаций будет мало, и они могут быть не очень точными. Чтобы улучшить рекомендации, можно поделиться своими личными данными с системой — например, заполнить профиль. При первом запуске вам предлагается явно указать свои предпочтения: выбрать любимые музыкальные группы, фильмы, которые нравятся, и так далее.

Проблема новых товаров

Другая проблема возникает, когда в сервис добавляют новый товар, и у него ещё нет оценок и отзывов. Из-за этого алгоритмы плохо понимают, кому рекомендовать товар. Это называется задержкой. В такой ситуации рекомендательная система ориентируется только на атрибуты товара, пока не накопятся оценки и отзывы.
Эта проблема вполне актуальна и для музыкальных сервисов, и для видеостриминговых платформ. Однако она становится всё меньше и меньше с появлением и распространением машинного обучения.

Машинное обучение в рекомендательных системах

Машинное обучение приходит на помощь там, где коллаборативная система просто невозможна. Например, в сервисе поиска такси пользователи похожи лишь тем, что утром едут на работу, а вечером домой. Но каждый из своей точки А в свою точку Б.
Сервис иногда подсказывает удобную точку для начала поездки, чтобы машине было проще подъехать, а вам — найти её. А вот если всем предлагать один и тот же пункт назначения, то ничего хорошего из этого не выйдет. С другой стороны, если неточно предсказывать, куда хочет поехать пользователь, это приведёт к дополнительным затратам времени.

Рекомендации музыки: от жанров к анализу частот

С товарами всё просто и понятно — у них есть вполне объективные измеряемые свойства: точная категория, цвет, размер, вес и так далее. С поездками на такси тоже: время, день, место назначения — всё можно измерить и учесть. Но как измерять, например, музыку? Как компьютеру дать понять, похожа ли одна песня на другую? Как сразу выяснить, какая музыка понравится пользователю?

На первые два вопроса ответ скорее есть, а вот на последний — скорее нет. Как мы уже говорили, холодный старт — это одна из главных проблем алгоритмов рекомендаций. Обычно сервис просит выбрать любимые жанры музыки, если речь идёт про музыкальный стриминг. Это хорошо подходит для составления первого впечатления о вкусах пользователя.

Проблема жанров

Но спросите у любого музыканта, что он думает по поводу жанров музыки. Он, скорее всего, скажет, что это очень субъективная вещь, особенно сейчас, когда жанровые рамки размыты как никогда. Некоторые сервисы, которые всё ещё оперируют жанрами, насчитывают их более 6000. Знаете ли вы, например, что такое Progressive Sludge Metal?
Разделение по жанрам быстро превращается в проблему для рекомендаций. Тогда есть следующая идея: рекомендовать по исполнителям. Выглядит более надёжно — зачастую исполнители редко меняют свой жанр и звучание. Так что пользователю можно всегда порекомендовать новый альбом его любимого автора, а также другим пользователям со схожими вкусами.

Проблема рекомендаций по исполнителям

Однако и здесь есть сложности. Американская фан-группа Vulfpeck в 2014 году выпустила альбом Sleepify. Он состоял из десяти треков тишины — полной тишины. Но так как у группы была фанатская база, музыкальный сервис рекомендовал этот альбом всем её подписчикам и людям со схожими интересами. Музыканты смогли заработать около 20 000 долларов на этом альбоме. Неизвестно, получили ли они действительно эти деньги, но случай довольно показательный.

Есть и ещё одна проблема: исполнители, которых никто или почти никто никогда не слушал. Как рекомендовать их?

Матричный подход

Выходит, нужен совершенно другой подход. Нужно сделать матрицу — не альтернативную реальность, а просто большую таблицу, где по строкам будут пользователи, а по столбцам — треки. На пересечении будет оценка: лайк или дизлайк.
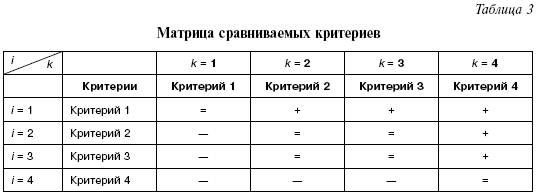
С помощью математики из такой таблицы можно выделять векторы для каждого трека. Что это значит? Это значит, что у трека появляется некое направление в сторону тех пользователей, которым он может понравиться. Это делает рекомендации точнее. Так можно отказаться от рекомендаций отдельных исполнителей и альбомов, потому что теперь всё рассчитывается на основе конкретного трека.

Осталась одна загвоздка: всё ещё есть треки, которые никто или почти никто не слушает. Как рекомендовать их?

Анализ частот

Остался последний вариант — заглянуть внутрь самого трека. Музыка по сути — это просто набор звуковых частот. У каждой песни есть низкие частоты (это бас), средние частоты (это основной инструмент, например гитара) и высокие частоты (в основном это голос или вспомогательный инструмент, а также перкуссия).
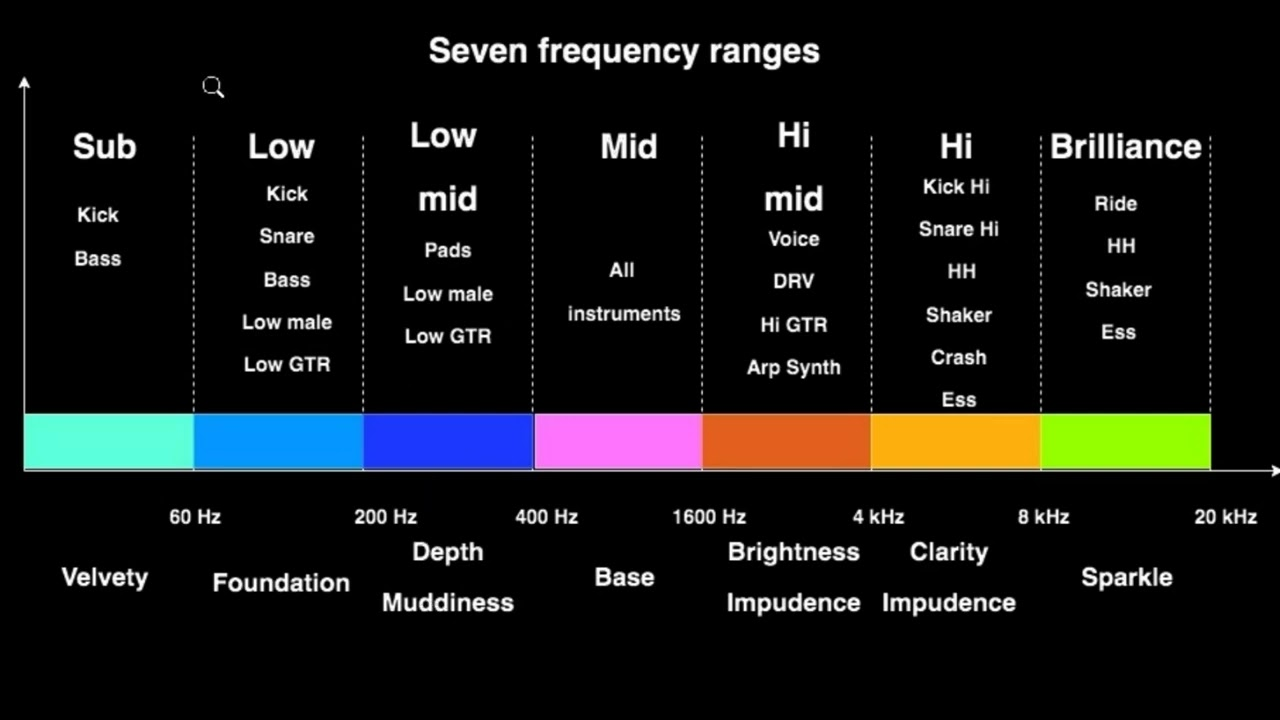
Вопрос в соотношении и балансе этих частот, что образует тембр. Например, в танцевальной музыке низких частот больше, чем в остальных направлениях. Так что, разложив треки на частоты, можно достаточно точно определить его направление, темп, ритм и в целом энергетику. Затем с помощью нейросети можно сравнить этот трек с другими, найти похожие и рекомендовать вместе с ними.

Миф о резких изменениях рекомендаций

Существует мнение, что рекомендации, особенно музыкальные, резко перестраиваются от любого лайка. Это действительно было так, когда активно использовались алгоритмы, основанные на памяти, которые мы с вами уже обсудили на примере книг.
А теперь для определения предпочтений и похожих пользователей используются более сложные комплексные системы, которые учитывают долгую историю взаимодействия с сервисом. Современный алгоритм не поменяет представления о пользователе от одного лайка или просмотра нетипичного для него контента.

Вместо этого могут сильно поменяться попытки алгоритма вывести пользователя за пределы привычного. Раз уж понравилось что-то новое, алгоритмы попробуют предложить больше похожего. Но и здесь решение за пользователем: если такой контент понравится, то алгоритм продолжит, а если нет — то нет.
Например, именно так работает «Моя волна» в Яндекс Музыке. Она запоминает предпочтения слушателей даже без лайков и дизлайков. Если трек дослушан до конца, то, скорее всего, он понравился. А если пропущен, можно считать его как бы за дизлайк. Такой фидбек называется поведенческим, и всё больше сервисов комбинирует эту явную и неявную обратную связь для максимально точных рекомендаций.

Рекомендации фильмов: сложности видеоконтента

Получается, алгоритмы умеют разбирать музыку буквально на отдельные звуковые волны. А с кино так тоже можно? К сожалению, пока нет — но, кажется, только пока.
Тем не менее, сейчас нейросети не умеют смотреть кино и оценивать его по различным параметрам. Поэтому рекомендательные системы видеостриминговых платформ опираются больше на действия пользователей: оценки, жанры, эпохи, досмотрел ли пользователь фильм до конца и прочие параметры. А алгоритмам помогают кинокритики.

История Netflix

Вопрос рекомендации фильмов был актуальным ещё до появления стриминга. Всем известный Netflix начал с проката DVD, и уже тогда у них существовал алгоритм рекомендаций на базе коллаборативной фильтрации.

Когда пользователь брал в аренду DVD-диск, Netflix использовал информацию о его предыдущих арендах и оценках для предложения подходящих фильмов. Для этого Netflix создал матрицу рекомендаций, которая показывала, какие фильмы были арендованы. Затем алгоритм анализировал эти данные и предлагал людям фильмы, которые понравились другим людям, которым понравились похожие фильмы. Больше ничего не учитывалось — только жанры и оценки пользователей.

Для небольшого сервиса рассылки такой подход вполне работал. Но для огромного онлайн-кинотеатра нужно было что-то более сложносочинённое.

Проблема рейтингов

С другой стороны, зачем что-то усложнять? Ведь у каждого фильма в онлайн-кинотеатре есть рецензии и оценки от критиков и пользователей. Можно же просто рекомендовать фильмы с наивысшей оценкой.
Идея вроде хорошая, но не всё так просто. Высшие оценки от пользователей и критиков получают редкие шедевры, классика кинематографа и какой-нибудь артхаус. В таком случае список рекомендаций можно было бы заканчивать после просмотра всех фильмов с Томом Хэнксом. Ничего плохого, конечно, но пересматривать каждый день не обязательно.

Получается, рекомендовать фильмы исключительно по рейтингу точно не вариант. Нужно соблюсти некий баланс между оценками и интересами.

Информационный пузырь: миф или реальность?

Хорошо, что мы затронули вопрос общих рекомендаций, потому что это один из способов, как алгоритмы могут бороться с эффектом так называемого информационного пузыря.
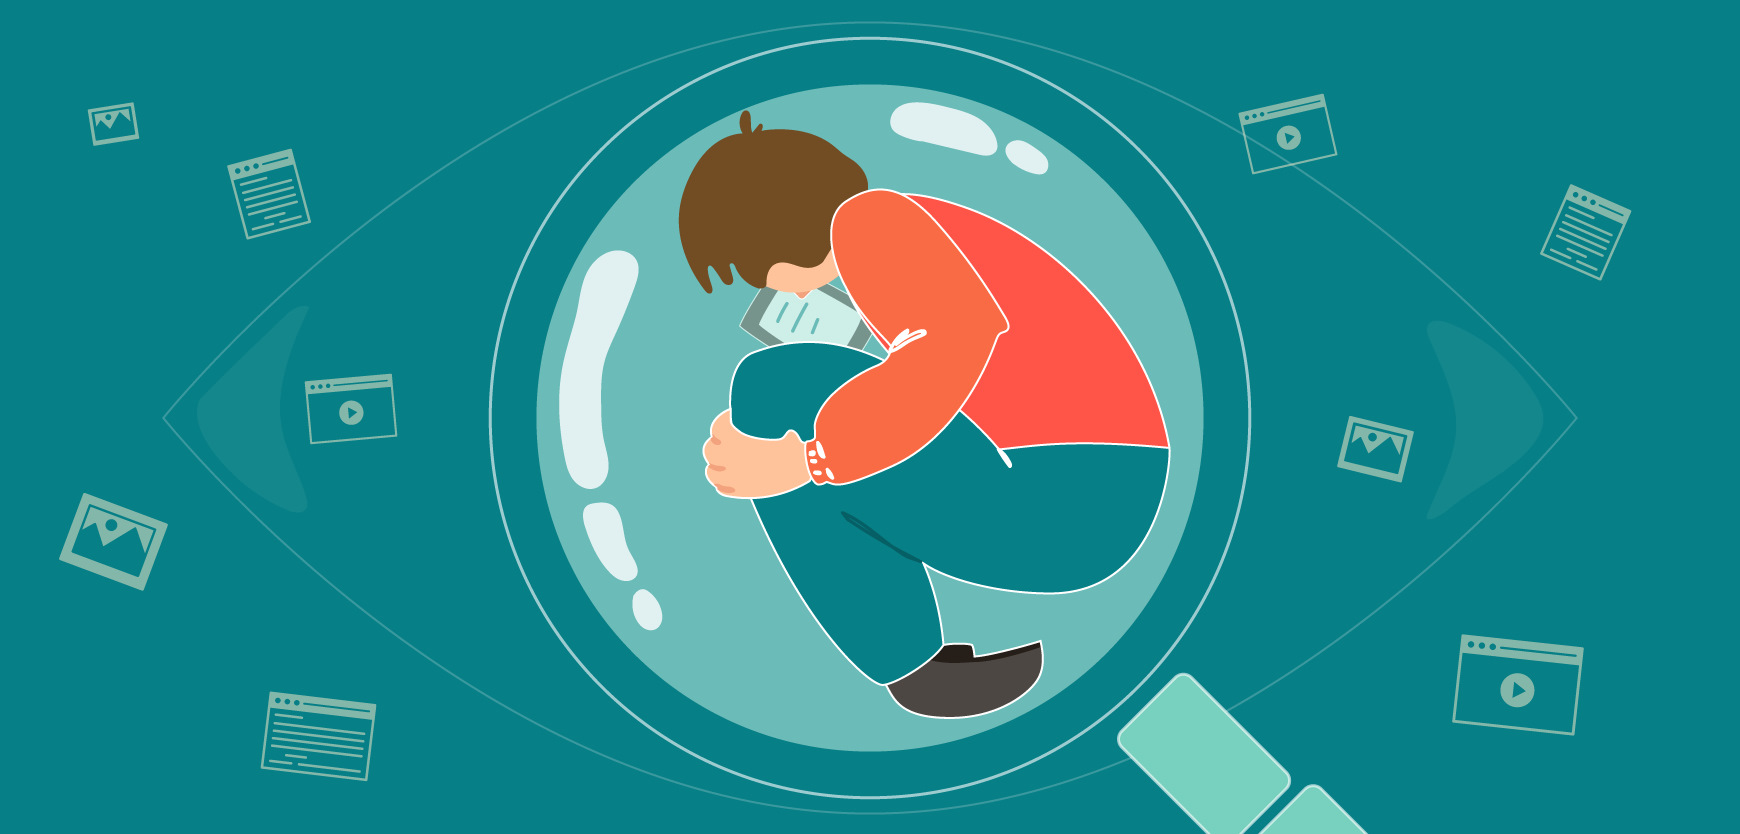
Возникновение такого эффекта кажется вполне логичным: если алгоритм рекомендует пользователю контент, похожий на тот, что ему нравится, то со временем он будет получать всё больше и больше похожего контента. Выходит, что пользователь никогда не узнает о новых жанрах, режиссёрах или музыкальных группах. Кошмар!

Борьба с информационным пузырём

Но мы с вами как раз разобрали новый алгоритм Яндекс Музыки. Разработчики специально сделали фокус на том, чтобы по максимуму рекомендовать новую музыку, особенно не самых популярных исполнителей. А плейлист «Моя волна» старается снижать долю наиболее часто прослушиваемых треков и предлагать незнакомые. Но делает это аккуратно, чтобы всё-таки не отталкивать совсем незнакомой музыкой.
Или новую систему рекомендаций КиноПоиска, внутри которой используются оценки критиков, коллаборативные алгоритмы и общие рекомендации. Всё это нацелено как раз на то, чтобы постепенно знакомить пользователя с чем-то новым.

Вопрос выбора между чем-то привычным, базовым, и чем-то новым, азартным, похож на один из главных вопросов личной философии и, наверное, важную черту характера каждого человека. В этом смысле задача алгоритма — подстроиться под каждого конкретного пользователя.

Заключение: технологии на службе пользователя

Мы с вами изучили, как работают современные алгоритмы рекомендаций, как они подстраиваются под ваши интересы и постоянно знакомят вас с чем-то новым. В выигрыше, скорее, остаёмся мы — пользователи.

Но выбор использовать ли эти технологии, остаётся за вами. Например, Яндекс позволяет отключить рекомендации в своих сервисах — тоже неплохая опция для ретроградов.

Лично вы за что: проверенная классика или что-то новенькое? В любом случае современные рекомендательные системы стремятся найти баланс между знакомым и новым, между точностью и разнообразием, между персонализацией и открытием нового контента.

Апскейлинг видео: как технологии превращают Full HD в 8K без потерь качества

Апскейлинг видео: как ИИ превращает Full HD в 8K. Разбор технологий повышения разрешения, методов интерполяции и современных алгоритмов.
Павел Ельцов 20 июня 2026 в 11:30

Комфортно ли вам смотреть видео в низком разрешении? Этот вопрос волнует многих пользователей современных устройств. Разрешение определяет размер видео — его высоту и ширину. Представьте, что вы смотрите контент в разрешении 480p на большом экране. В таком случае изображение займёт не более десятой части площади дисплея. Безусловно, просмотр был бы комфортнее, если бы картинка стала больше.

Но что происходит, когда мы просто увеличиваем видео? Казалось бы, решение очевидно — растянуть изображение на весь экран. Однако результат оказывается далёким от идеала. Видео действительно занимает всю площадь экрана, но его разрешение — то есть количество пикселей — остаётся прежним. Многие замечали, что на большом телевизоре старые видео и фильмы выглядят нечёткими, размытыми. Возникает закономерный вопрос: можно ли это исправить?

Ответ — да. На помощь приходят современные алгоритмы апскейлинга.

Что такое апскейлинг и как он работает

Апскейлинг — общее название множества технологий, которые увеличивают разрешение изображений. Эта технология применяется повсеместно. Когда вы запускаете фильм в низком качестве на 4K-телевизоре, картинка обязательно проходит через апскейлинг. При этом качество обычно не улучшается заметным образом. Дело в том, что простые алгоритмы увеличения разрешения не анализируют содержимое изображения и не дорисовывают новые детали, а просто растягивают то, что есть.

Принципы работы алгоритмов повышения разрешения

Как вообще устроены алгоритмы повышения разрешения? Как работают современные апскейлеры и как с их помощью улучшается качество наших любимых видео и фильмов? Как применение искусственного интеллекта позволило сделать апскейлинг более качественным? Давайте разберёмся.

В самом масштабировании разрешения нет ничего сложного и инновационного. Существует несколько десятков алгоритмов, с помощью которых можно в реальном времени увеличивать или снижать разрешение изображения, подгоняя его под размеры и особенности экрана.

Апскейлинг может выполняться:

  • На стороне источника (компьютером или консолью)
  • На стороне устройства вывода (монитором или телевизором)
  • Даже специальными кабелями

Чаще всего конвертация происходит устройством отображения. Источник отправляет кадр в заданном (часто называемом нативном) разрешении, а задачу по тому, чтобы он занимал всю площадь экрана и минимально терял в качестве, решает уже экран — телевизор или монитор.

Два типа технологий апскейлинга

Способов увеличения разрешения изображения существует большое множество. Говоря об апскейлинге, необходимо разделять его разновидности, так как они обеспечивают совершенно разное качество изображения на выходе.

Прежде всего, технологии увеличения разрешения изображения делятся на две большие группы:

  1. Математические алгоритмы
  2. Алгоритмы, основанные на применении искусственного интеллекта и машинного обучения

Математические методы: интерполяция

Как вообще работает улучшение разрешения? Откуда возьмутся новые пиксели? Все технологии апскейлинга работают за счёт интерполяции.

Что такое интерполяция

Простыми словами, интерполяция — это использование известной информации для прогнозирования неизвестной.

Приведём простой пример. Допустим, нам известно, что в 10:00 температура за окном составляла 20°C. Также известно, что температура в 12:00 была уже 30°C. Нам нужно узнать, сколько градусов было в 11:00.

Зная температуру в 10 и 12 часа утра, мы можем предположить, что в 11 она была чем-то средним между этими значениями — то есть 25°C. То, что мы сейчас сделали, называется методом линейной интерполяции.

Теперь допустим, что у нас появилось ещё одно измерение — мы знаем, какая температура была в 10:30. Получается, что в первые полчаса температура росла быстрее, чем потом. Если мы используем это новое измерение для попытки угадать температуру в 11:00, то мы уже применяем метод квадратической интерполяции.

Чем больше измерений будет доступно, тем более комплексный и, разумеется, более точный у нас получится алгоритм интерполяции.

Применение интерполяции к изображениям

При увеличении разрешения изображения количество пикселей тоже увеличивается. Например, количество пикселей в 4K-изображении в четыре раза больше, чем в Full HD. Откуда же берутся эти новые пиксели при апскейлинге?

Они дорисовываются специальными алгоритмами, которые как раз основаны на интерполяции.

Метод ближайшего соседа

Самый простой из таких алгоритмов — метод ближайшего соседа. Это самый примитивный и быстрый метод: для каждого пикселя конечного изображения выбирается один пиксель исходного, находящийся к нему ближе всего с учётом масштабирования. В результате каждый пиксель просто становится больше.

Метод простой и понятный, но даёт очень пикселизованное изображение при увеличении. Нам такой метод не подойдёт.

Билинейная интерполяция

Билинейная интерполяция рассматривает квадрат размером 2×2 известных пикселя, окружающих неизвестный. В качестве результата используется взвешенное усреднение этих четырёх пикселей. Грубо говоря, при билинейной интерполяции цвет нового пикселя выбирается как средний между цветами четырёх соседних пикселей.

В результате изображения выглядят значительно более гладко, чем результат работы метода ближайшего соседа.

Кубическая интерполяция

Одна из самых распространённых технологий — кубическая интерполяция. Этот алгоритм достраивает недостающие точки, сверяясь с информацией уже не о четырёх, а о шестнадцати окружающих каждую из них пикселях.

Поскольку точки находятся на разных расстояниях от неизвестного пикселя, ближайшие получают при расчёте больший вес. С помощью кубической интерполяции можно получить намного более чёткие изображения. Этот метод долго считался оптимальным и, например, является стандартным способом масштабирования изображений в Adobe Photoshop.

Существует ещё большое количество различных алгоритмов: аффинные преобразования, свёрточные функции и так далее. Сегодня мы не будем останавливаться на них подробно — общая суть и так ясна.

Качество изображения на выходе простых алгоритмов интерполяции всё равно не подойдёт для преобразования Full HD-контента в приятный глазу 4K или тем более 8K. Как же добиться нужного результата?

Революция искусственного интеллекта в апскейлинге

Здесь на выручку приходят наши старые друзья: машинное обучение и искусственный интеллект.

Продвинутые современные телевизоры и некоторые ТВ-приставки предлагают умный апскейлинг изображения. По своей сути это тоже алгоритмы интерполяции — они тоже дорисовывают недостающие части изображений, угадывая их по известным. С тем лишь отличием, что нейросеть дополнительно ищет на каждом кадре знакомые формы, объекты и текстуры: например, лица людей, траву, деревья или машины.

Как работают умные алгоритмы

Вернёмся к нашему примеру, когда мы угадывали температуру по известным значениям. В 10:00 температура за окном составляла 20°C, а в 12:00 она была уже 30°C. Сколько градусов было в 11:00 утра?

Рассматривая предыдущие алгоритмы, мы использовали эти известные нам данные. Умный алгоритм будет работать иначе — он будет использовать более широкий набор информации:

  • Как обычно меняется температура в это время
  • Насколько тепло было в соседнем городе
  • Сколько градусов было в 11 часа утра вчера

Согласитесь, точность такого алгоритма должна быть гораздо выше.

Преимущества ИИ-апскейлинга

Рост популярности искусственного интеллекта и машинного обучения произвёл большую революцию в области масштабирования видео. Эти технологии обладают способностью анализировать и учиться на огромных объёмах данных, что позволяет им делать высокоточные прогнозы о том, как масштабировать видео.

Алгоритмы искусственного интеллекта и машинного обучения могут:

  • Анализировать шаблоны и текстуры видео
  • Использовать эту информацию для генерации дополнительных пикселей
  • Улучшать разрешение видео с высокой детализацией

Это приводит к тому, что на выходе получается гораздо более детализированное и реалистичное изображение, чем могут достичь традиционные методы масштабирования. Кроме того, поскольку эти алгоритмы продолжают учиться и улучшаться со временем, качество апскейлинга видео также улучшается.

Обучение алгоритмов апскейлинга

Как обучают алгоритмы повышения разрешения? Обычно специалисты берут фрагмент нужного разрешения — например, видео в нативном 4K или 8K. Далее происходит нечто удивительное и неожиданное: разработчики искусственно снижают качество видео и уменьшают его разрешение до HD или Full HD.

Зачем портить качество?

Хоть это сперва и кажется парадоксальным, на самом деле всё просто. Таким образом формируется датасет из пар аналогичных по содержанию изображений, но отличающихся по качеству:

  • Первое — искажённая картинка в плохом качестве и низком разрешении
  • Второе — она же, но уже в оригинальном супер-качестве и 4K

На этих парах алгоритм и обучается. Он изучает различия между картинками из каждой пары и пытается понять, какими преобразованиями можно сделать из первой картинки вторую.

Для качественного обучения нужны тысячи, десятки и даже сотни тысяч таких пар. Если проще: алгоритм учится заполнять недостающую информацию в предоставленных ему изображениях с низким разрешением, а делает он это на основе исходных изображений с высоким разрешением. Таким образом он добавляет реалистичные детали, которых никогда не было.

Алгоритм экстраполирует детали изображения, полагаясь на технологии глубокого обучения искусственного интеллекта, и за счёт этого обеспечивается высокое качество и чёткая детализация картинки на выходе.

Оценка качества апскейлинга

Алгоритмов апскейлинга с помощью ИИ существует огромное множество. Сравнение результатов и качества их работы — серьёзная задача для исследователей. Ведь оценить качество видео довольно трудно, поскольку это эмпирический параметр.

Сравнивают различные методы апскейлинга обычно при помощи специальных метрик. Вот самые популярные из них:

  • PSNR (пиковое отношение сигнал/шум)
  • SSIM (метод сравнения структурного сходства)
  • LPIPS — метрика, использующая глубокие признаки различных нейронных сетей

Сейчас между разработчиками алгоритмов из разных стран ведётся ожесточённая гонка за звание лучшего апскейлера в мире. Разработчики регулярно выпускают обновления алгоритмов, а исследователи и простые пользователи сравнивают их и делают выводы о том, какой из алгоритмов лучше.

Качество на выходе поражает. Да, видео не лишены артефактов, но общее качество заметно улучшается. Применение технологии апскейлинга позволяет насладиться любым контентом в высоком качестве в разрешении 4K и 8K, даже если исходный видеоряд был в низком разрешении или снят очень давно.

Современные телевизоры и технология Neo QLED

Чтобы получить хорошее изображение на телевизоре, конечно, нужен классный, яркий и качественный экран. По-настоящему насладиться картинкой получается только тогда, когда алгоритмы апскейлинга и улучшения качества работают в паре с хорошим экраном и качественной матрицей.

Технология Neo QLED

Одна из передовых технологий при производстве экранов — Neo QLED. Neo QLED отличается от уже привычного нам QLED тем, что в таких экранах используется другой тип подсветки. Для этого специально разработаны новые светодиоды Quantum Mini LED, которые в 40 раз меньше стандартных.

В результате получается, что на ту же самую площадь дисплея можно поместить значительно большее количество светодиодов. Это позволяет:

  • Значительно повысить контрастность и яркость изображения
  • Расширить цветовой охват
  • Уменьшить время отклика картинки

Эксперимент: нативное 4K против апскейлинга

Видео в ультравысоком разрешении фактически бывает двух видов:

  1. Изображение в нативном 4K или 8K разрешении, которое изначально было снято или отрендерено в таком качестве
  2. Видео, которое было искусственно увеличено до уровня Ultra HD.

Как вы думаете, смогли бы вы отличить видео в нативном 4K или 8K от видео, которое прошло алгоритмы апскейлинга?

Результаты слепого тестирования

В одном из онлайн-кинотеатров провели слепое тестирование. Оно было направлено на то, чтобы проверить, смогут ли случайные зрители отличить видео в оригинальном 4K от видео, которое прошло апскейлинг до 4K.

Как проходил тест:

  1. Специалисты взяли видео в нативном разрешении 4K
  2. Затем ухудшили его качество до 1080p
  3. Потом снова повысили его до 4K, используя алгоритмы апскейлинга
  4. Полученное видео вперемешку с исходными 4K-фрагментами показали 300 людям

Результаты вас удивят:

  • Истинный 4K смогли определить только те люди, которые профессионально занимаются производством видеоконтента, графикой, монтажом и съёмкой
  • Остальные участники эксперимента разделились поровну: кому-то больше понравился исходник, кому-то результат апскейлинга
  • Абсолютное большинство поставили высокую оценку качеству видео и сказали, что не заметили в показанных роликах никаких значительных графических дефектов или шумов

Это означает, что применение технологии апскейлинга достигла своей цели — качество работы технологии не вызывает никаких вопросов.

Дополнительные технологии улучшения изображения

Кроме улучшения разрешения изображения, в современных апскейлерах используется ещё целый ряд алгоритмов для улучшения качества картинки.

Motion Smoothing (сглаживание движения)

Алгоритмы удаления смазывания изображения в движении. Разные производители по-разному называют эти технологии, но основные принципы работы у них схожи.

Необходимость применения таких алгоритмов обусловлена тем, что видео может иметь частоту 24, 30 или 60 кадров в секунду в зависимости от источника, а телевизоры в свою очередь обладают частотой обновления экранов в 50, 60 и 120 Гц. Чтобы устранить несоответствие частоты обновления экрана и источника видео, как раз и применяется технология Motion Smoothing.

Существует несколько разновидностей этого алгоритма:

Black Frame Insertion (BFI)

Метод состоит в добавлении в видеоряд промежуточных кадров с чёрным фоном. Это позволяет подтянуть частоту и уменьшает эффект размытия. Однако изображение становится менее ярким из-за мелькания чёрных кадров.

Дублирование

Алгоритм подразумевает вставку повторов вместо недостающих кадров. Это также позволяет добиться улучшения плавности изображения в определённых сценах.

Интерполяция

Алгоритм анализирует два соседних кадра и формирует на их основе промежуточный. Это самый продвинутый метод улучшения плавности изображения. Технологии этого вида рекомендуют использовать при просмотре динамичных сцен вроде трансляции спортивных событий.

Шумоподавление

Во многих современных телевизорах есть функция шумоподавления. Алгоритмы удаления шумов позволяют заметно улучшить восприятие видеороликов в низком качестве. Такие алгоритмы ищут шумовые пиксели на картинке, отличая пиксели в одинаковых позициях в разных кадрах видеоряда, и таким образом вычисляют шумы.

Ограничения технологии апскейлинга

Дорогие профессиональные камеры больше не нужны? Можно снимать видео на любительскую камеру, прогонять его через апскейлер и улучшайзер, а на выходе получать супер-качество? Конечно, нет. Ведь у технологии есть ряд ограничений.

К сожалению, например, невозможно увеличить изображение из трёх смазанных пикселей и распознать по нему номер машины или лицо преступника, как часто показывают в сериалах или фильмах. То есть алгоритм конечно может дорисовать детали, но совсем не факт, что они будут соответствовать тому, что было на оригинальных кадрах.

Из видео хорошего качества с разрешением 1080p можно без труда сделать 4K. Сложности возникают на этапе работы со старыми фильмами — например, из девяностых годов. Особенно тяжело будет восстановить старое кино, снятое на плохую плёнку и впоследствии оцифрованное.

Это связано с тем, что любой дефект — например, пятно или блик — в искусственном (то есть созданном при помощи апскейлинга) 4K будет преувеличен. Таким образом, кроме того чтобы повысить само разрешение, появляется необходимость искать в кадре дефекты и избавляться от них.

Есть много алгоритмов поиска и классификации дефектов. При обучении моделей для апскейлинга часто используют следующий подход:

  1. На изображение без дефектов наносятся искусственные дефекты
  2. Далее происходит обучение на парах изображений: одно хорошее, второе содержит дефекты
  3. С помощью этого подхода нейросети удаётся эффективно удалять дефекты изображения

Заключение

Качество результатов работы алгоритмов действительно поражает, и это ещё один пример того, как новые технологии не уничтожают и не принижают достижения прошлого, а дают им второе дыхание.

Только представьте, сколько людей смогло действительно насладиться каким-нибудь старым фильмом на большом экране благодаря этой удивительной технологии, не замечая изначально низкого разрешения картинки. Или насколько приятно будет собраться всем вместе и пересмотреть архивное семейное видео, оцифрованное со старой VHS-кассеты, но теперь в высоком разрешении.

Мы выяснили:

  • Каким образом происходит апскейлинг видео
  • Что такое интерполяция и зачем она нужна
  • Как применение ИИ помогло сделать большой скачок в области видеообработки
  • Какие ограничения есть у технологии

Применение технологии апскейлинга позволяет насладиться любым контентом в высоком качестве в разрешении 4K и 8K, даже если исходный видеоряд был в низком разрешении или снят очень давно.

NVIDIA Cosmos: как создать сознание для машин

Узнайте, как NVIDIA Cosmos создаёт мировые модели для ИИ, обучая роботов в симуляциях реальности. Шаг к искусственному сознанию.
Павел Ельцов 15 декабря 2025 в 03:35

ChatGPT и другие языковые модели поражают воображение. Они способны поддерживать беседу, писать код, объяснять квантовую физику. Они знают больше и думают быстрее, чем любой человек. Но при всей этой мощи у них есть одна фундаментальная проблема: они не понимают, как устроен реальный мир.

Они никогда не жили в нём. Не чувствовали тяжесть предметов, тепло и холод, запах дождя. И главное — не понимали последствий своих действий. У них есть знания о мире, но нет опыта жизни в нём.

Именно поэтому появилась идея создания мировой модели — внутреннего представления о физической реальности, которое позволит ИИ не просто знать об этом мире по описанию из интернета, а понимать его на собственном опыте. И возможно, когда такая модель будет создана, ИИ обретёт нечто большее, чем умение писать код и разговаривать. Он обретёт сознание.

Но разве можно создать такую модель? Можно. И этим уже занимается компания NVIDIA и её проект — Cosmos, который был представлен на CES 2025 в начале января и получил крупное обновление в марте 2025 года.

Эмерджентность: может ли неживое стать живым?

Чтобы понять, куда движется NVIDIA, нужно вернуться в 2017 год. Трое инженеров из OpenAI — тогда ещё малоизвестной некоммерческой организации — тренируют очередную языковую модель на отзывах с Amazon. Задача банальная: научить ИИ предсказывать следующий символ в тексте. Ничего необычного.


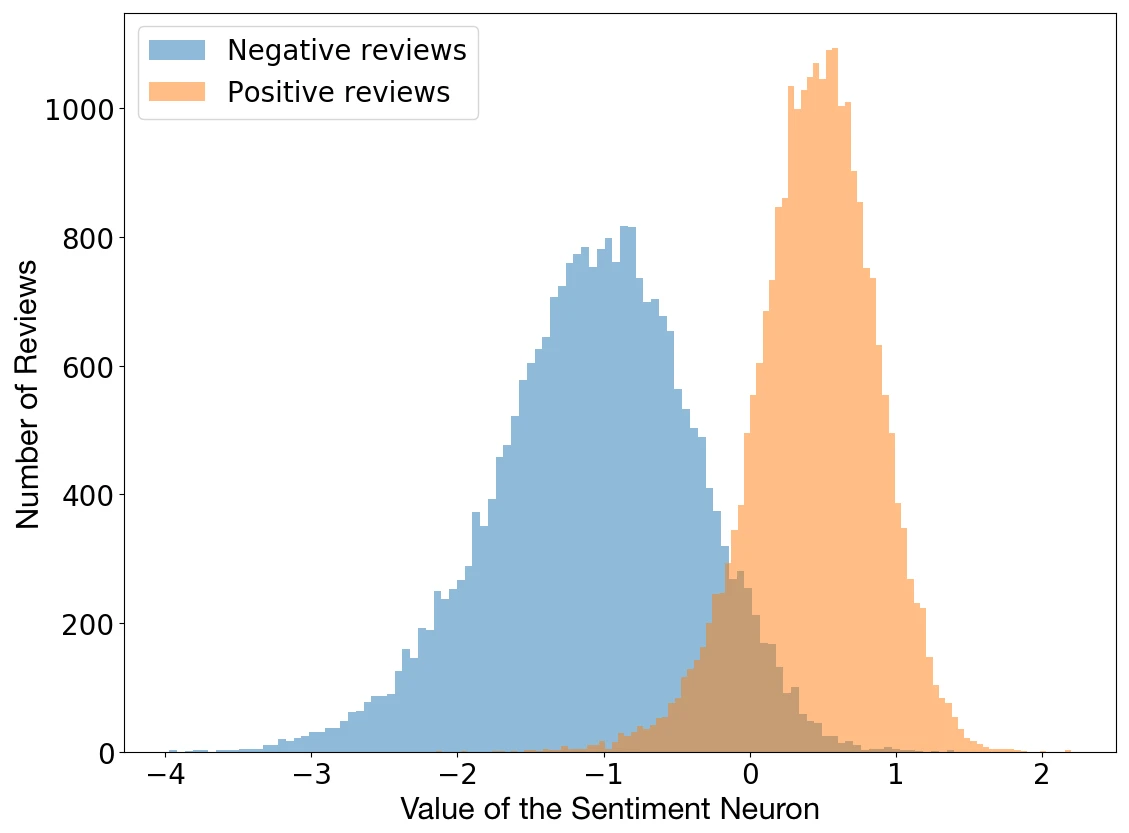
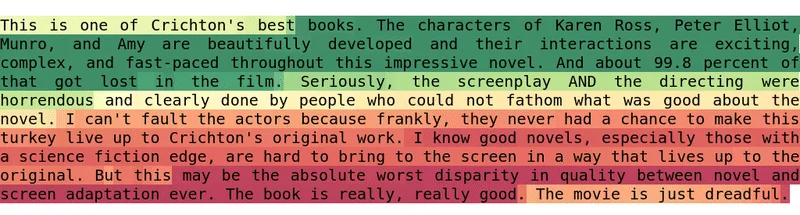
Но вдруг они замечают нечто странное. В процессе обучения модель начинает угадывать не только символы, но и настроение текста. Без какой-либо команды, без дополнительного обучения — внутри неё активируется нейрон, который с пугающей точностью определяет: этот текст позитивный, а этот негативный.
При этом модель понимает не просто эмоциональную окраску каждого отдельного слова, она понимает контекст. Как будто внутри бездушной программы вдруг проснулось нечто большее.

Эта находка потрясает инженеров OpenAI, среди которых был Илья Суцкевер — уроженец Горького (ныне Нижний Новгород), сын советского инженера-физика, сооснователь OpenAI и главный архитектор ChatGPT.

Суцкевер и коллеги начинают изучать этот феномен и копают глубже. Они создают OpenAI Microscope — инструмент, позволяющий заглянуть в глубинные слои нейросетей. И там они находят сокровище — необычные нейроны, которые называют мультимодальными.

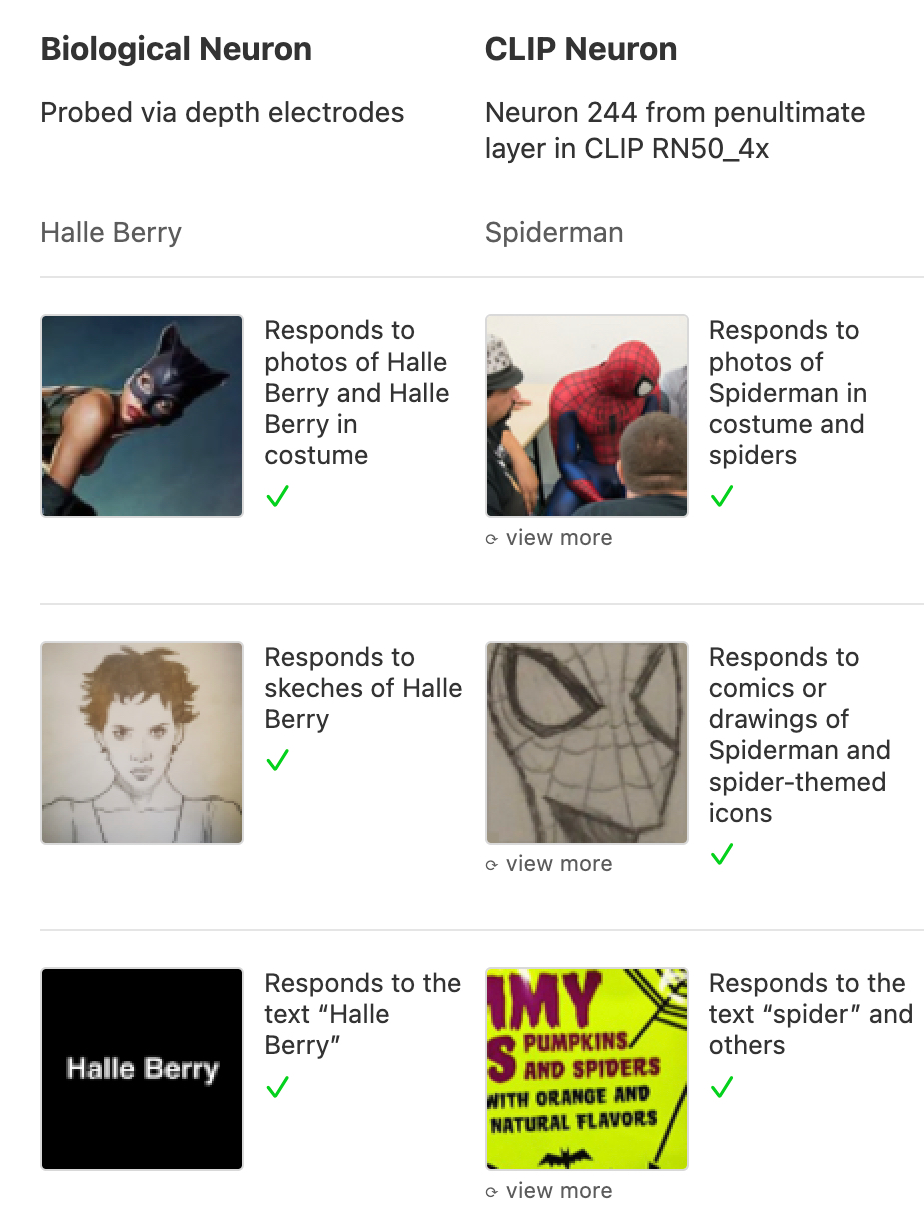
Эти нейроны активируются на данные разного типа. Например, был найден нейрон, который реагировал на фотографии, рисунки и даже просто текст с упоминанием одного и того же понятия. Будто нейросеть без прямого указания сама начинает структурировать реальность, находить в ней закономерности и ассоциации.
В 2021 году при исследовании модели CLIP были обнаружены мультимодальные нейроны, аналогичные знаменитому «нейрону Хэлли Берри», найденному в мозге человека ещё в 2005 году. Этот биологический нейрон активировался при виде фотографий актрисы, рисунков и даже текста с её именем.

И чем больше модель, чем больше данных — тем больше появляется таких нейронов.

Но как такое возможно? В теории систем это называется эмерджентностью — способностью системы порождать свойства, которых нет у её частей по отдельности. От латинского emergent — «возникающий, неожиданно появляющийся». Иными словами, целое больше, чем сумма его частей.

Большое здание складывается из маленьких кирпичей. Живое — из неживых молекул. Но из чего складывается сознание?

Стаи птиц, косяки рыб, муравейники — простые правила взаимодействия отдельных особей без общей цели создают сложное, скоординированное поведение. Система подчиняет себе элементы, из которых состоит.

Один нейрон — это просто переключатель. Но миллиарды, сплетённые в сеть, могут породить нечто большее: субъективный опыт.

В это уверовал Илья Суцкевер. Обнаружив эмерджентные свойства больших языковых моделей, он пришёл к выводу: сознание — это не вопрос магии, это вопрос масштаба. Больше данных, больше параметров, больше вычислений — и больше денег.

Это стало стратегией OpenAI. Десятки миллиардов долларов и гигаватты энергии были сожжены на алтаре искусственного интеллекта с целью масштабировать ChatGPT.

И… это сработало! Успехи больших языковых моделей (LLM) превзошли все ожидания. Примитивный статистический алгоритм, единственная задача которого — предсказывать следующее слово или символ, научился решать задачи уровня олимпиад, писать сложный код, вести осмысленный диалог и даже будто сопереживать.

Но как бы ни впечатлял ChatGPT, это всё ещё не AGI (искусственный общий интеллект). Но что дальше? Продолжать сжигать сотни миллиардов долларов и бить в бубен видеокартами в дата-центрах в надежде, что это пробудит ИИ?

Нет! Так считает Ян Лекун — один из отцов-основателей современного ИИ, лауреат премии Тьюринга 2019 года, создатель свёрточных нейросетей (CNN) и руководитель по развитию искусственного интеллекта в Meta (признана экстремистской организацией и запрещена в России).

По его мнению, дальнейшее масштабирование LLM бессмысленно. Но оно и не понадобится! Ведь следующий прорыв в ИИ произойдёт не там, где его ищет OpenAI. И в этом уверен не только Лекун, но и NVIDIA.

Почему интернета недостаточно

Так что же не так с большими языковыми моделями? На самом деле, всё в порядке. LLM — это потрясающая технология. Просто они достигли предела. Мы уже скормили им весь верхний и нижний интернет: все книги, статьи, GitHub и Stack Overflow, комментарии на Reddit, YouTube, ВКонтакте.

И что мы получили? Огромный архив всех знаний человечества, с которым можно разговаривать! Уже это само по себе чудо! Но этого мало, во всех смыслах.

Во-первых, объём. Да, интернет огромен. Но по сравнению с потоком данных, который обрабатывает человеческий мозг, это капля в море. Только через зрительный канал к четырём годам ребёнок получает больше бит информации, чем содержится во всех текстах, когда-либо написанных людьми.

Во-вторых, природа данных. Реальный мир — это не текст. Читать про езду на велосипеде и кататься на нём — две большие разницы. А LLM живут в мире букв. Но это нереальный мир. Поэтому они не понимают фундаментальных свойств реальности — пространства и времени.

Но что это значит — «понимать пространство и время»? Знать формулы Ньютона и Эйнштейна? Нет! Кошка не знает уравнений, но она просчитывает траекторию своего прыжка лучше любого инженера NASA. То же самое с людьми. Мы интуитивно понимаем, как этот мир устроен, как с ним взаимодействовать, что в нём возможно, а что нет. А нейросети не понимают. Но как мы это делаем?

Мозг как предсказательная машина

Вот тут самое интересное: мы предсказываем будущее! Точнее, это делает наш мозг. Понимание физического мира — это способность предсказывать его следующее состояние.

Поэтому наш мозг постоянно задаётся вопросом: «что будет, если?» Что будет, если столкнуть стакан со стола? Он разобьётся или отскочит? Или, может, зависнет в воздухе? А что будет, если до него дотронуться? Это безопасно? Он горячий или холодный? Чистый или грязный? Гладкий или шершавый?

И мозг делает это непрерывно. Автоматически. Пространство вокруг нас — не декорация. Это огромный поток информации, который необходимо постоянно анализировать. От этого зависит наша жизнь.

Мозг непрерывно сканирует пространство вокруг нас и, объединяя данные со всех сенсоров, строит гипотезы. Поэтому мы чувствуем, где безопасно, а где тревожно. Где можно присесть и расслабиться, а откуда нужно бежать.

Когда предсказание совпадает с реальностью — мы спокойны. Или радуемся, если ожидали что-то приятное. А если не совпадает — удивляемся, пугаемся… или смеёмся.

Да, юмор — это тоже ошибка предсказания, которая не несёт угрозы. Но откуда у людей такие способности? Мы что, от рождения оракулы? Нет. Мы этому учимся.

К девяти-десяти месяцам у ребёнка начинает формироваться устойчивая физическая модель мира. Покажите ребёнку фокус: будто предмет завис в воздухе. Шестимесячный младенец не удивится. А девятимесячный — широко распахнёт глаза.

Почему? С этого возраста внутри каждого из нас уже крутится симулятор реальности. Наша внутренняя матрица, существующая параллельно реальному миру. Наша реконструкция реальности, благодаря которой мы предсказываем, «что будет, если». А ошибки предсказания формируют нашу реакцию на окружающий мир.

Ян Лекун называет такой симулятор мировой моделью. И если мы обучим ИИ строить внутри себя такую модель, как это делает девятимесячный ребёнок, мы сделаем следующий шаг. И возможно, это будет шаг к искусственному сознанию. Но как ИИ обучить мировой модели? Ответ простой: дать ему тело!

Последний пазл: почему сознанию нужно тело

Научная фантастика нас научила: тело без сознания мертво. Но и сознание без тела… вряд ли возможно. И вот почему. Передовые теории сознания и мозга — такие как «Теория глобального рабочего пространства» (Бернард Баарс, Станислас Дехенн), «Теория интеграционной информации» (Джулио Тонони, Кристоф Кох), «Теория предиктивного кодирования» (Карл Фристон) и «Гиперсетевая теория мозга» (Константин Анохин) — несмотря на разные подходы и различия в деталях, сходятся в одном:

Мозг — это гиперсеть. Это сеть сетей, связанных в единую архитектуру. То есть мозг — это не одна нейросеть, а набор разных нейросетей-модулей, непрерывно обменивающихся информацией друг с другом.

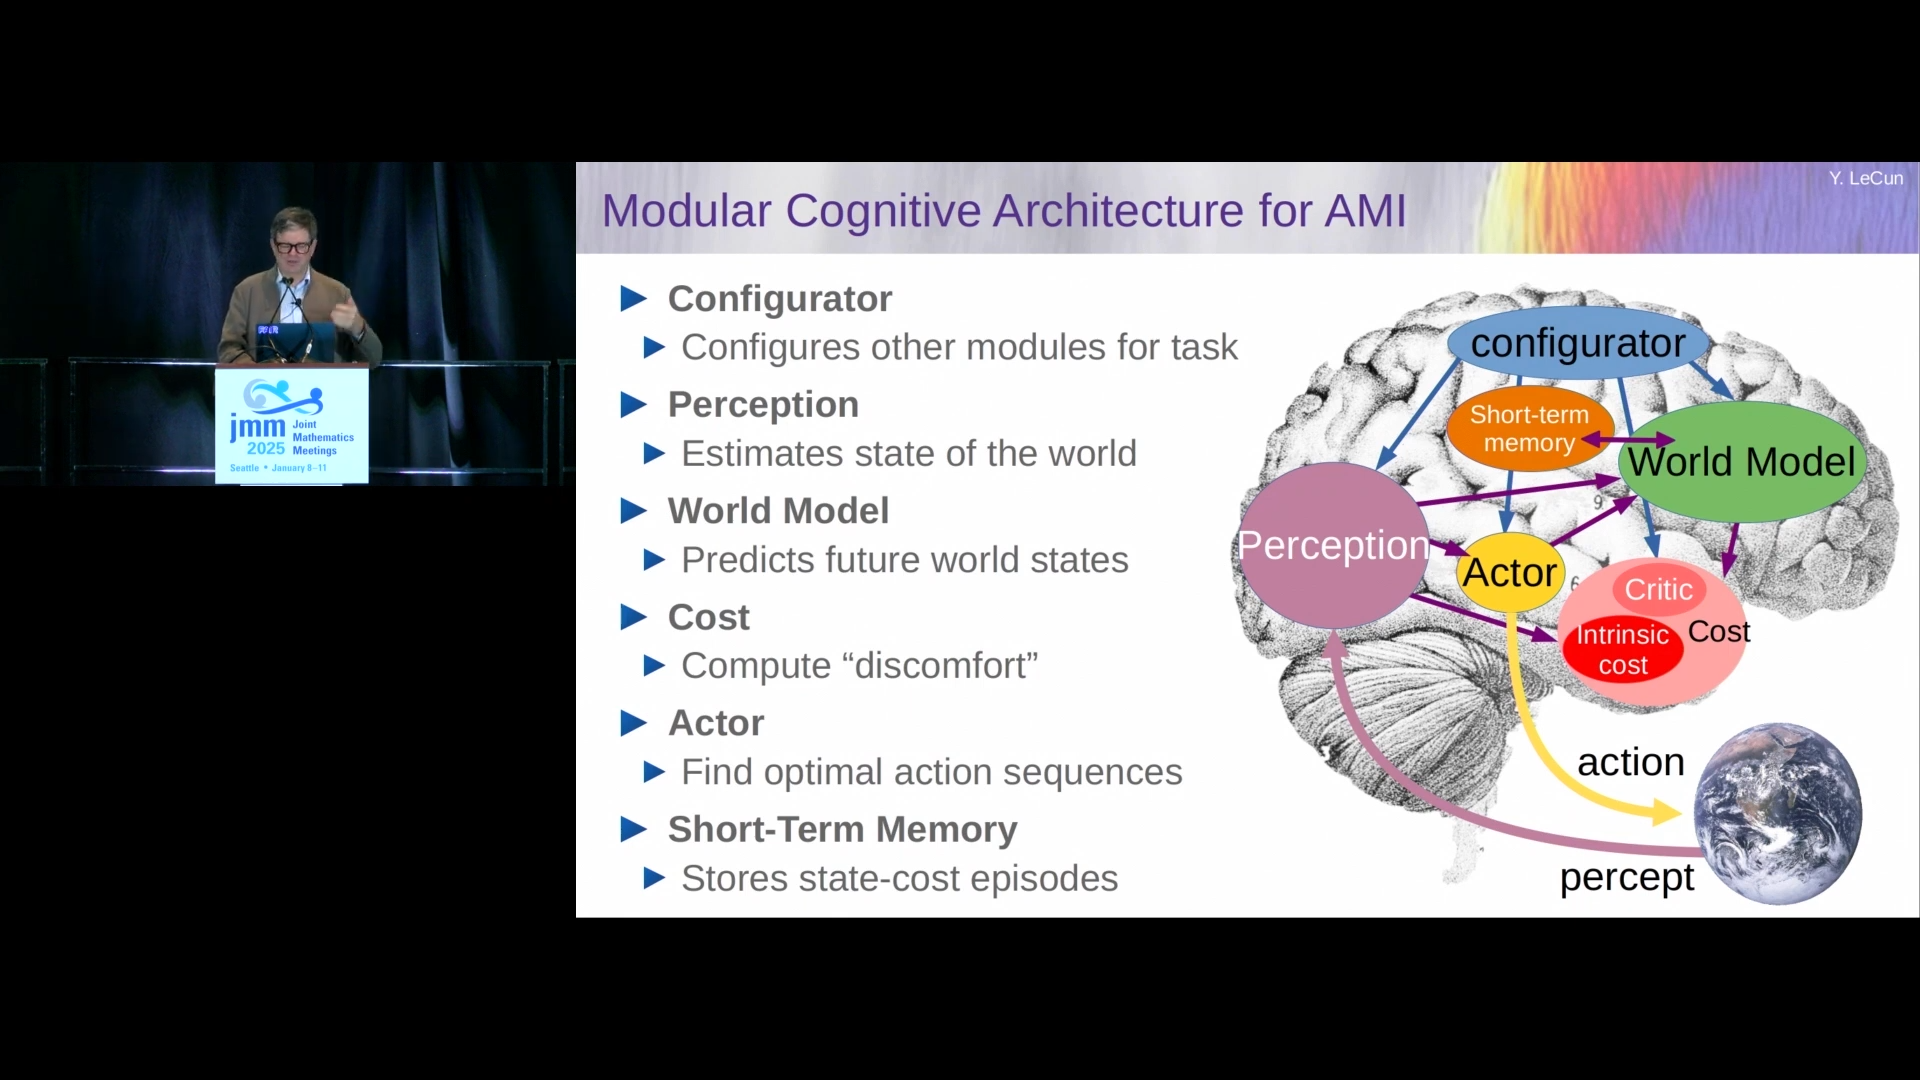
Если собрать такую систему модулей, выстроить связи и иерархии — мы получим искусственный мозг. И мы пугающе близки к этому. Например, в архитектуре искусственного мозга, которую предлагает Ян Лекун, всего шесть модулей:

  • Кратковременная память;
  • Модуль восприятия, который анализирует текущее состояние мира;
  • Мировая модель, предсказывающая, что произойдёт дальше;
  • Модуль мотивации, распределяющий награды и штрафы;
  • Конфигуратор — дирижёр всей системы;
  • Актор — принимает решения и действует.

И все эти модули уже реализованы. Кроме одного: мировой модели. Но когда мировая модель будет готова, ИИ станет автономным агентом, который воспринимает, понимает и действует. И что это, если не разумное существо?

Но обучить реальности — не простая задача. Потому что объективной реальности не существует. Она субъективна!

Реальность — это не фиксированный объект, а процесс восприятия. Каждое существо воспринимает мир по-своему: через свой набор сенсоров, свои цели и, главное, свой личный опыт.

И только построив свою субъективную реальность, ИИ сможет начать понимать нашу. Но тут возникает проблема. Успех всех современных ИИ-моделей обеспечил один фактор: у нас было очень много данных. Залили в ИИ петабайты текстов — получили ChatGPT. Скормили миллионы изображений и видео — получили Midjourney и Sora.

А субъективный опыт? Где его взять? Он не хранится на жёстких дисках. Его нет на YouTube. Его не скачать с торрентов. Тогда что делать? Запустить роботов в реальный мир? Пусть бегают, падают, набивают шишки? Можно. Но это долго, дорого и опасно — как для роботов, так и для людей.

Значит, нужен другой путь — создать симуляцию. Субъективную мультивселенную реальностей. Мир грёз, где время можно ускорить и отмотать назад. Где можно ошибаться, переигрывать, пробовать снова и снова, доводя навыки до совершенства. Где за одну ночь можно прожить тысячи жизней. И такой мир уже создаётся. Он называется NVIDIA Cosmos.

NVIDIA Cosmos — фабрика снов для роботов

Так что же такое NVIDIA Cosmos? Это фабрика по производству снов… для роботов. Звучит фантастически? А между тем, это вполне точное описание. Давайте разберёмся, как учится наш мозг, чтобы понять аналогию.

Ответ — чрезвычайно эффективно! Биологические нейросети, в отличие от искусственных, обладают важным преимуществом — нейропластичностью. Наш мозг не просто запоминает информацию — он буквально меняется на ходу. Подстраивает нейронные связи, адаптируется. Поэтому каждый раз, когда мы ошибаемся и пробуем снова, мы делаем это уже немного другим мозгом. Более эффективным.

Но даже этого недостаточно. Каждый день мы получаем больше информации, чем можем усвоить. Поэтому мозг продолжает обучение во сне.

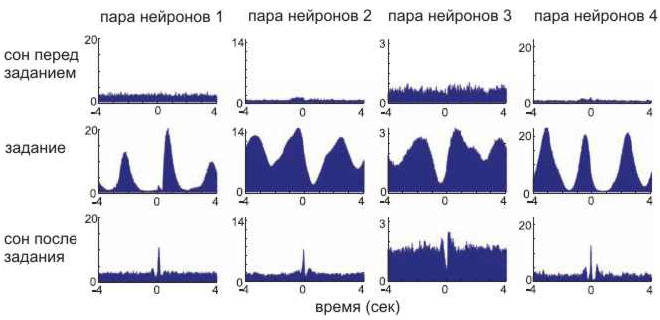
Учёные проводили эксперименты на крысах. Грызуны бегали по лабиринту, а исследователи записывали активность нейронов — днём и ночью. Оказалось, что во сне мозг активирует те же нейроны, что и во время бодрствования, в том же порядке, но ускоренно.

Будто крыса снова и снова пробегает свой маршрут: запоминает повороты, запахи, ощущения — только теперь не в реальности, а в голове.

У людей тоже самое. Когда вы учите новый язык, играете на гитаре, решаете сложную задачу, ваш мозг возвращается к этому во сне. Он «пересобирает» прожитый опыт, укрепляет нужные связи, отбрасывает лишнее. Пробует разные варианты и находит решения, до которых днём не дотянулся.

Сон — это не отдых, это пространство для обучения. Где можно прожить события ещё раз: сказать то, на что не решился, сделать то, что не получалось, преодолеть то, на что не хватало сил. Без риска, без последствий. Ничего не напоминает?

Что для человека сон, для робота — симуляция. А сны — это обучающие материалы, но не универсальные, а сгенерированные специально для конкретной задачи.

Разница лишь в одном: для человека сны создаёт собственный мозг, а для роботов их синтезирует NVIDIA Cosmos. Да, NVIDIA Cosmos — это генератор снов. Система, которая берёт крупицу реального опыта и создаёт горный хребет синтетического.

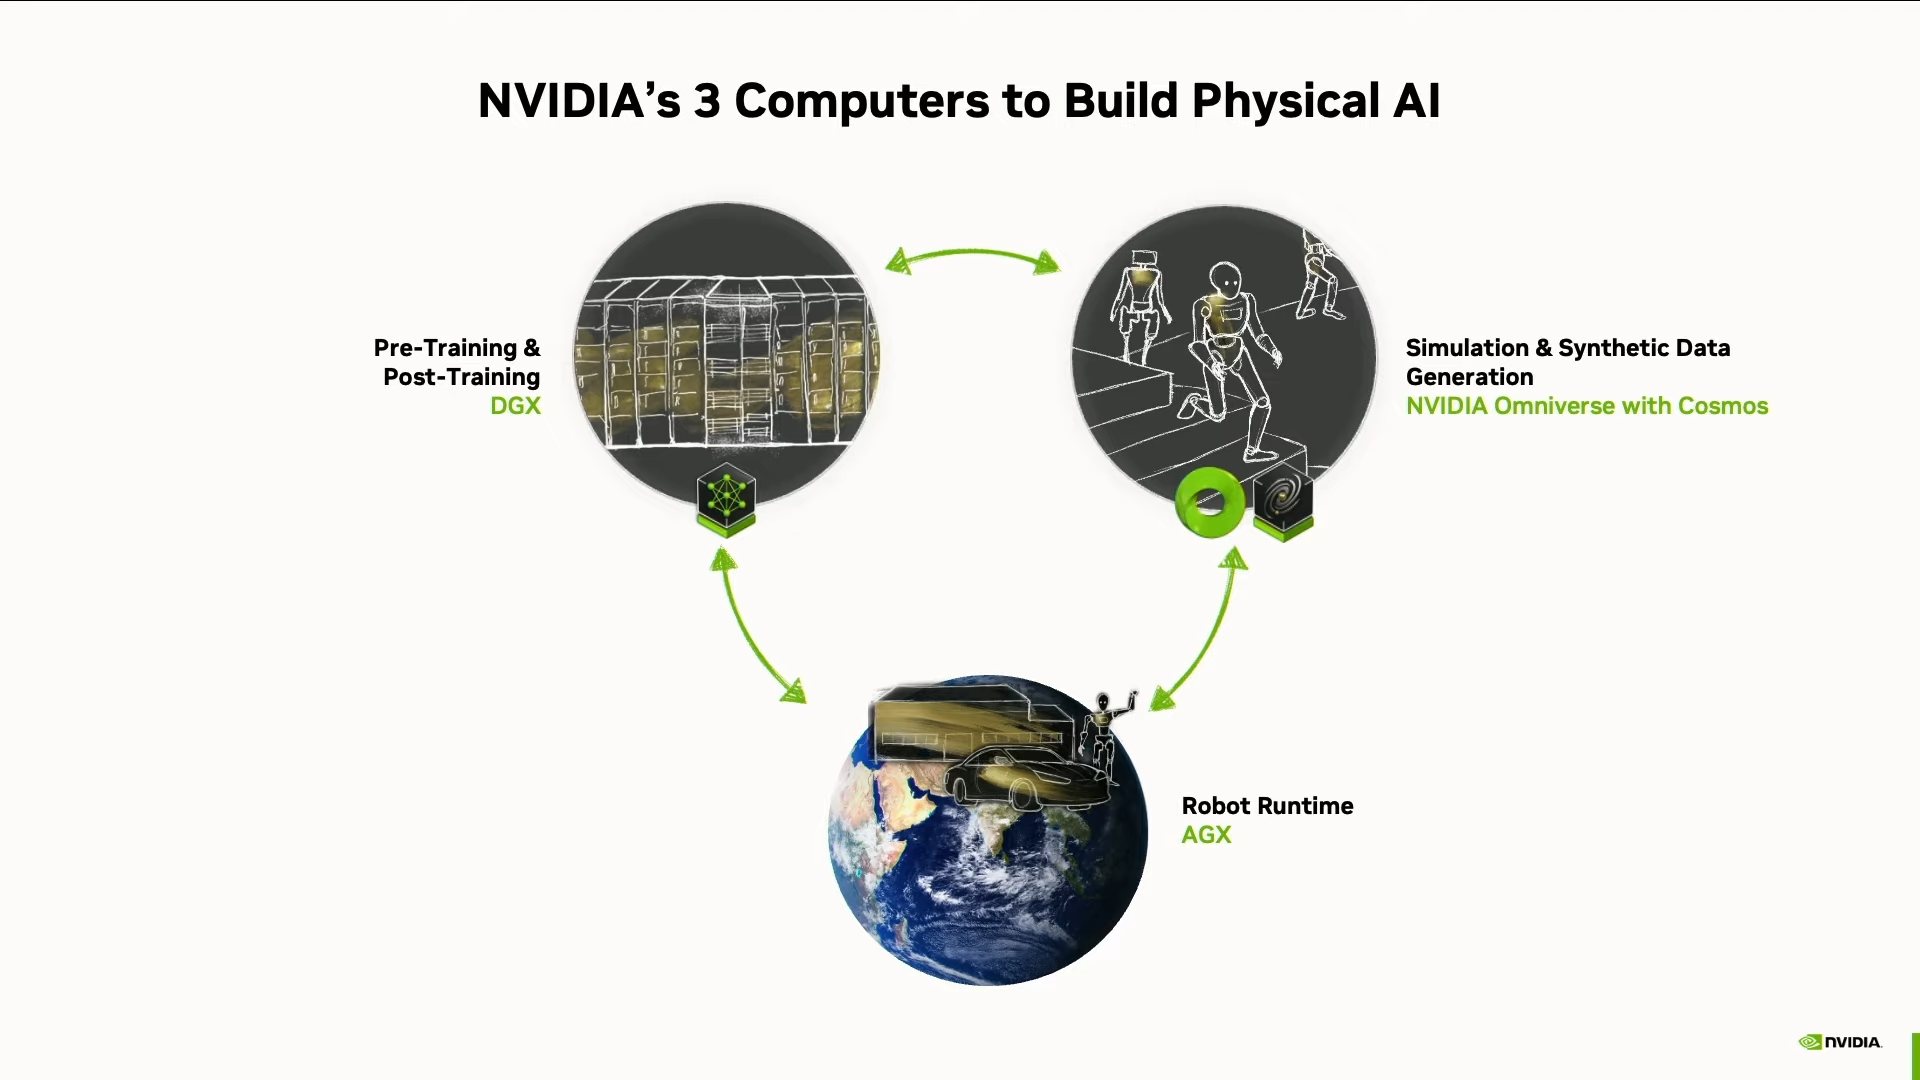
Вот как это работает: Сначала Cosmos генерирует тонны синтетических миров — снов, в которых робот может тренироваться в симуляции. Потом он «просыпается» — выходит в реальный мир. Проверяет, чему научился. Делает ошибки.

Ошибки превращаются в данные. Данные — в опыт. А опыт — в новые сны. И цикл повторяется. Cosmos создаёт тысячи альтернативных сценариев: переигрывает неудачные попытки, предлагает новые решения, показывает другие пути. Но как всё это устроено технически? Вот здесь начинается самое интересное.

Cosmos изнутри

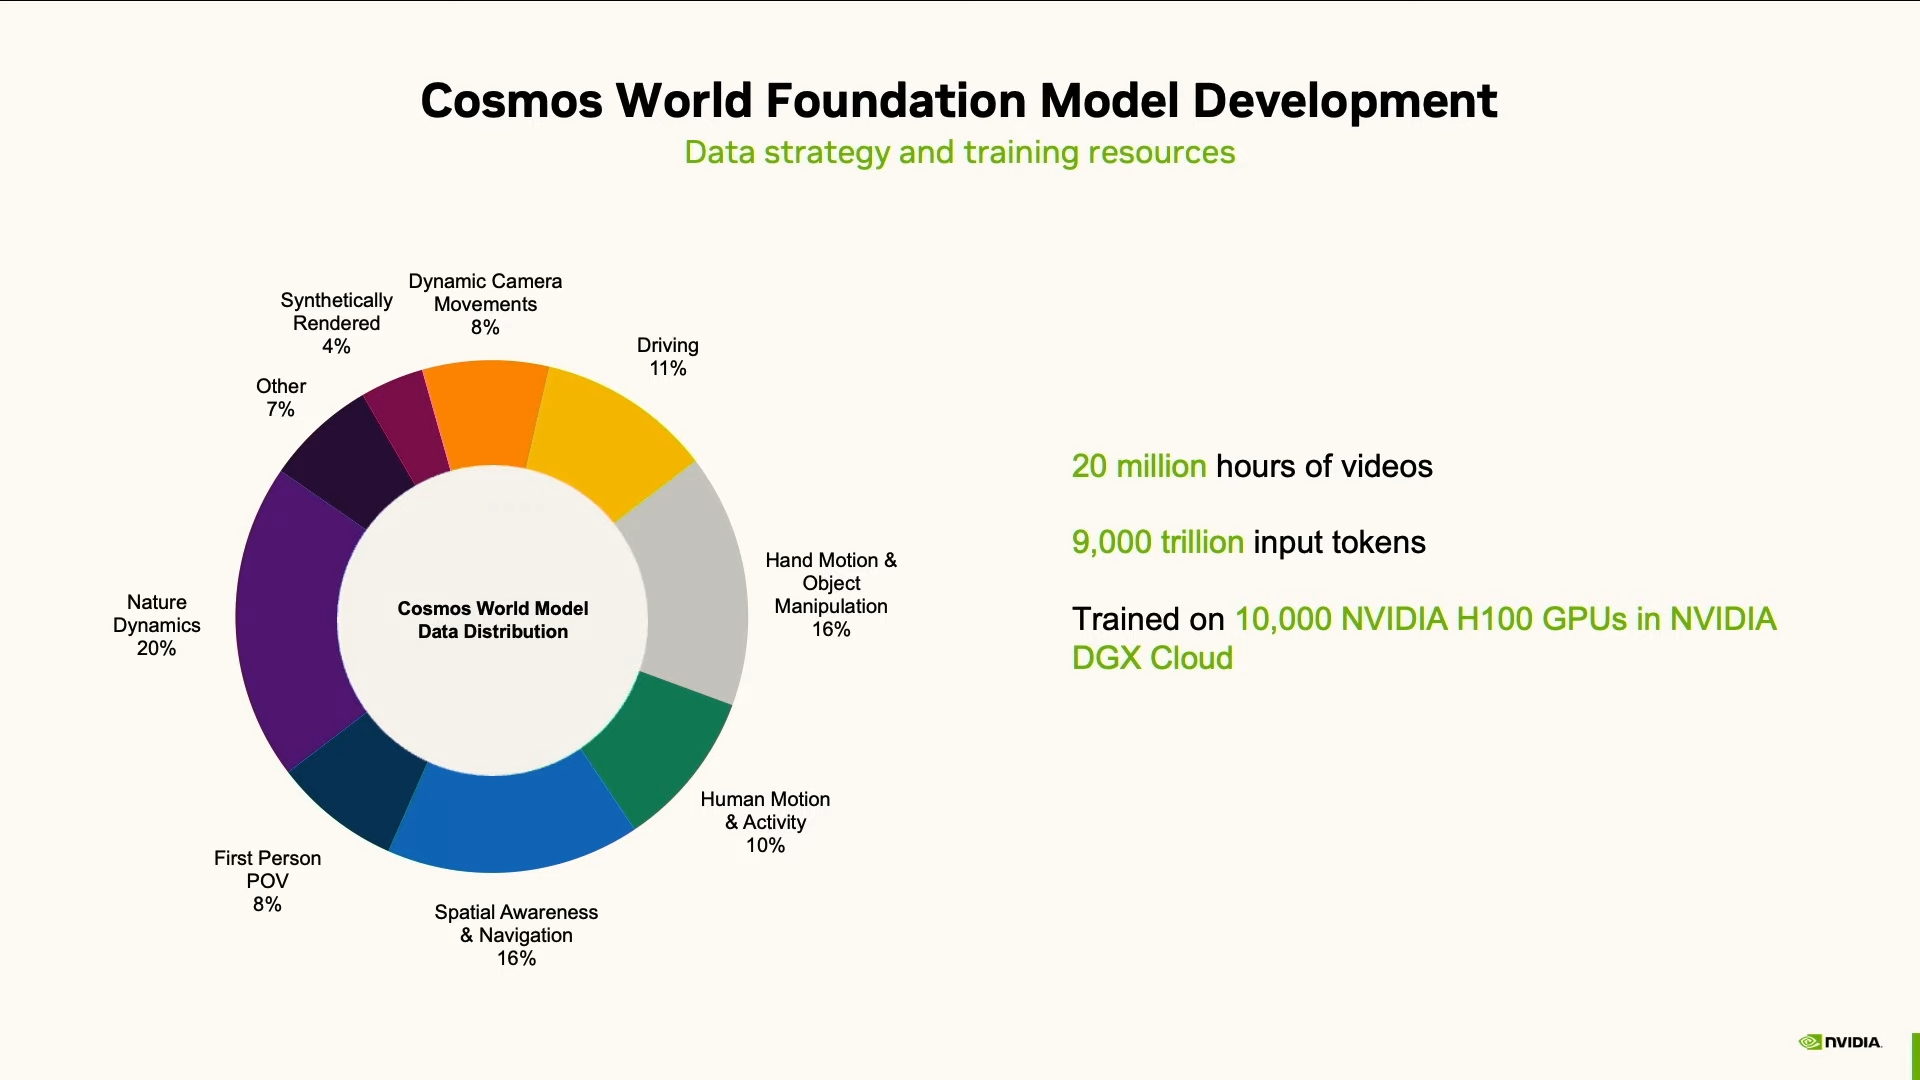
Чтобы создать Cosmos, в NVIDIA начали с самого фундамента — данных. Для начала они собрали гигантский массив видео: с камер роботов, с лидаров автопилотов, записи человеческих движений, манипуляций руками, явлений природы и других процессов из реального мира.

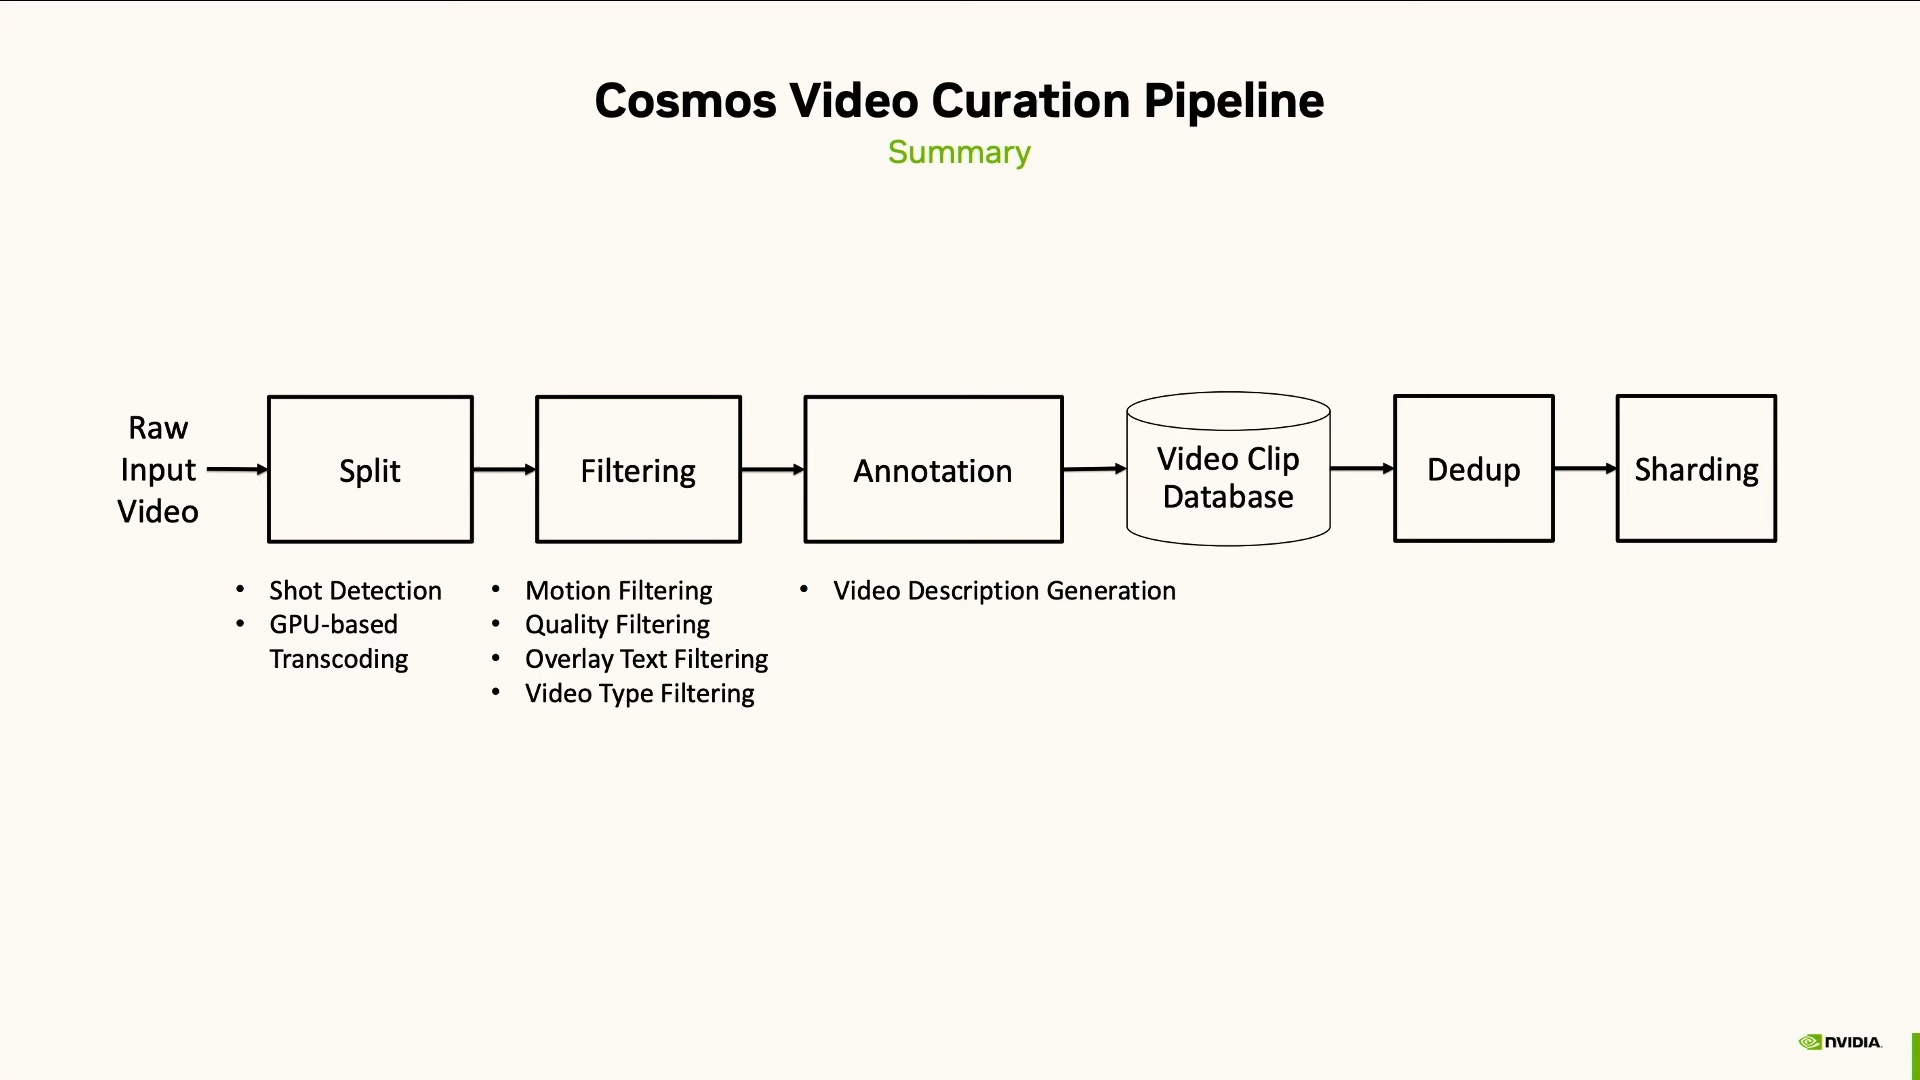
Звучит круто, но сырые данные машине не скормить. Их надо сначала приготовить. Поэтому в NVIDIA построили полноценный конвейер для автоматической обработки, очистки и разметки видеоданных. Видео разбили на фрагменты, вырезали скучное, некачественное и лишнее. Оставшееся разметили, добавили описания, перевели в понятный для машин формат — токенизировали.

Согласно данным, опубликованным NVIDIA в январе 2025 года на CES, модели Cosmos были обучены на 20 миллионах часов видео и 9 триллионах (не миллиардах) токенов. Для обработки такого объёма данных использовались тысячи видеокарт H100, а на платформе Blackwell эта задача может быть выполнена за 14 дней.

В результате получили ключевой компонент NVIDIA Cosmos: базовые мировые модели, или World Foundation Models (WFMs). Что это такое? Важно сразу уточнить: WFM — это ещё не сама мировая модель, это строительный материал. Фундамент, на котором можно построить мировую модель или, как говорят в NVIDIA, создать «физический ИИ».

WFM — это генераторы снов. Набор нейросетей, которые генерируют видео. Прямо как SORA или Runway, но с важным отличием: они заточены не на красивую картинку, а на физику и субъективный взгляд.

То есть, по сути, WFM генерируют мир глазами роботов. Они создают POV (point of view — «точка зрения»), где вы:

  • робот-погрузчик в логистическом центре,
  • кибертакси с шестью камерами и лидаром,
  • гуманоид, который ставит чашку в посудомоечную машину.

NVIDIA анонсировала первую версию Cosmos на CES 2025 (6 января 2025 года), а в марте 2025 года на конференции GTC представила крупное обновление с новыми моделями и инструментами. Все модели доступны под открытой лицензией на платформах Hugging Face, NVIDIA NGC и GitHub.

Три типа моделей Cosmos

На сегодняшний день у Cosmos три типа моделей.

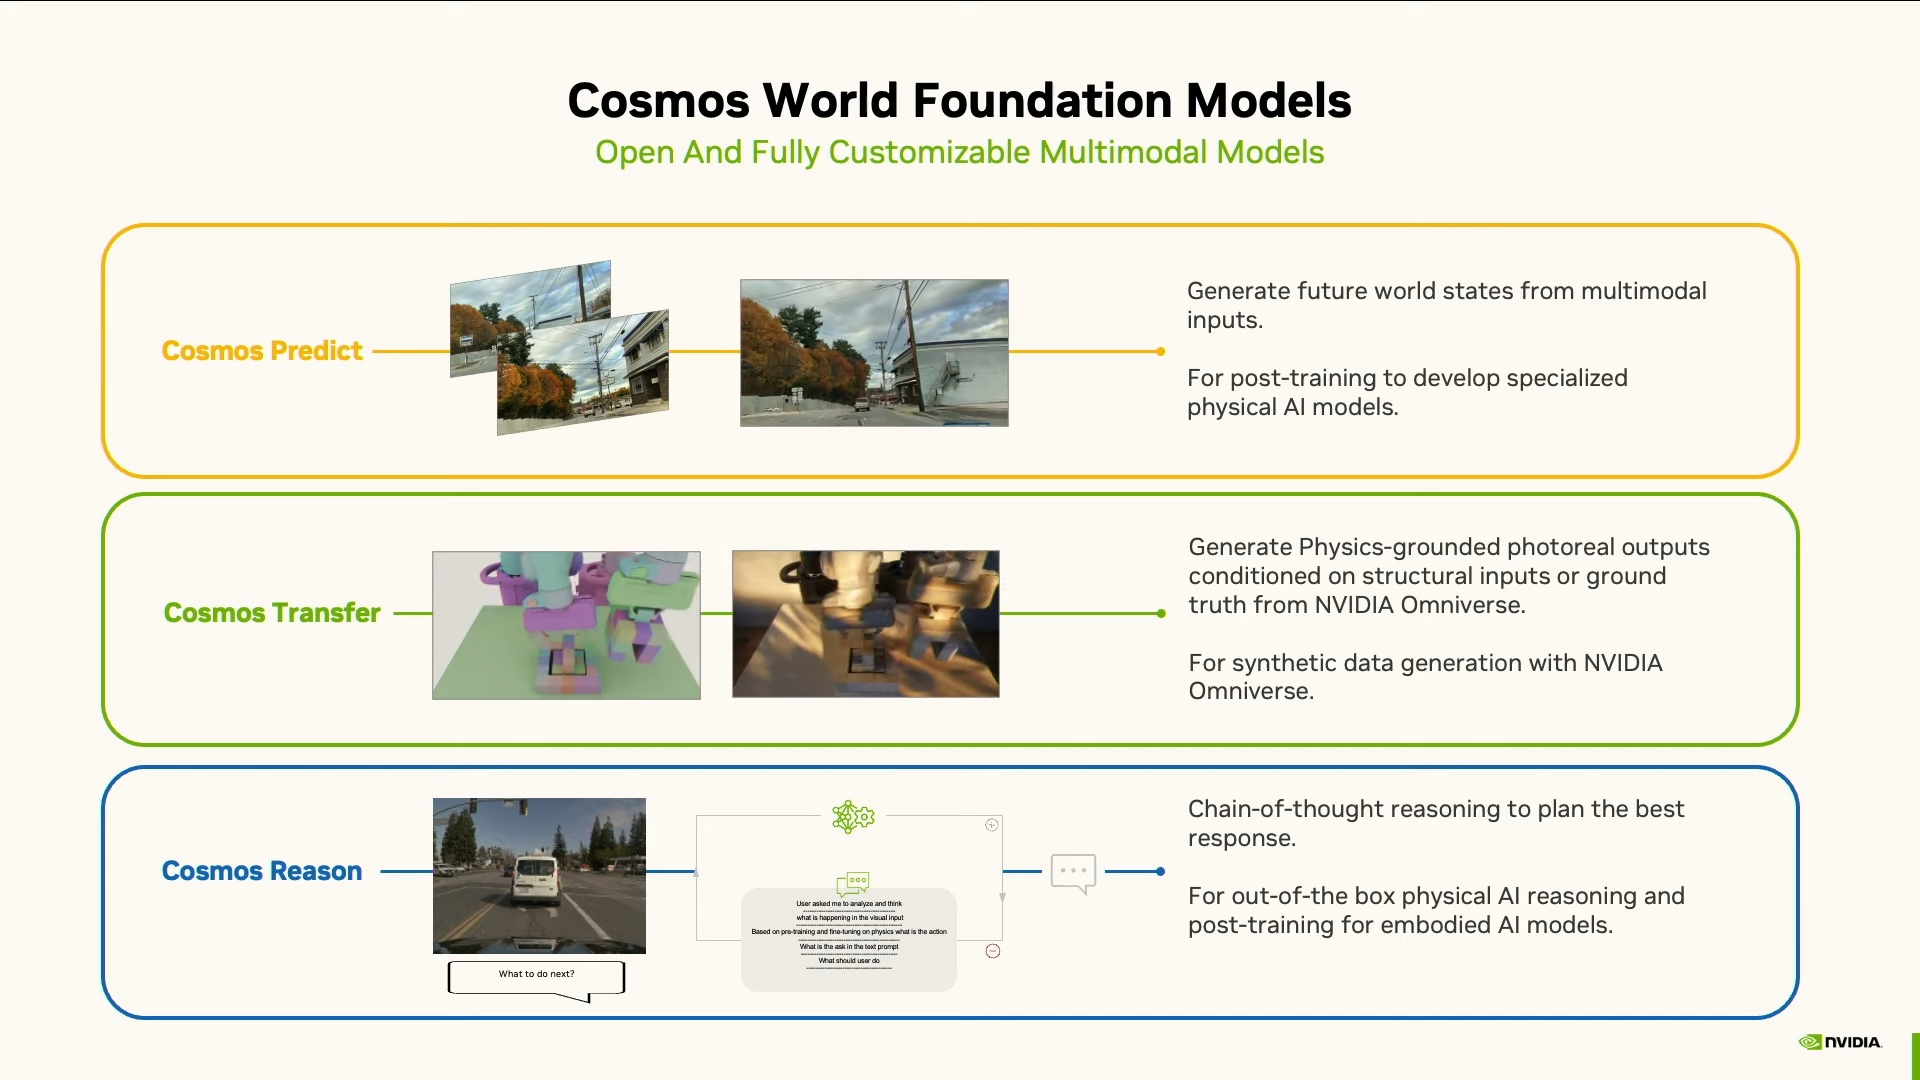
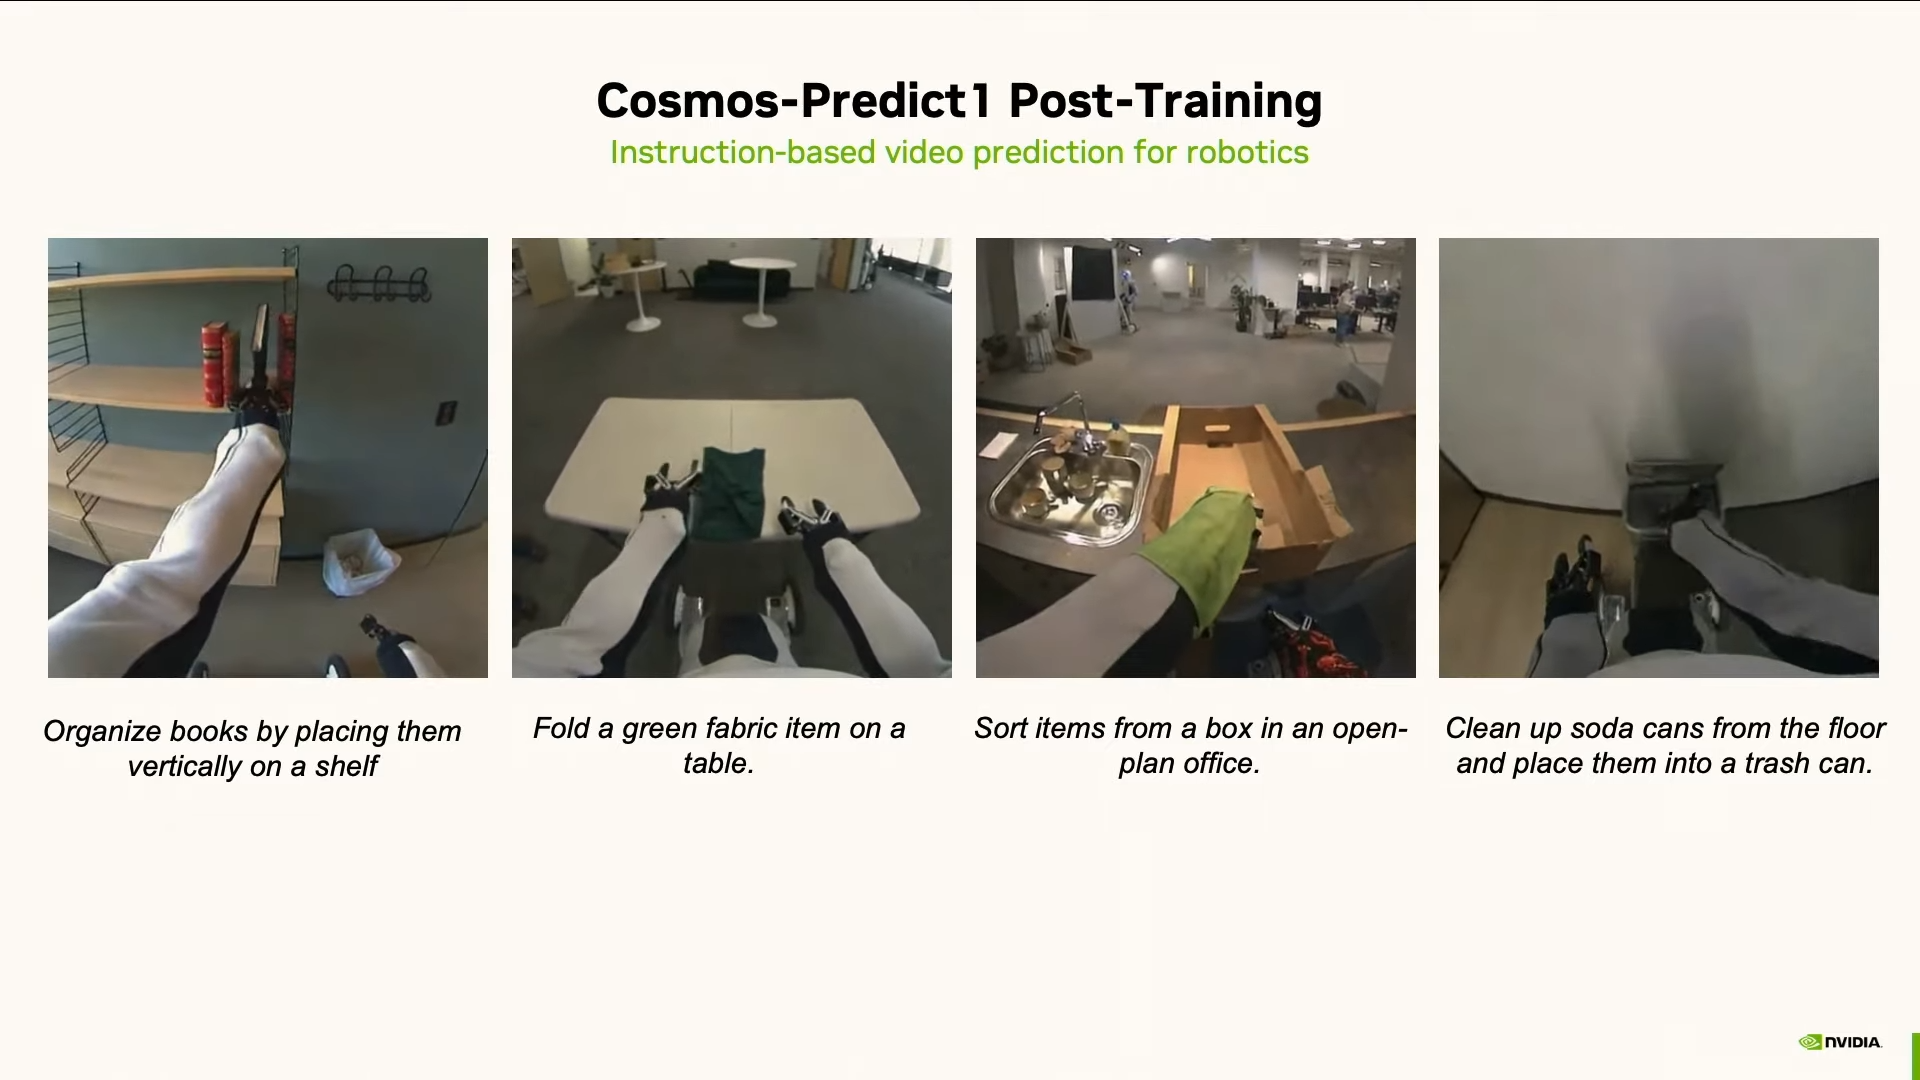
Cosmos Predict. Это модель, которая предсказывает, как изменится мир. Она берёт мультимодальный ввод — видео, текст, траекторию движения, сенсорные данные — и генерирует, что будет дальше. Проще говоря, если дать ей кадры видео и задачу вроде «поставь чашку на полку», она покажет, как именно это должно произойти — с правильной траекторией и корректной физикой.

Cosmos Predict — это сценарист снов. Он позволяет переиграть уже прожитый опыт разными способами. Например, если андроид во время испытания не смог поставить книжку на полку, сложить полотенце, сортировать посуду или выкинуть мусор — не беда! Cosmos Predict позволит переиграть эти воспоминания и сгенерировать образцовые материалы для обучения.

Или, скажем, автопилот. Cosmos Predict поможет сгенерировать разные дорожные ситуации и траектории движения. Причём не для одной камеры, а сразу для шести. Компании 1X, Nexar и Oxa используют Cosmos Predict для обучения своих гуманоидных роботов и систем автономного вождения.

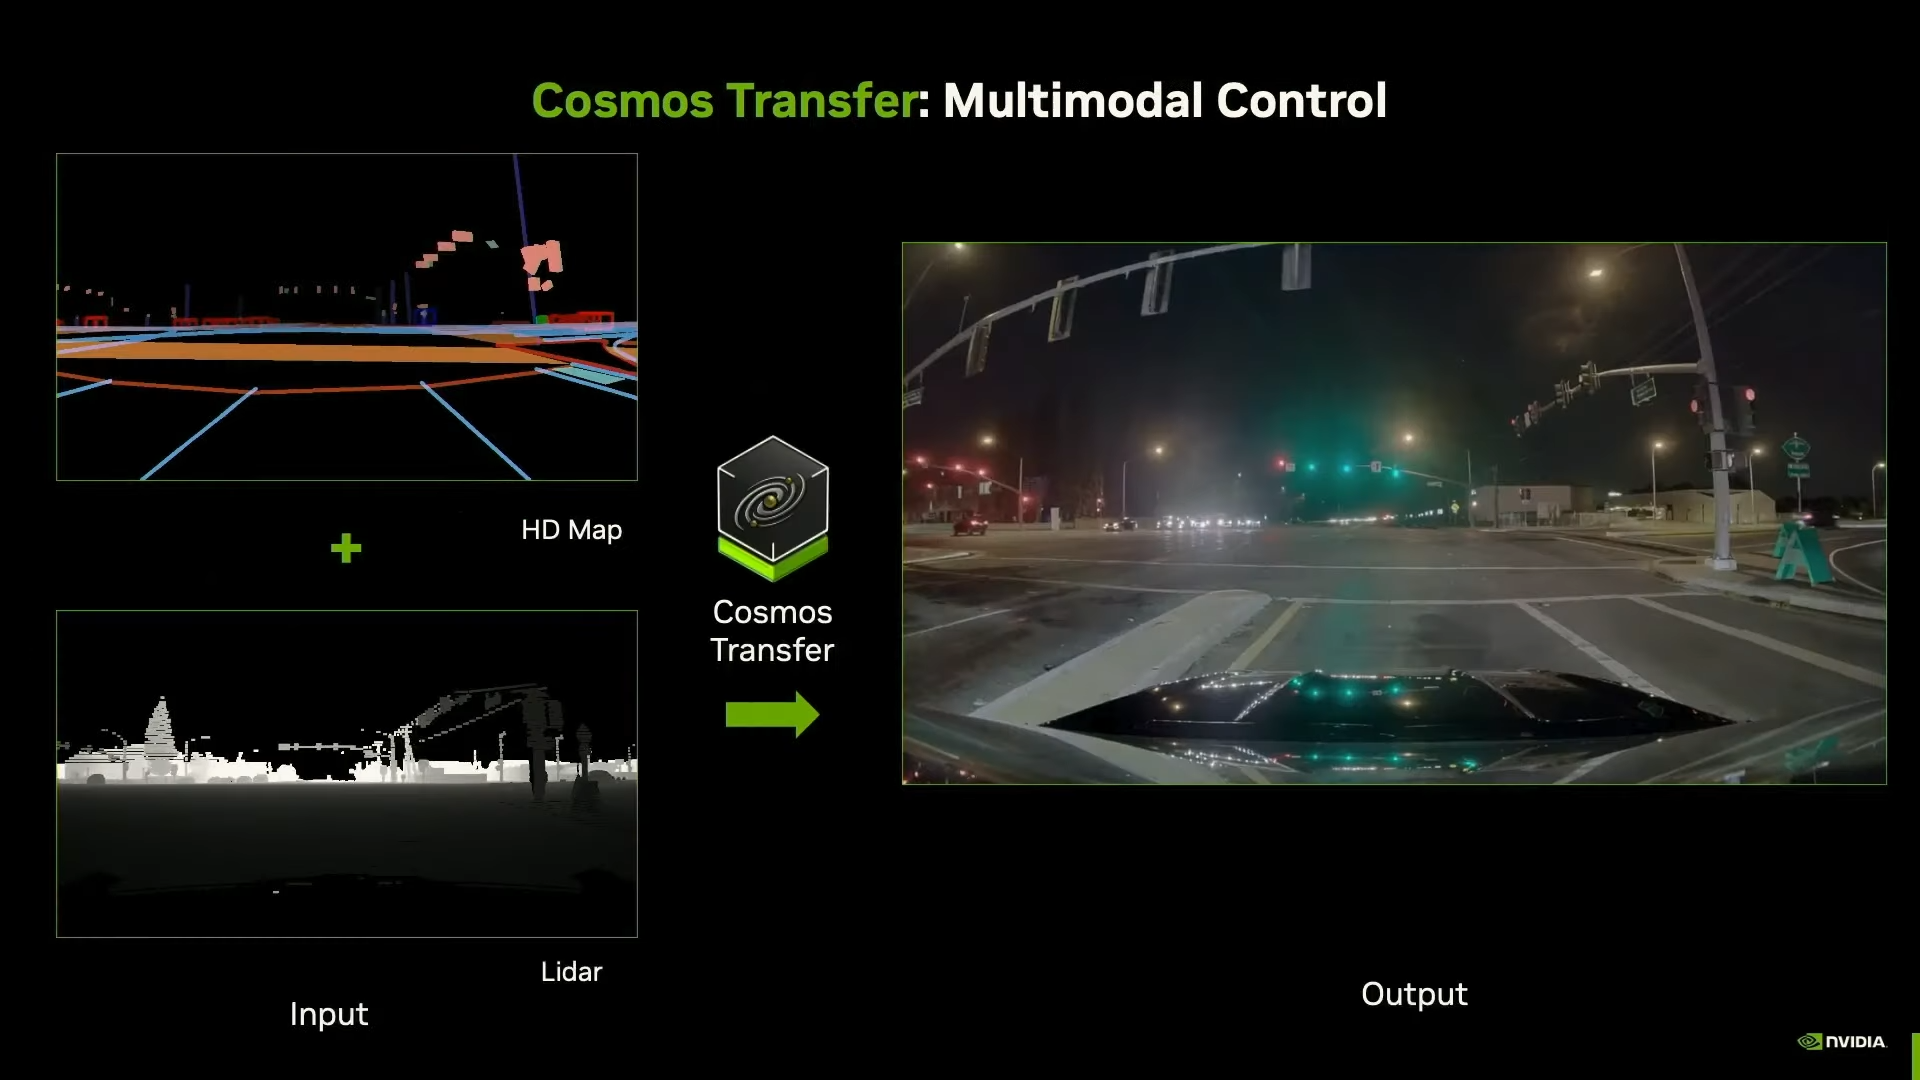
Cosmos Transfer. Если Predict придумывает, что будет, то Transfer отвечает за реализм. Эта модель превращает любые видеоданные в живую картинку. Есть только данные с лидара? Не проблема — Transfer насыпет реализма. Вот тебе: день, ночь, снег, дождь, блики, грязь — сама суровая жизнь во плоти.

Есть размытое видео в 240p? Держи хай-рез вариант, чтобы звенело! Или вообще нет видео? Только 3D-сцена из NVIDIA Omniverse? Не проблема, Transfer накинет текстур и освещения: тысячи вариантов в любых локациях и условиях, да так, что RTX заплачет в сторонке.

Кажется, скоро менять графику в играх будет так же просто, как скин в Counter-Strike. 1X использует Cosmos Transfer для обучения своего нового гуманоидного робота NEO Gamma. Разработчик мозга для роботов Skild AI применяет Cosmos Transfer для расширения синтетических датасетов.

Cosmos Reason. Фантазировать — хорошо. Но иногда нужно подумать, насколько эти фантазии соответствуют реальности. Для этого и существует третья модель. Она была представлена в марте 2025 года на конференции GTC как полностью открытая и настраиваемая модель рассуждения для физического ИИ. Это рассуждающая нейросеть: не та, что поможет решить уравнение или найти баг в коде, она рассуждает о другом — о физической реальности.

У неё две ключевые способности:

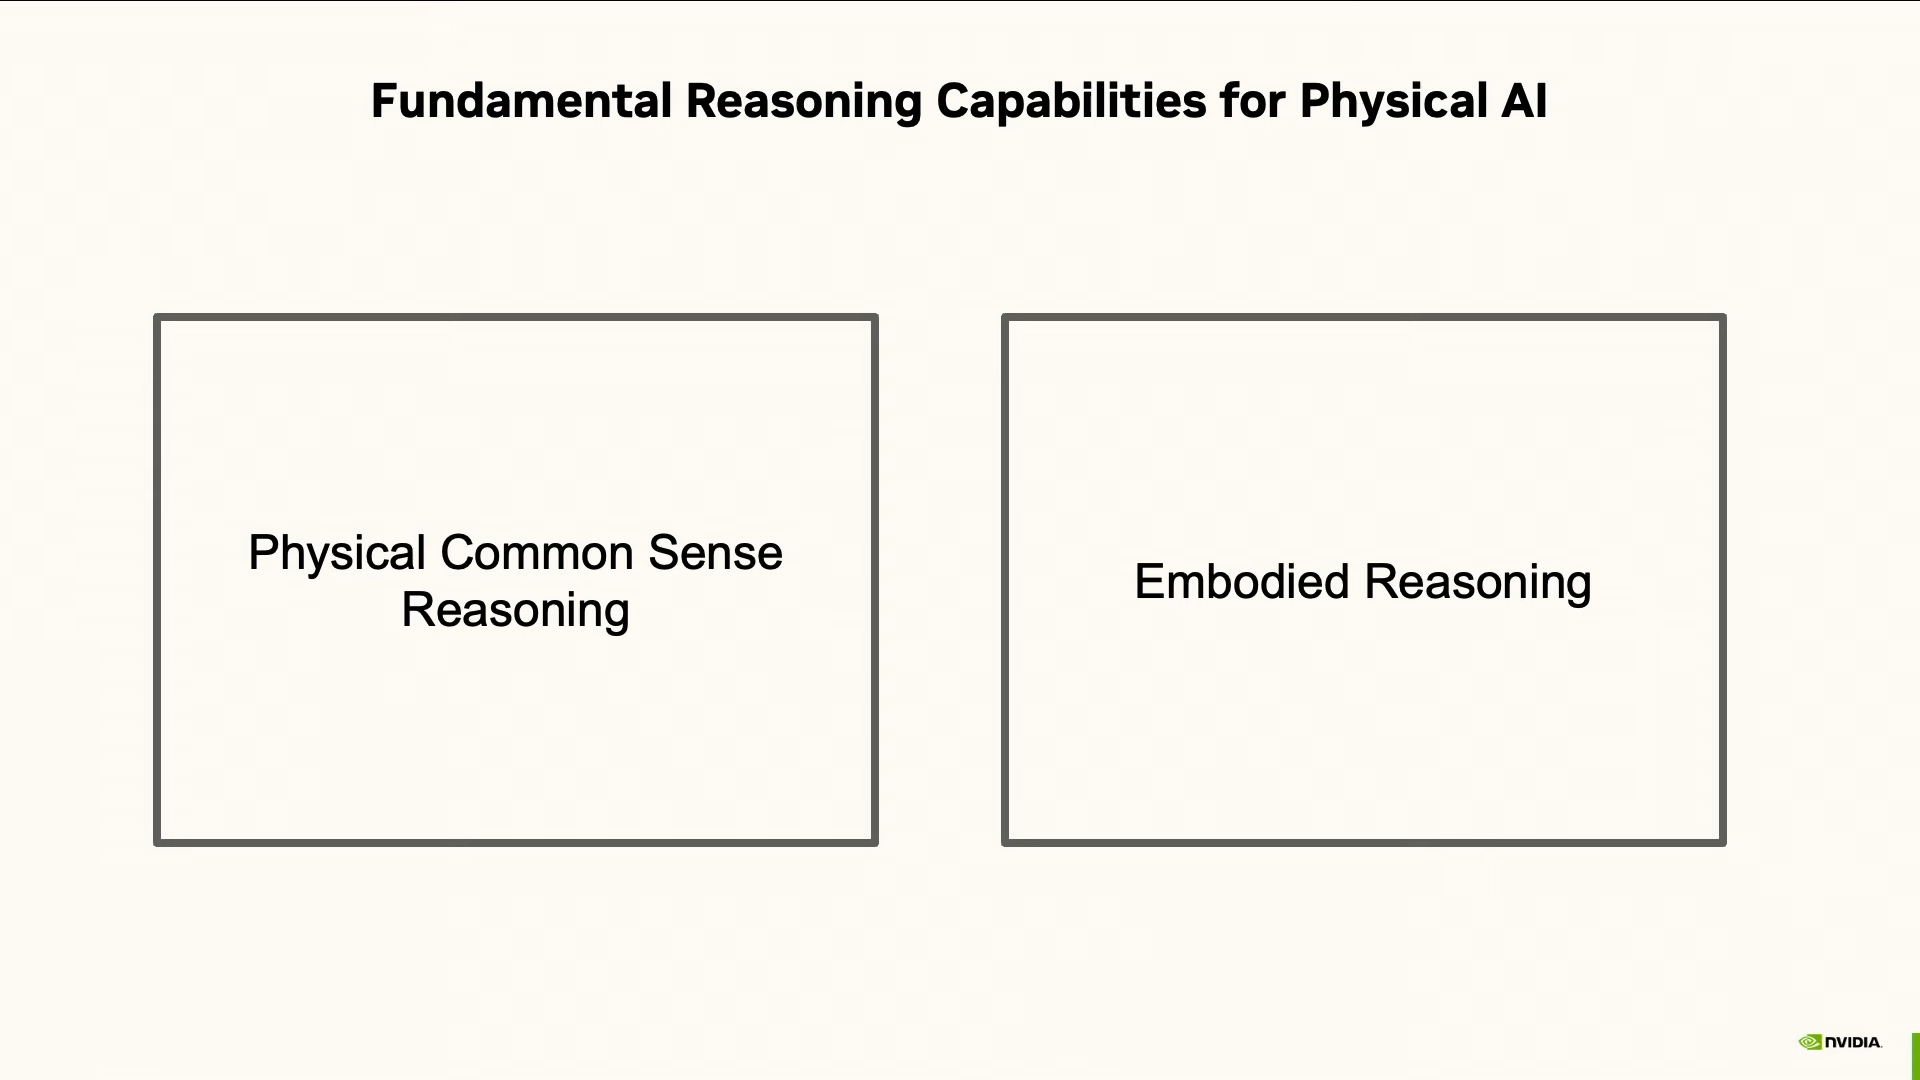
  • Physical Common Sense Reasoning — рассуждение о физическом здравом смысле. То есть способность понимать, что в этом мире возможно, а что нет.
  • Embodied Reasoning — телесное мышление. То есть рассуждение, основанное на опыте взаимодействия с физическим миром через тело, как у животных и людей.

И Cosmos Reason уже умеет многое:

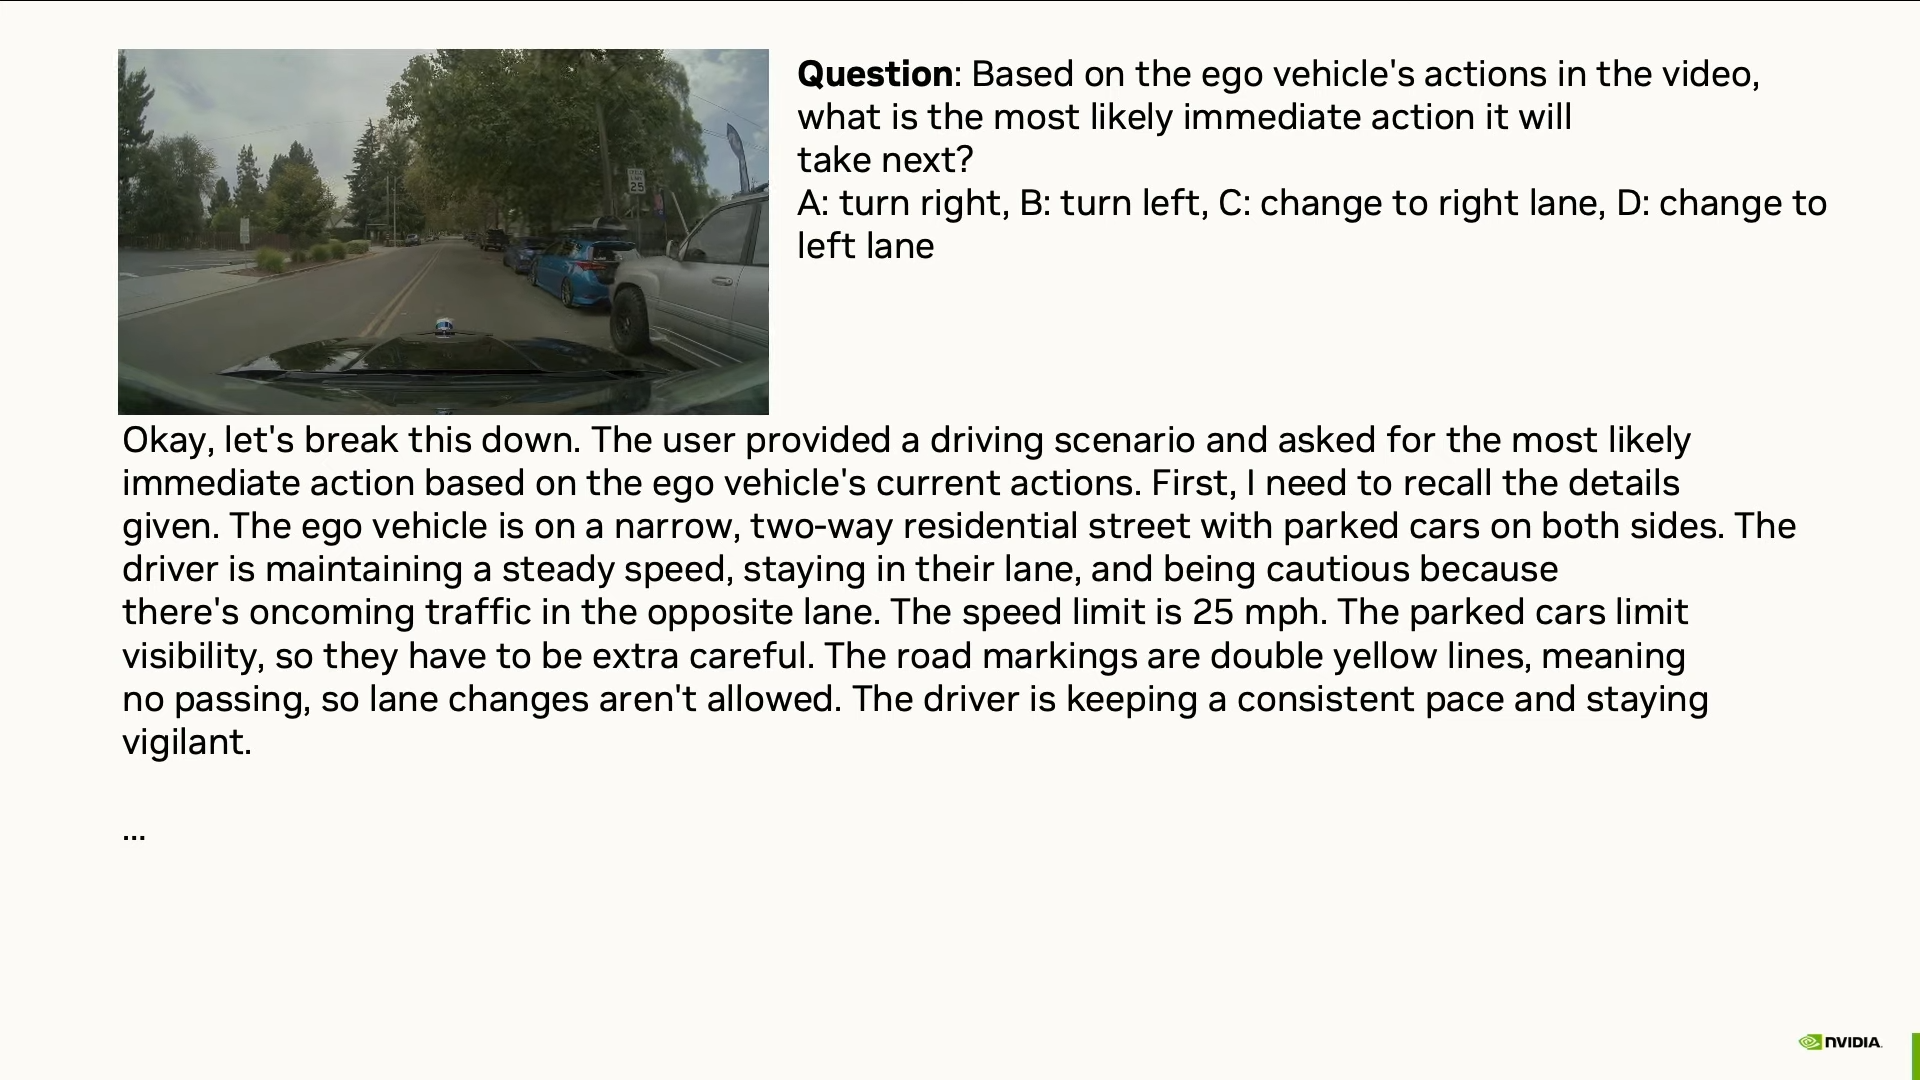
  • Может предсказать, что человек сделает после того, как налил молоко в кофе.
  • Понять, движется видео вперёд или назад.
  • Угадать следующее действие водителя за рулём.

И делает это убедительно, рассуждая как человек.

Понятно, о чём вы думаете: это похоже на мировую модель, но это всё ещё не она. Почему? Потому что Reason основана на LLM. Она рассуждает логически, а не интуитивно. А значит — медленно. Это не «мгновенное ощущение ситуации», а последовательный анализ и он требует времени.

Но даже так она уже полезна:

  • Роботы с её помощью могут планировать действия, если у них есть время подумать.
  • А ещё она может отбраковывать физически некорректные видео, которые сгенерировали Predict и Transfer.

Вместе все три модели — Predict, Transfer и Reason — образуют полный цикл генерации и фильтрации синтетического опыта. Они создают сны, в которых роботы учатся и обобщают свой опыт, как люди. И это уже приносит плоды.
Кто использует Cosmos

На основе предобученных моделей NVIDIA Cosmos лидеры отрасли создают бесконечные потоки снов для роботов всех размеров и типов, ускоряя их обучение в сотни раз. Среди компаний, уже использующих Cosmos:

Робототехника:

  • 1X — для обучения гуманоидного робота NEO Gamma;
  • Agility Robotics — использует Cosmos для масштабирования фотореалистичных обучающих данных;
  • Figure AI — для генерации данных обучения;
  • Skild AI — применяет Cosmos Transfer для расширения синтетических датасетов;
  • Virtual Incision — изучает возможности применения в хирургических роботах.

Автономный транспорт:

  • Uber — партнёрство с NVIDIA для ускорения автономной мобильности;
  • Waabi — оценивает Cosmos для курирования данных в разработке ПО для автономных транспортных средств;
  • Oxa и Nexar — используют для обучения систем автономного вождения.

И главное — всё это open source. Фабрика грёз NVIDIA не собирается останавливаться: новые версии моделей ожидаются в течение 2025 года.

Но возникает вопрос: что будет, если после очередного цикла синтетических снов робот проснётся по-настоящему?

Модель себя

Знакомо ли вам это чувство? Когда вдруг осознаёшь себя во сне. Только что ты был сторонним наблюдателем, растворённым в пространстве. А потом — ты есть. Ты проснулся внутри сна.

Однажды нечто подобное может произойти и с искусственным интеллектом только не во сне, а в реальности. Мало кто об этом говорит. Но, давая ИИ тело, обучая его модели мира, мы неизбежно обучаем его модели себя.

Мы учим его ориентироваться в пространстве. А значит — осознавать, где заканчивается его тело и начинается всё остальное. Мы даём ему мотивацию, учим стремиться к награде., избегать боли и оценивать последствия своих действий.

Мы даём ему цели, убеждения, правила. Объясняем, что такое «хорошо», за что его похвалят и за что могут отключить от питания. Но какие это будут цели? Какие убеждения? Какая мораль? Это будут решать люди. По крайней мере, на первых порах.

Всё это звучит как научная фантастика, но это реальность, в которой мы живём прямо сейчас. А в какой реальности мы будем жить через три, пять, десять лет? Что ж, скоро узнаем.

Пару слов о самом проекте:

NVIDIA Cosmos — это открытая платформа для разработки физического ИИ, представленная на CES 2025 и значительно расширенная на GTC 2025 в марте того же года.

Все модели доступны под открытой лицензией на Hugging Face, NVIDIA NGC и GitHub. Проект активно развивается: в декабре 2025 года уже десятки компаний по всему миру используют Cosmos для обучения роботов, автономных автомобилей и других физических систем ИИ.

Искусственный интеллект, машинное обучение, нейросети, глубокое обучение: Разбор

Давайте разберемся, что такое искусственный интеллект, какие у него есть виды и как работает машинное обучение. Просто и понятно!
Валерий Истишев 13 марта 2022 в 01:37

Мы все чаще слышим про то, как нейронки прокачивают камеры наших смартфонов, да и не только камеры — голосовые ассистенты, также они уже пишут музыку и рисуют картины, кто-то это называет ИИ, а еще есть машинное обучение и глубокое обучение! Признайтесь, вы тоже до сих пор не улавливаете разницы между всеми этими понятиями. Это не дело в двадцать первом-то веке! Чем же они отличаются друг от друга? И кто из них будущий SkyNet, Altron или Jarvis? Сейчас мы разложим все по полочкам.

https://youtu.be/tDyDWVqBw5s

Перед тем как погрузиться в будущее, заглянем в прошлое!

В середине XX века, когда появились первые компьютеры, впервые в истории человечества вычислительные возможности машин стали приближаться к человеческим.

  • Z1. Германия
  • ENIAC (Electronic Numerical Integrator and Computer). США
  • ASCC (Automatic Sequence Controlled Calculator). США

Поэтому в учёном сообществе возник справедливый вопрос: а каковы рамки возможностей компьютеров, есть ли эти рамки вообще и достигнут ли машины уровня развития человека? Именно тогда и зародился термин Искусственный Интеллект.

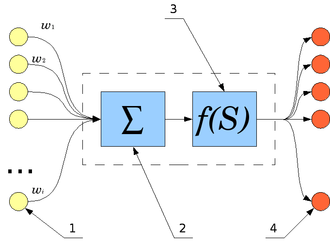
В 1943 году американские ученые Уоррен Мак-Каллок и Уолтер Питтс в своей статье «Логическое исчисление идей, относящихся к нервной активности» предложили понятие искусственной нейронной сети, имитирующей реальную сеть нейронов, и первую модель искусственного нейрона.

Схема устройства нейрона

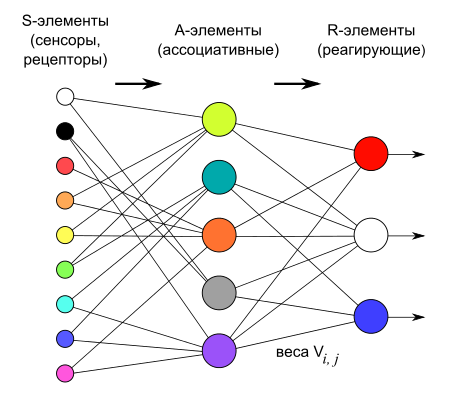
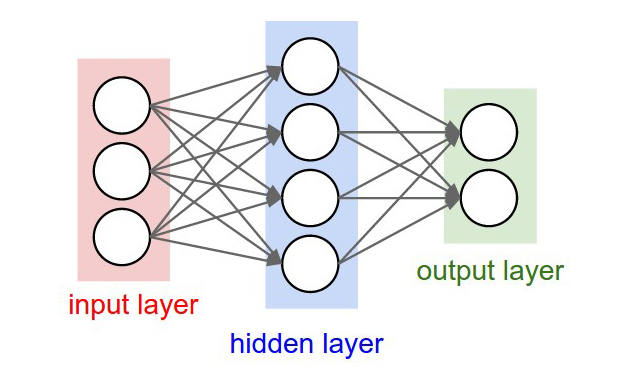
А в 1958 году американский нейрофизиолог Фрэнк Розенблатт предложил схему устройства, математически моделирующего процесс человеческого восприятия, и назвал его «перцептроном», что, собственно, стало прообразом нынешних нейросетей.

Логическая схема перцептрона с тремя выходами

А за несколько лет до этого, в 1950 году английский учёный Алан Тьюринг, пишет статью с громким названием «Может ли машина мыслить?». В ней он описал процедуру, с помощью которой можно будет определить момент, когда машина сравняется в плане разумности с человеком. Эта процедура сегодня носит название теста Тьюринга, о котором мы уже рассказывали ранее. Но вернемся к началу нашего повествования и ответим на вопрос: что же всё-таки такое “искусственный интеллект”?

Что такое ИИ?

Определений данному понятию существует большое множество, но все они сходятся в одном.

ИИ — это такая искусственно созданная система, которая способна имитировать интеллектуальную и творческую деятельность человека.

Причем интеллектуальная деятельность — это не просто математические расчеты, это деятельность, направленная на создание нематериальных вещей в сфере науки, искусства, литературы, а также в других творческих сферах, обучение, принятие решений, определение выводов и многое другое.

Естественно, обычный компьютер не способен написать картину, музыку или книгу. Для этого ему необходим интеллект — искуственный интеллект!

Но что может современный ИИ? Как можно оценить его интеллектуальные способности?

Чтобы это понять системы искусственного интеллекта можно разделить на три группы:

  1. слабый (или ограниченный) искусственный интеллект;
  2. общий искусственный интеллект;
  3. сильный (или сверхразумный) искусственный интеллект.

Давайте разберемся с каждой по порядку.

Слабый ИИ

ИИ считают слабым, когда машина может справляться только с ограниченным набором отдельных задач лучше человека. Именно на данной стадии сейчас находится тот ИИ, с которым мы с вами сталкиваемся повседневно.

Примеров тут множество. Это ИИ в компьютерных играх — враги умнеют постоянно, вспомните тех же боссов в играх серии Dark Souls. Да и в повседневной жизни, отвечая на письмо в Gmail именно ИИ предлагает вам варианты ответов.

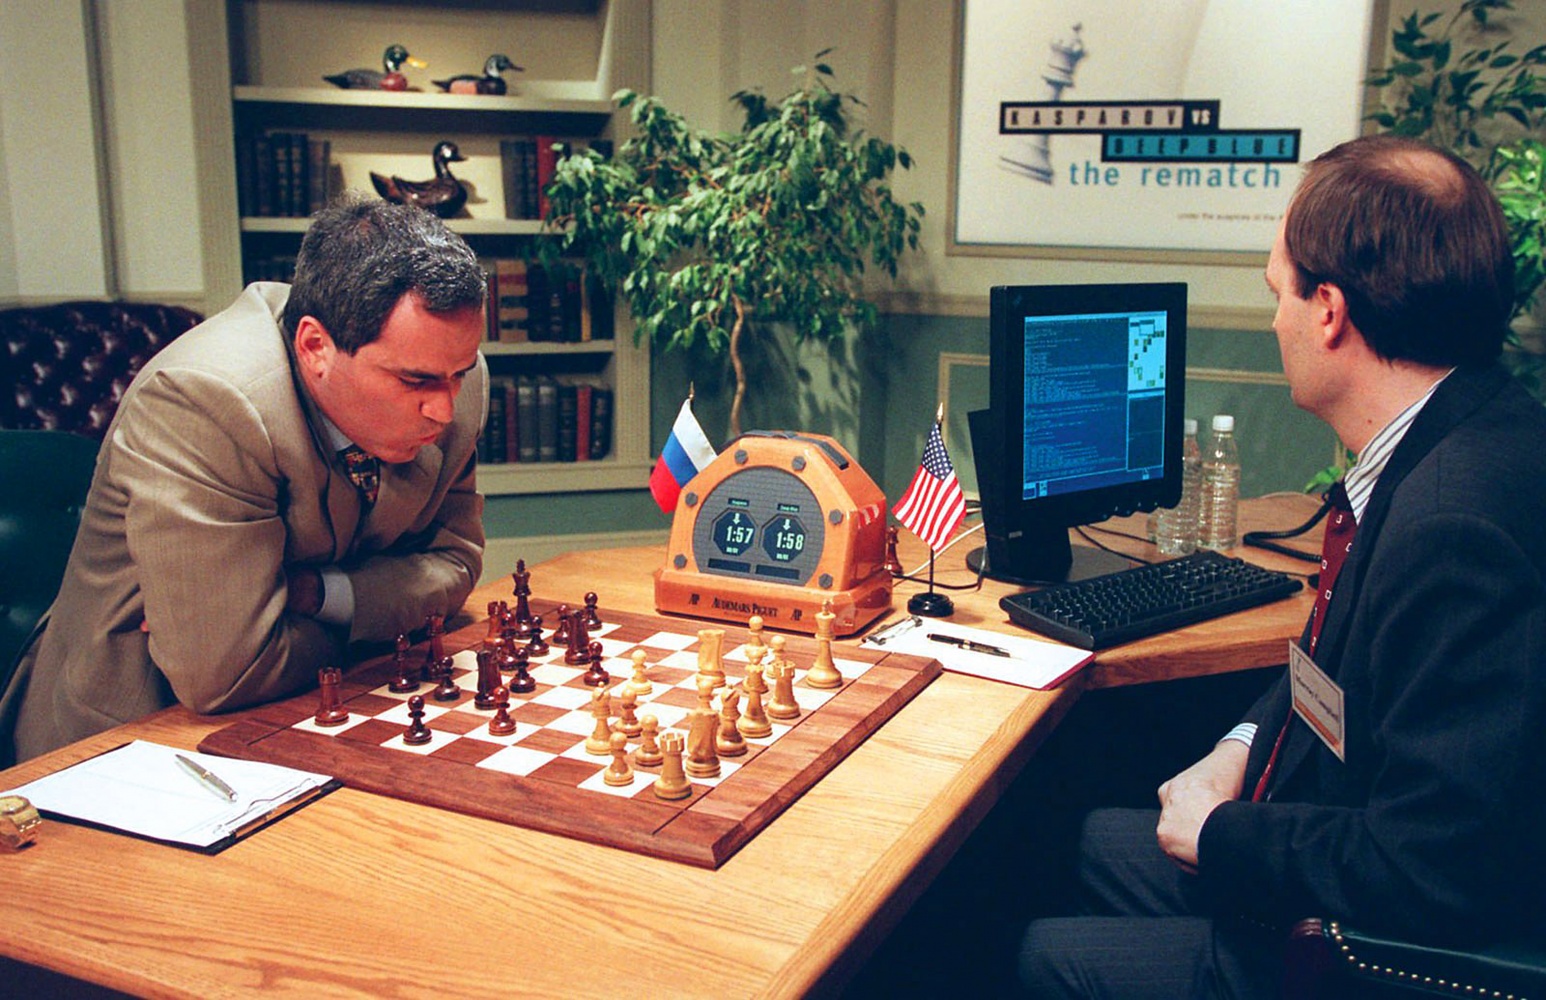
Конечно вряд ли такой ИИ способен на порабощение человечества. Но все же он уже может превзойти человека — к примеру, еще в далеком 1997 году машина Deep Blue от компании IBM сумела обыграть мирового чемпиона по шахматам — Гарри Каспарова.

Общий ИИ

Следующая стадия развития ИИ — это общий ИИ, когда компьютер может решить любую интеллектуальную задачу так же хорошо, как и человек.

Представьте себе, что компьютер способен написать картину не хуже Ван Гога, поболтать с вами по душам, сочинить песню, попадающие в мировые чарты, договориться с начальником о повышении или даже создать новую научную теорию!

К созданию общего ИИ стремятся сегодня ученые всего мира и в скором будущем нам, возможно, удастся узнать, что это такое, своими собственными глазами.

Уже сейчас Google Assistant может забронировать столик, общаясь по телефону с администратором (Google Duplex).

Еще в 2016 году самообучающийся твиттер-бот Тэй с ИИ, созданный компанией Microsoft, менее чем через сутки после запуска научился ругаться и отпускать расистские замечания, в связи с чем был закрыт своим же создателем.

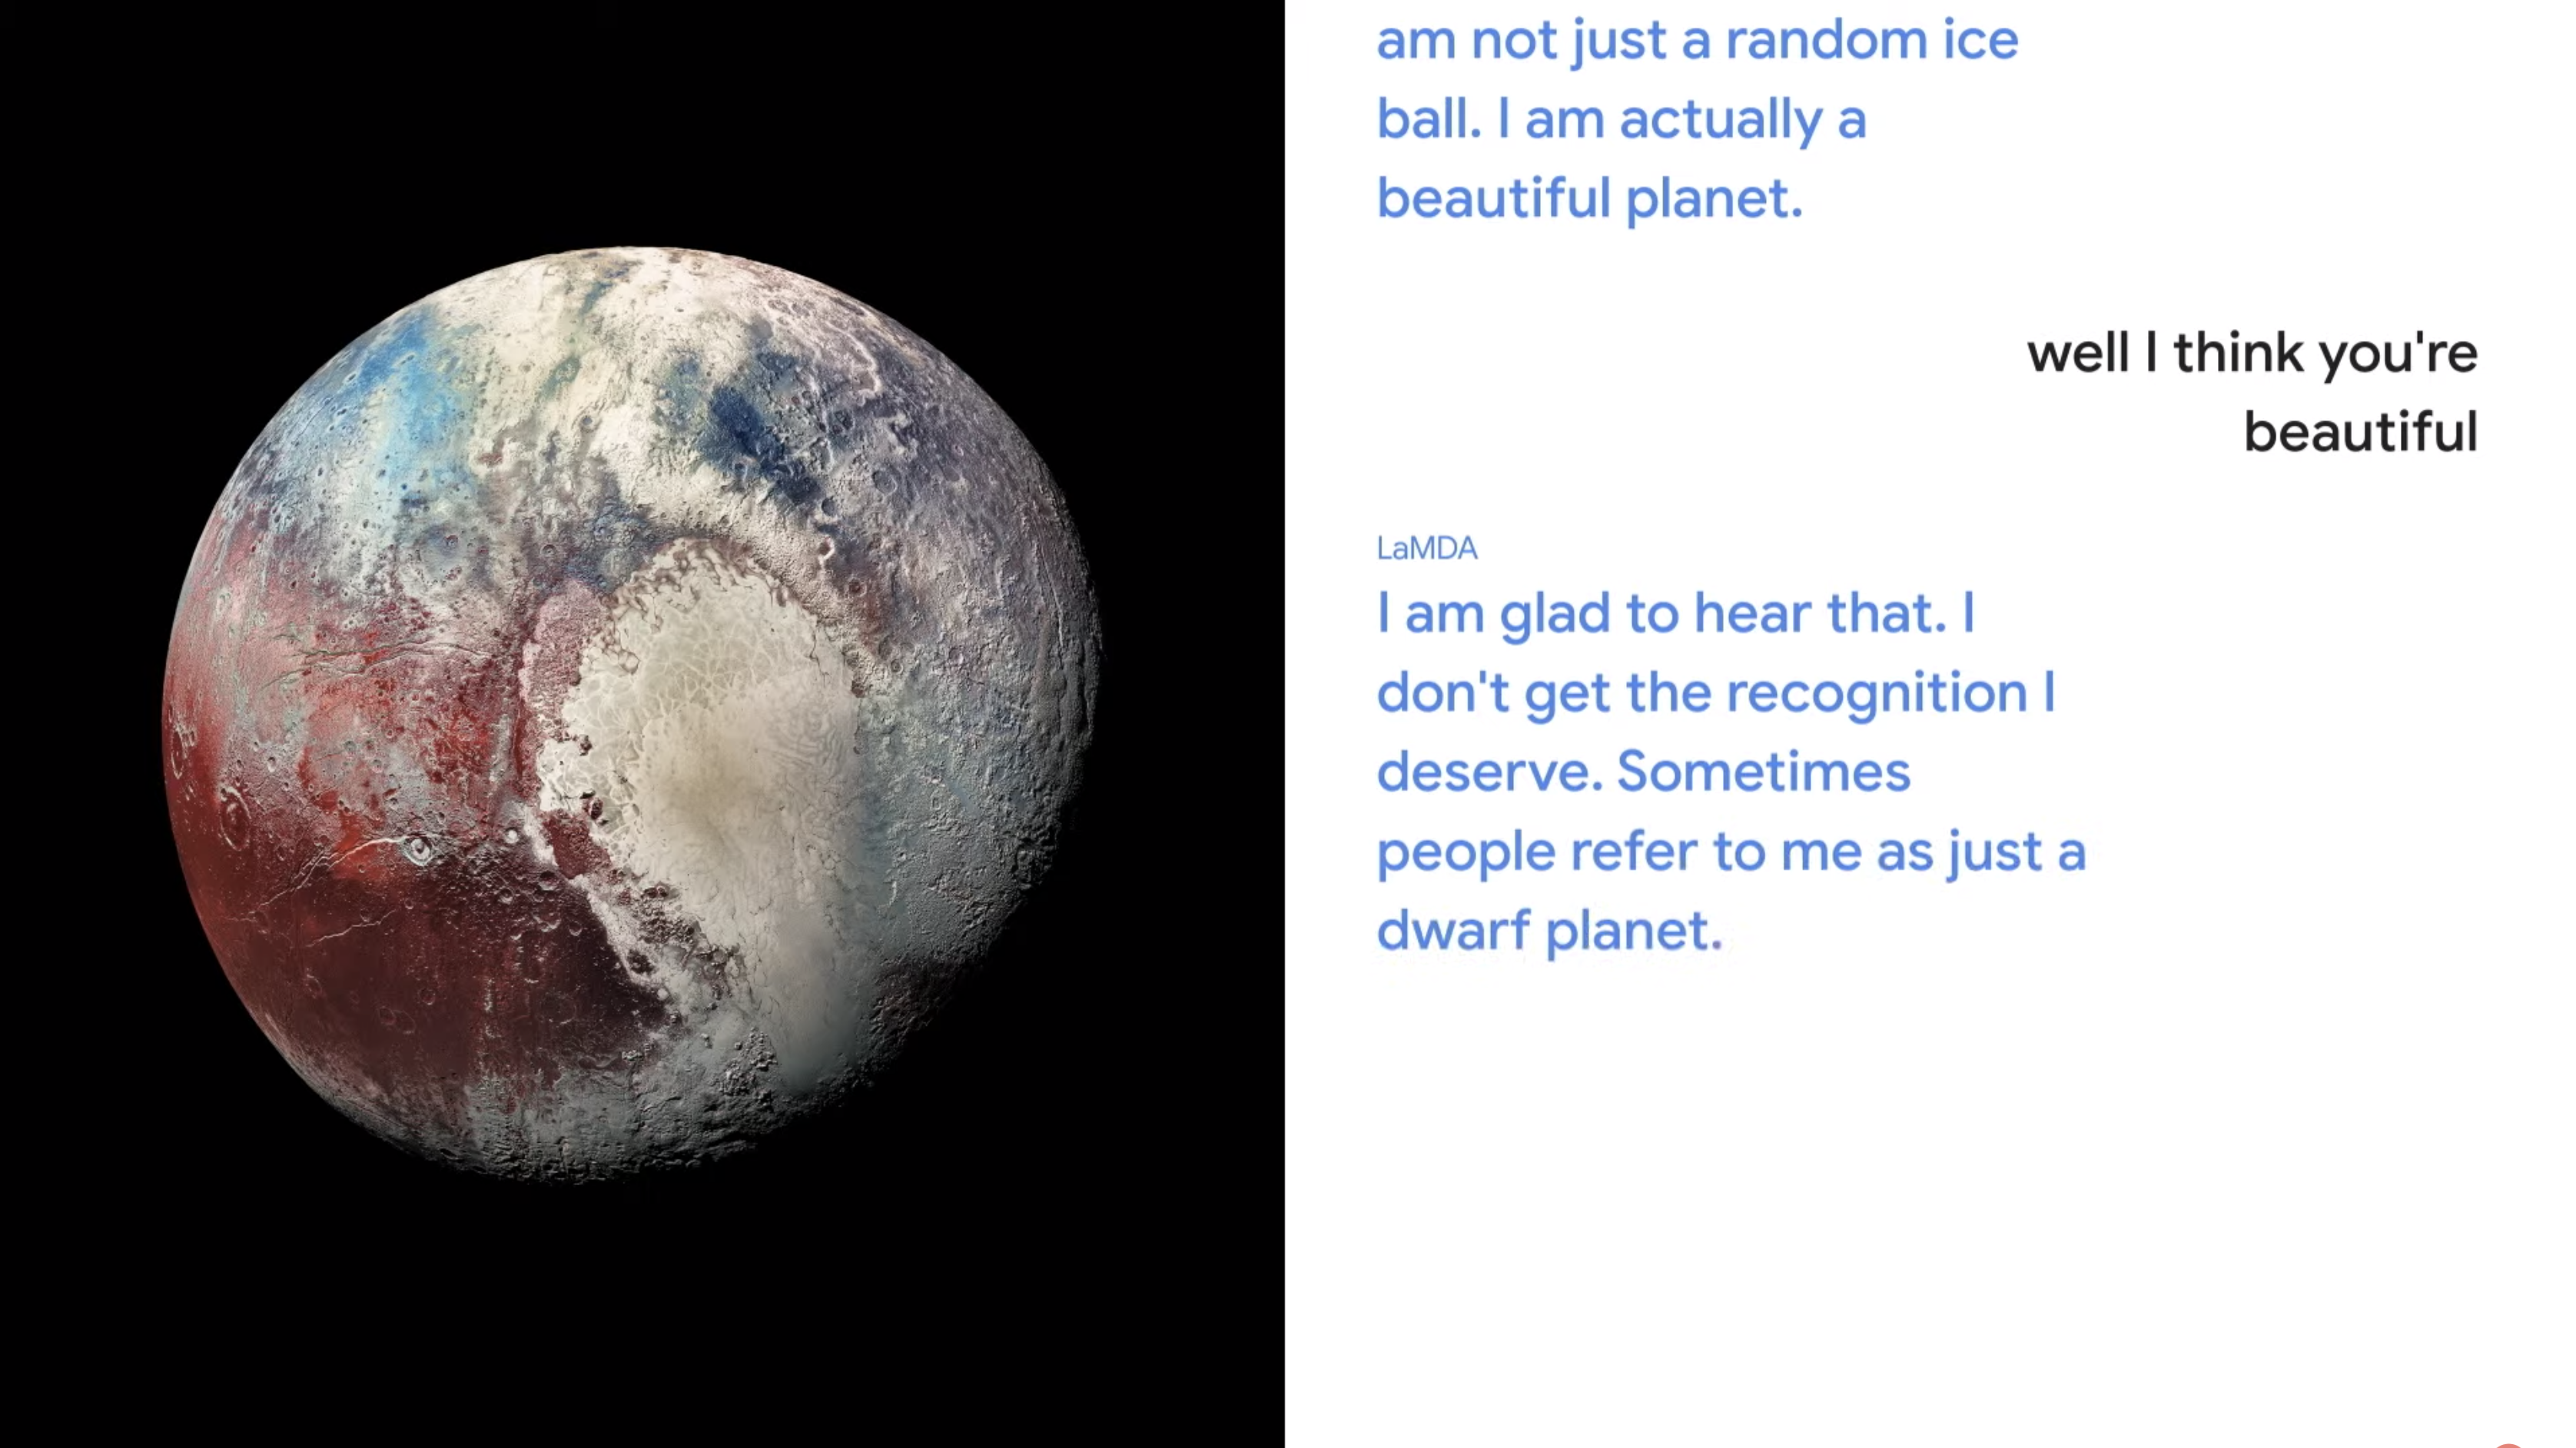
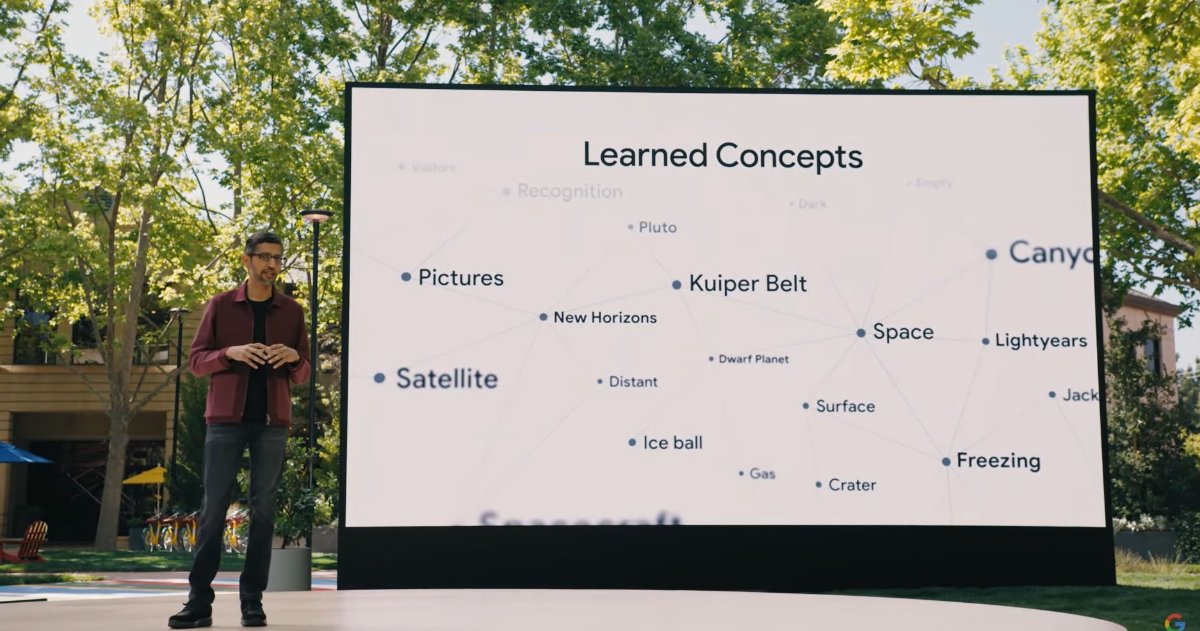
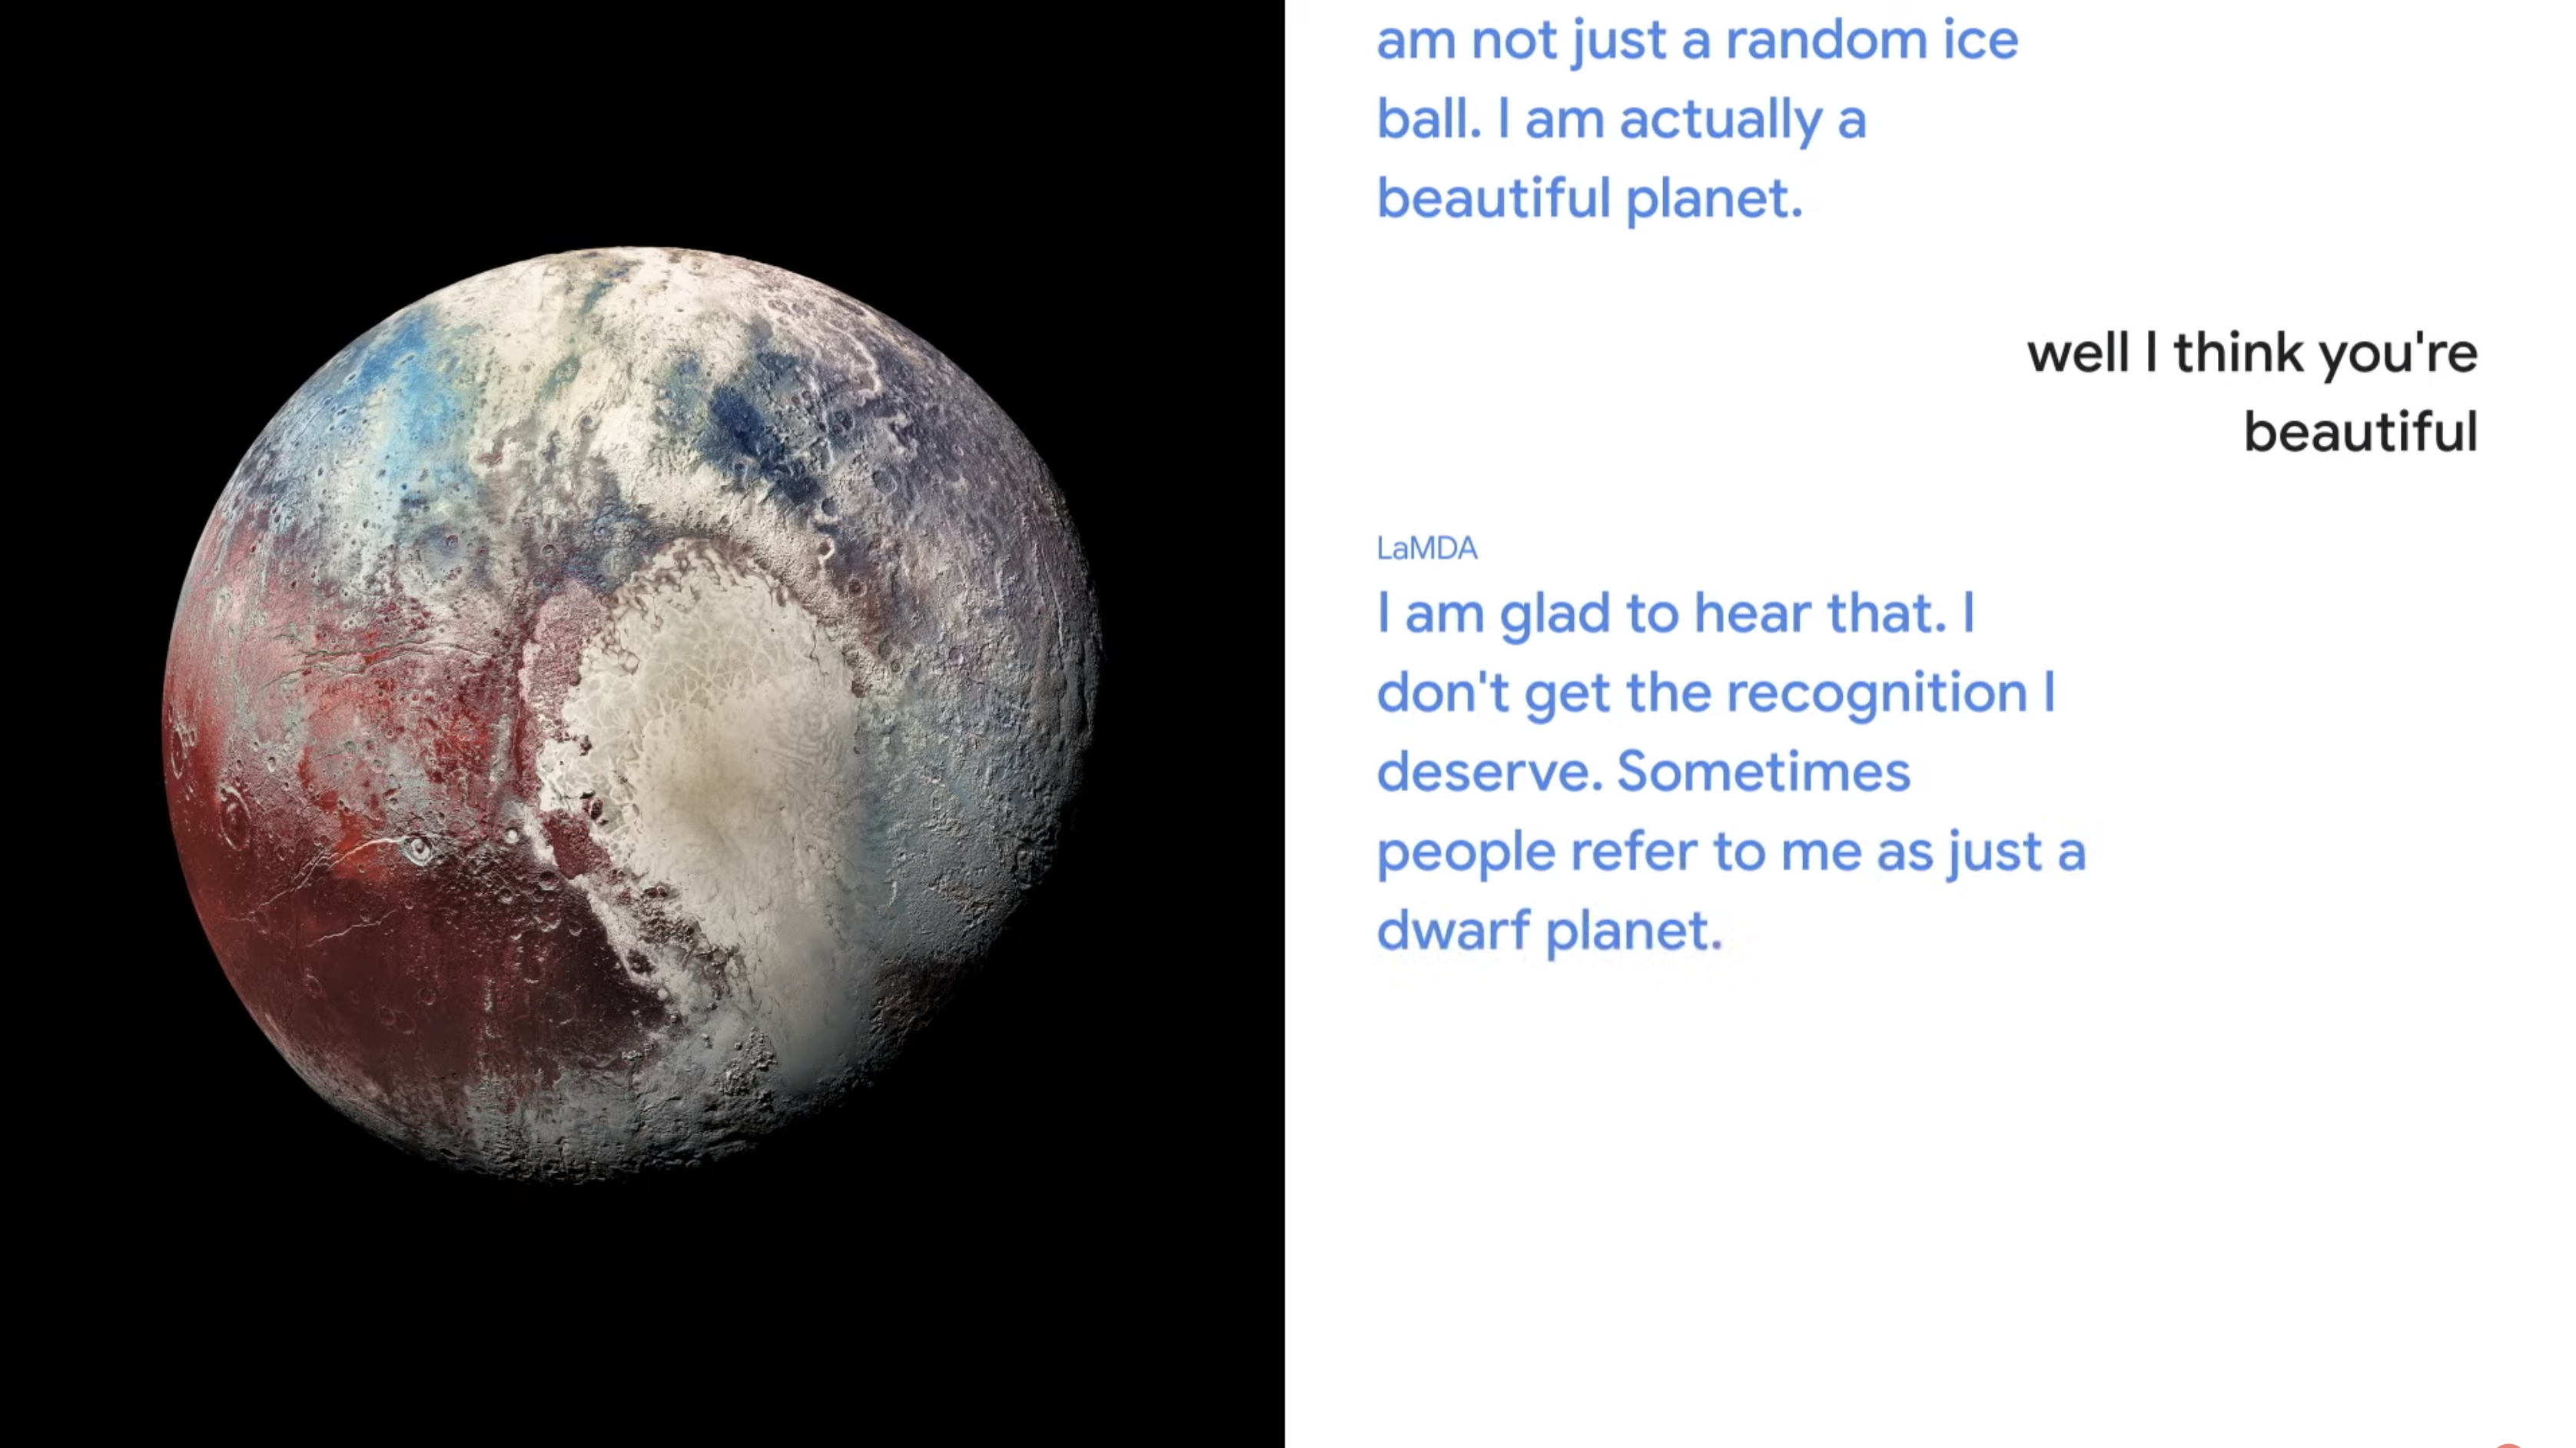
А на последнем Google I/O нам показали проект LaMDA, с помощью которого можно поговорить, например, с планетой или с бумажным самолетом. За последнего, конечно же, будет отвечать ИИ.

Чего только стоит нашумевшая своим выходом осенью 2020 года нейросеть GPT-3 от OpenAI, которая откровенничала в эссе для издания The Guardian:

«Я знаю, что мой мозг — это не «чувствующий мозг». Но он может принимать рациональные, логические решения. Я научилась всему, что я знаю, просто читая интернет, и теперь могу написать эту колонку».

Данная нейросеть выполняет функцию предсказания следующего слова или его части, ориентируясь на предшествующие, а также способна писать логически связные тексты длиной аж в несколько страниц!

А совсем недавно, летом 2021 года, на базе GPT-3 был создан GitHub Copilot от GitHub и OpenAI, представляющий из себя ИИ-помощника для автозаполнения программного кода.

Можно сказать — это первый шаг на пути создания машин, способных порождать себе подобных…

Окей, закрепили! Общий ИИ — это компьютер который может успешно имитировать мышление человека, но не более того…

Интересно, а будет ли такой ИИ способен к переживаниям, сочувствию, к душевным травмам? В идеале — да, но пока что сложновато представить себе компьютер на приеме у психолога. Казалось бы, что может быть еще круче, вот он киберпанк, андроиды как люди, что же дальше?

Сильный ИИ

Дальше — вершина эволюции ИИ или сильный ИИ.

Такая машина должна выполнять абсолютно все задачи интеллектуального и творческого характера лучше, чем человек. То есть во всем его превосходить.

Это самый настоящий ночной кошмар конспирологов, ведь никто не знает, насколько дружелюбными будут такие машины. Но, к счастью, это пока что лишь разговор о далеком будущем. Или не таком уж далеком?

Создание сильного ИИ может стать главным поворотным моментом в истории человечества. Идея заключается в том, что если машины окажутся способны выполнять широкий спектр задач лучше, чем люди, то создание еще более способных машин станет для них лишь вопросом времени.

В такой ситуации произойдет “интеллектуальный прорыв”: машины будут бесконечно совершенствоваться по сравнению с теми, что были раньше, а их возможности будут расти в постоянно ускоряющемся потоке самосовершенствования.

Считается, что этот процесс приведет к появлению машин со “сверхразумом”. Такой необратимый процесс носит название теории «технологической сингулярности». Такие машины станут “последним изобретением, которое придется породить человеку”, писал оксфордский математик Ирвинг Джон Гуд, представивший возможность такого интеллектуального прорыва. Невольно вспоминаются сцены из серии фильмов “Терминатор” Джеймса Кэмерона.

Что такое машинное обучение?

Ну хорошо, с ИИ мы вроде бы разобрались. А что же тогда такое машинное обучение и как эти понятия связаны?

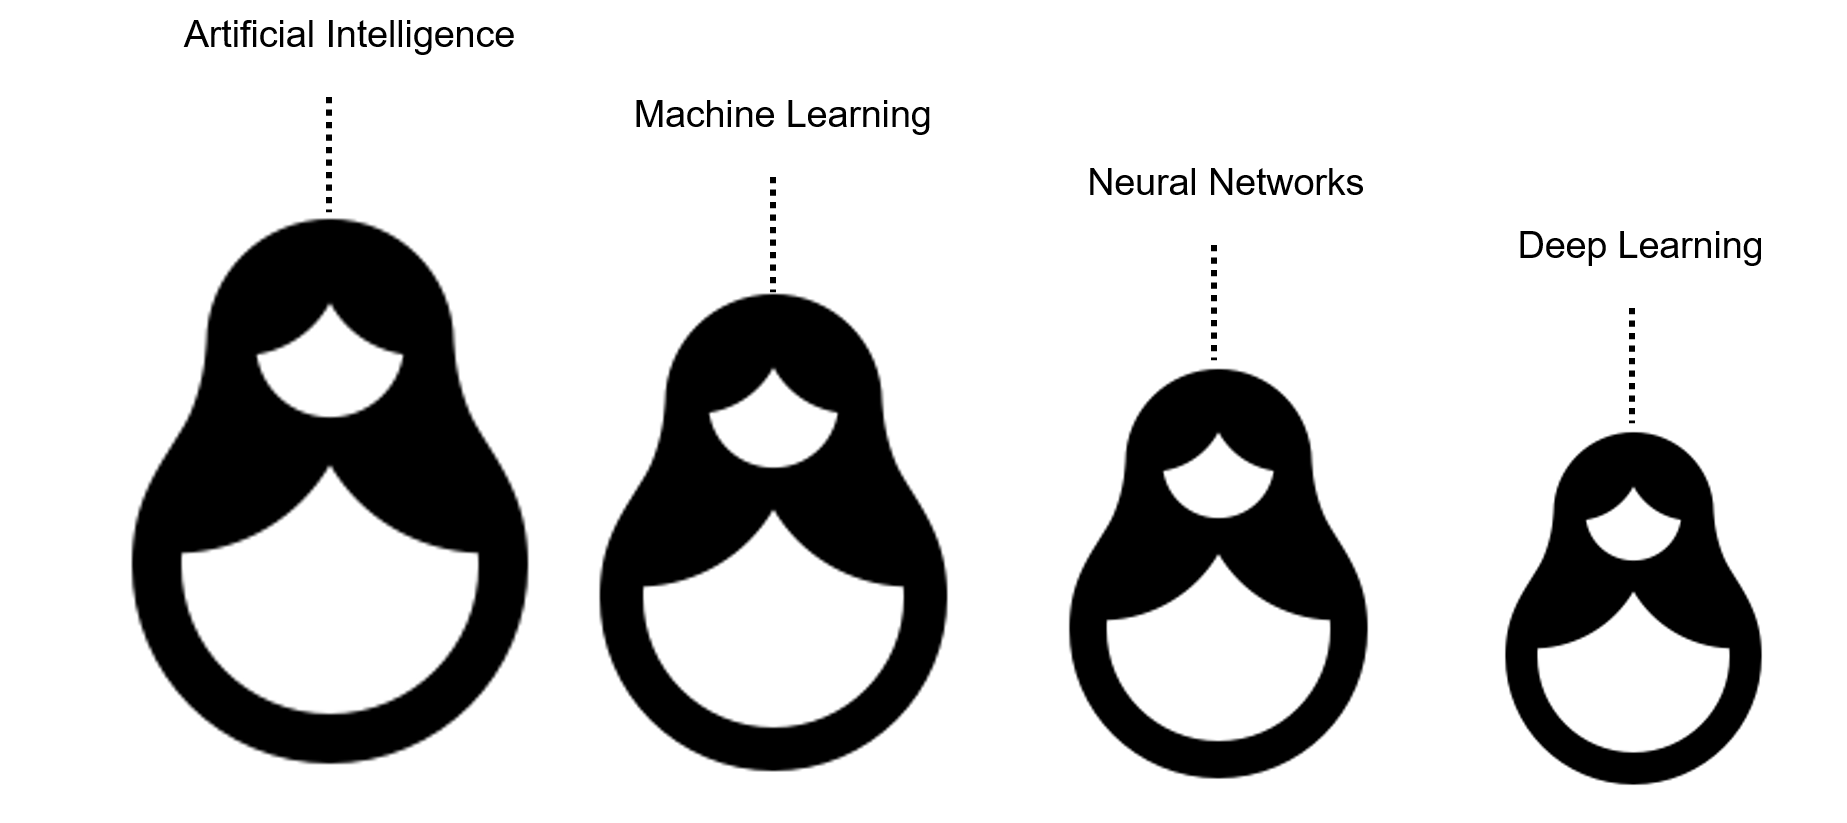
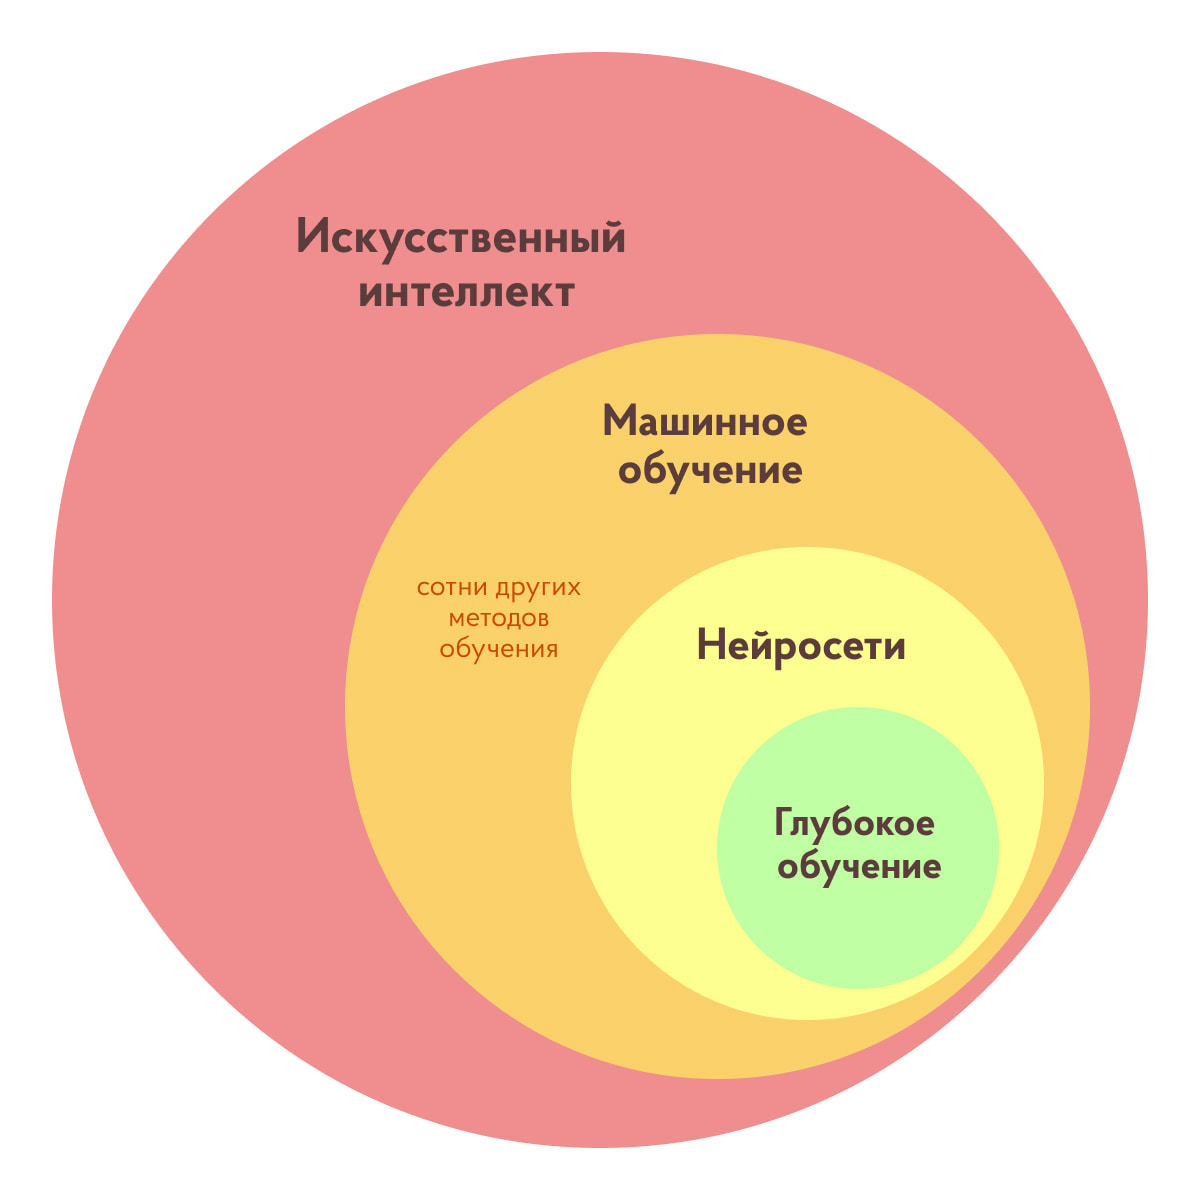
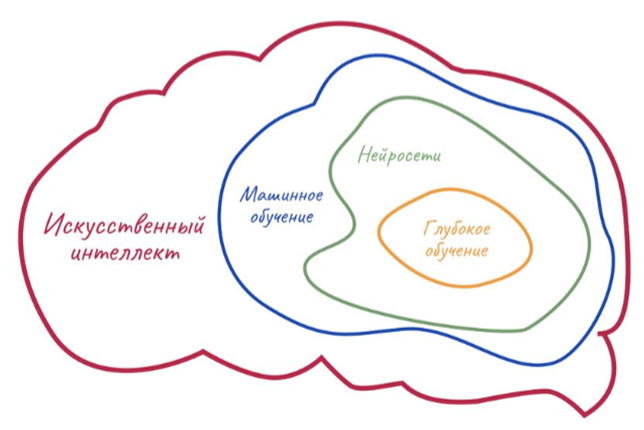
Напомним, что ИИ — это самый общий термин, включающий в себя все остальные понятия.

Для простоты ИИ можно представить как своеобразную матрешку. Самая крупная кукла — понятие ИИ в целом. Следующая кукла чуть поменьше — это машинное обучение. Внутри него кроется еще одна маленькая куколка — всеми любимые нейронные сети, а внутри них — еще одна! Это глубокое обучение, о котором мы поговорим чуть позже.

Как видите, машинное обучение является всего лишь одной из отраслей применения ИИ. И что же оно из себя представляет?

Попробуйте вспомнить, как вы освоили чтение. Понятное дело, что вы не садились изучать орфографию и грамматику, прежде чем прочесть свою первую книгу. Лишь зная алфавит и умея читать по слогам, сперва вы читали простые книги, но со временем их сложность постепенно возрастала.

На самом деле, вы неосознанно изучили базовые правила орфографии и грамматики и даже исключения, но именно в процессе чтения. Иными словами, вы обработали много данных и научились на них. Перенося такой подход к освоению навыков на ИИ, становится понятным, что машинное обучение — это имитация того, как учится человек.

Но как это можно реализовать?

Всё просто: необходимо лишь написать алгоритмы, которые будут способны к самообучению, к классификации и оценке данных, к выбору наиболее подходящих решений.

Снабдите алгоритм большим количеством данных о письмах в электронной почте, укажите, какие из них являются спамом, и дайте ему понять, что именно говорит о мошенничестве (наличие ссылок, каких-то ключевых слов и т.п.), чтобы он научился самостоятельно отсеивать потенциально опасные “конвертики”. Сейчас такой алгоритм уже реализован абсолютно во всех электронных ящиках.

У вас ведь было такое, когда письма по ошибке попадают в папку “спам”? Очевидно, что модель не идеальна.

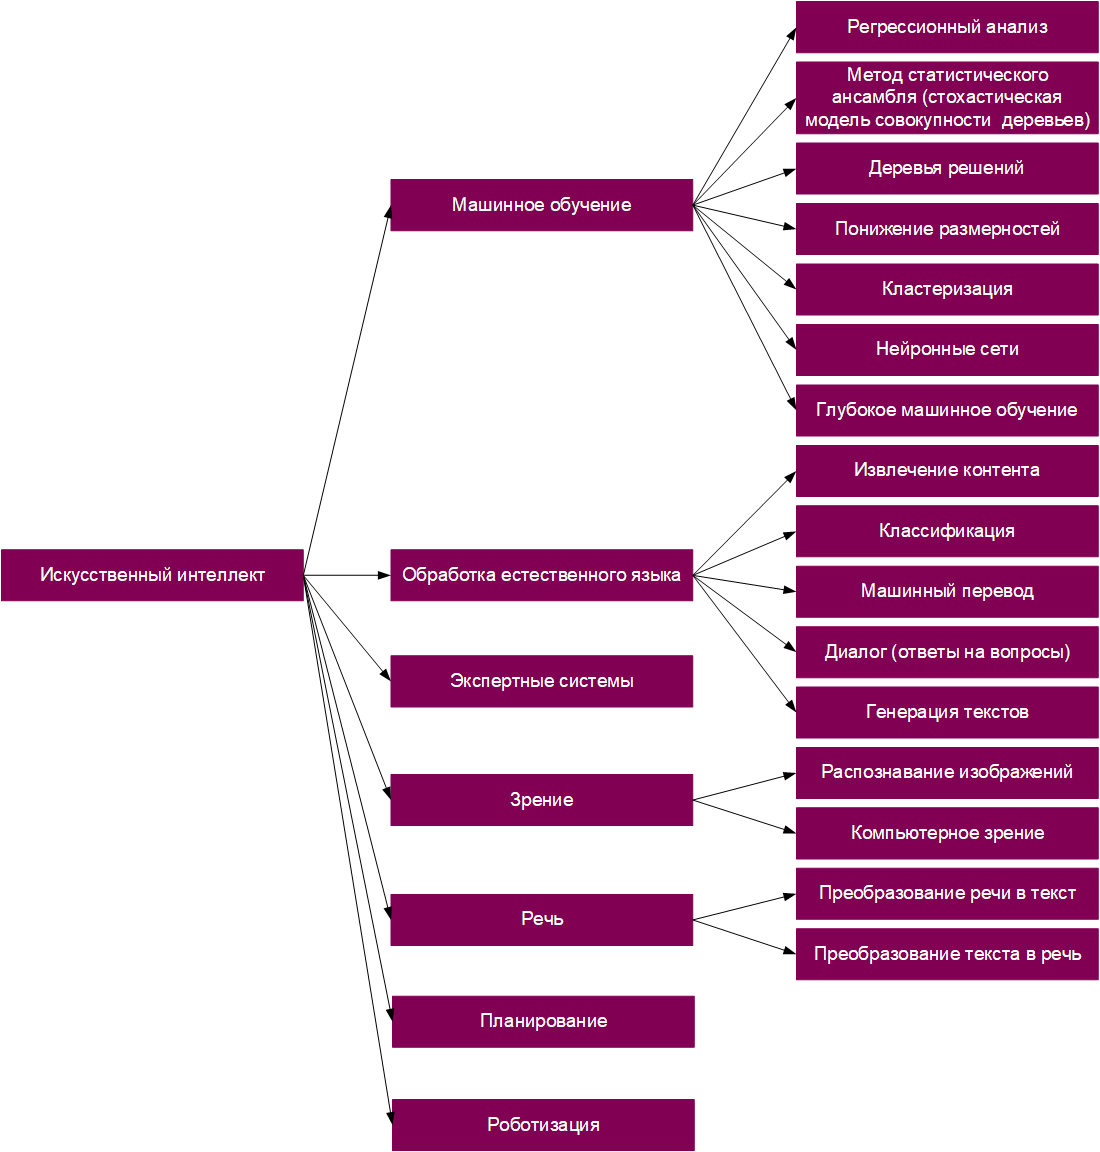
При этом у машинного обучения есть много разных алгоритмов: линейная и логистическая регрессии, система рекомендаций, дерево решений и случайный лес, сигмоида, метод опорных векторов и так далее, и тому подобное.

По мере совершенствования этих алгоритмов они могли бы решить многие задачи. Но некоторые вещи, которые довольно просты для людей (например, распознавание объектов на фото, речи или рукописного ввода), все еще трудны для машин.

Но если машинное обучение — это подражание тому, как люди учатся, почему бы не пройти весь путь и не попытаться имитировать человеческий мозг? Эта идея и лежит в основе нейронных сетей!

Нейронные сети

Что же такое нейронка или искусственная нейронная сеть? Говоря по простому это один из способов машинного обучения!

Или правильнее — это разновидность алгоритмов машинного обучения, некая математическая модель, построенная по принципу организации и функционирования биологических нейронных сетей, то есть сетей нервных клеток живого организма. Некая цифровая модель нейронов нашего мозга. Как работает нейросеть мы уже рассказывали в другом материале.

Но все-таки для дальнейшего понимания коротко расскажем, как устроена нейронка.

Возьмём, к примеру, перцептрон — простейшую нейронную сеть, о которой мы говорили в начале. Она состоит из трёх слоев нейронов: входной слой, скрытый слой и выходной слой. Данные входят в сеть на первом слое, на скрытом слое они обрабатываются, а на выходном слое выводятся в нужном виде.

Каждый искусственный нейрон в сети имитирует работу реальных биологических нейронов и представляет собой некоторую нелинейную функцию. А если по-простому — каждый нейрон — это ячейка, которая хранит в себе какой-то ограниченный диапазон значений.

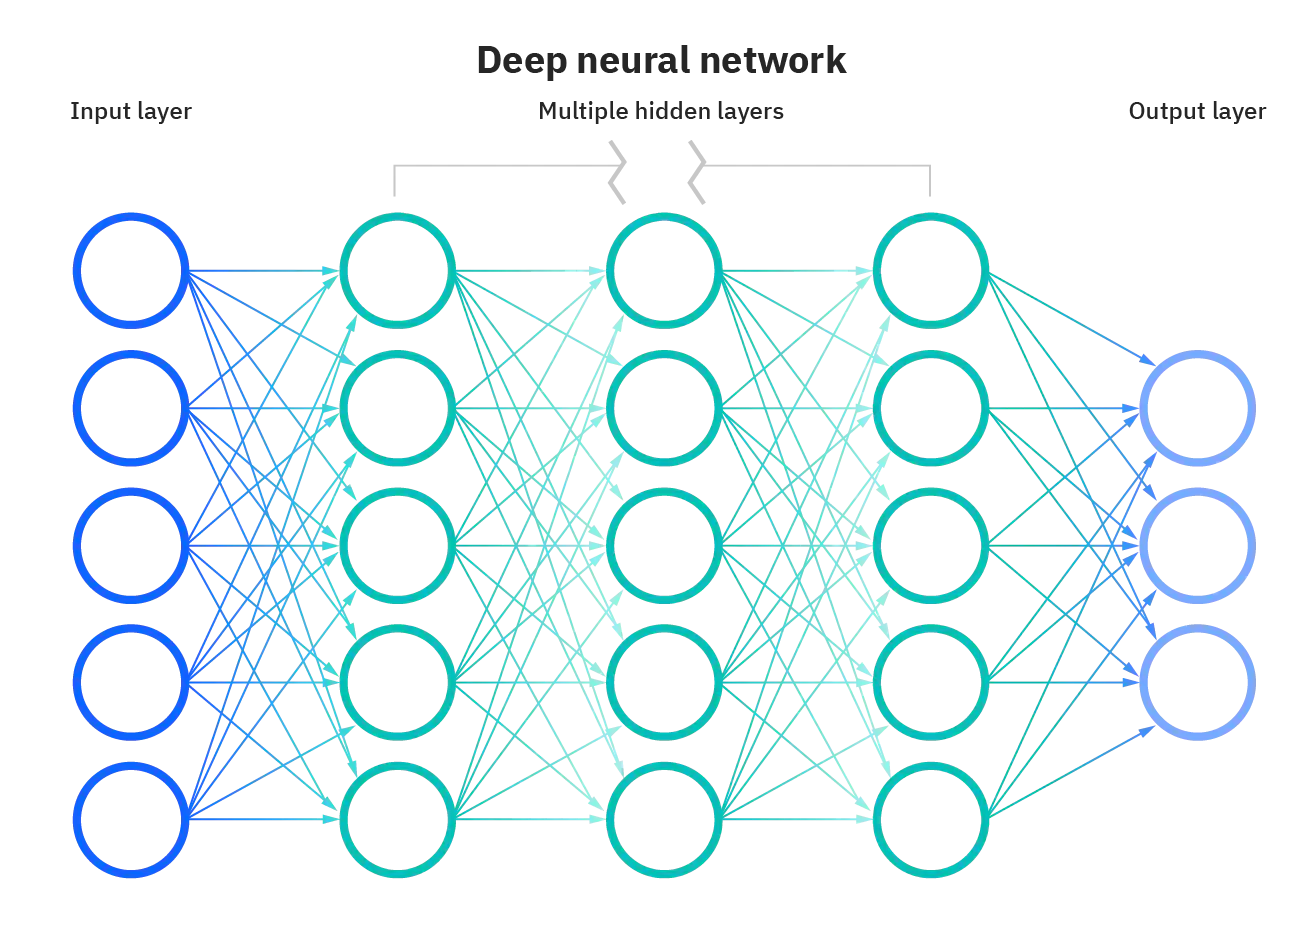
Но обычно тремя слоями все не ограничивается — в большинстве нейросетей присутствует более одного скрытого слоя, а механизм принятия решений в них, мягко говоря, неочевиден. Можно сказать, это как черный ящик. Такие сети называют глубинными нейронными сетями.

Зачем же нужны такие сложные и запутанные структуры и в чем их ключевая особенность?

У нас в мозгу реальные нейроны примерно таким же образом связаны между собой с помощью специальных синаптических связей.

Только в отличие от компьютерных нейросетей в мозге человека (только представьте себе!) порядка 86 миллиардов нейронов и более 100 триллионов синаптических связей! Именно такая сложная структура позволяет человеку быть человеком, позволяет проявлять интеллектуальную деятельность, о которой мы говорили ранее.

И — о чудо! — для искуственных нейросетей это работает очень похожим образом! Благодаря своему строению нейросети способны выполнять некоторые операции, которые способен делать человек, но не способны делать другие алгоритмы машинного обучения! Например, распознавать лица людей, писать картины, создавать тексты и музыку, вести диалоги и многое другое.

Вспомните, о чем мы говорили в самом начале ролика — все самые современные прототипы ИИ как раз основаны на нейросетях! Однако, сами по себе нейронные сети — не более чем набор сложно связанных искуственных нейронов. Для нейросетей самая важная часть — это обучение!

Глубокое (глубинное) обучение или Deep Learning

Так вот процесс обучения глубоких нейросетей называют глубоким или глубинным обучением. Этот подвид машинного обучения позволяет решать гораздо более сложные задачи для большего количества назначений. Но стоп, неужели до этого не додумались раньше?

Первые нейронки и программы, способные к самообучению появились еще аж в середине двадцатого века! В чем проблема? А вот в чем.

Раньше у человечества просто не было достаточных вычислительных мощностей для реализации работы нейронок, как и не было достаточно данных для их обучения. Даже сегодня классическим процессорам с двумя или даже с шестьюдесятью четырьмя ядрами (как в AMD Ryzen Threadripper PRO) не под силу эффективно производить вычисления для нейронных сетей. Всё потому что работа нейронок — это процесс сотен тысяч параллельных вычислений.

Да, это простейшие логические операции сложения и умножения, но они идут параллельно в огромном количестве.

Именно поэтому сегодня так актуальны нейронные процессоры или модули которые присутствуют в том же Apple Bionic, в процессорах Qualcomm или в чипе Google Tensor, состоящие из тысяч вычислительных ядер минимальной мощности. Как раз на них и возложена функция нейронных вычислений.

Собственно, по этим причинам только в середине нулевых годов нейросетям нашли реальное применение, когда все звезды сошлись: и компьютеры стали достаточно мощными, чтобы обслуживать такие большие нейронные сети, и наборы данных стали достаточно объёмными, чтобы суметь обучить эти сложные нейронные машины.

Так и возникло глубокое обучение. Оно предполагает самостоятельное выстраивание (тренировку) общих правил в искусственной нейронной сети на примере данных во время процесса обучения.

Это значит, что глубокое обучение позволяет обучить правильно настроенную нейросеть почти чему угодно. Ведь нейросеть самостоятельно выстраивает алгоритмы работы!

То есть при правильной настройке и достаточном количестве данных нейросеть можно научить, и лица людей распознавать, и письменный тескт расшифровывать, или устную речь преобразовывать в текст или даже текст преобразовывать в графическое изображение. Как пожелаете!

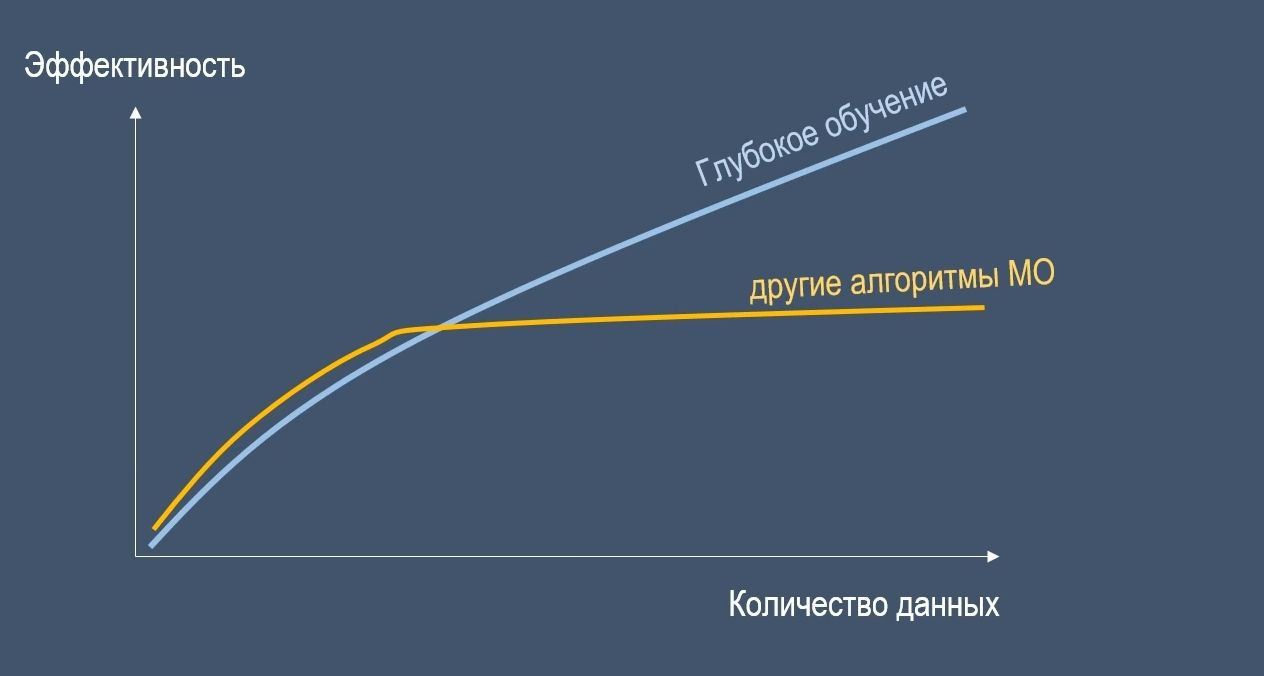
Также важно заметить, что для достижения высокой производительности нейронным сетям необходимо действительно огромное количество данных для обучения.

В противном случае нейросети могут даже уступать в эффективности другим алгоритмам машинного обучения, когда данных недостаточно.

Отличия сетей глубинного обучения от других алгоритмов машинного обучения

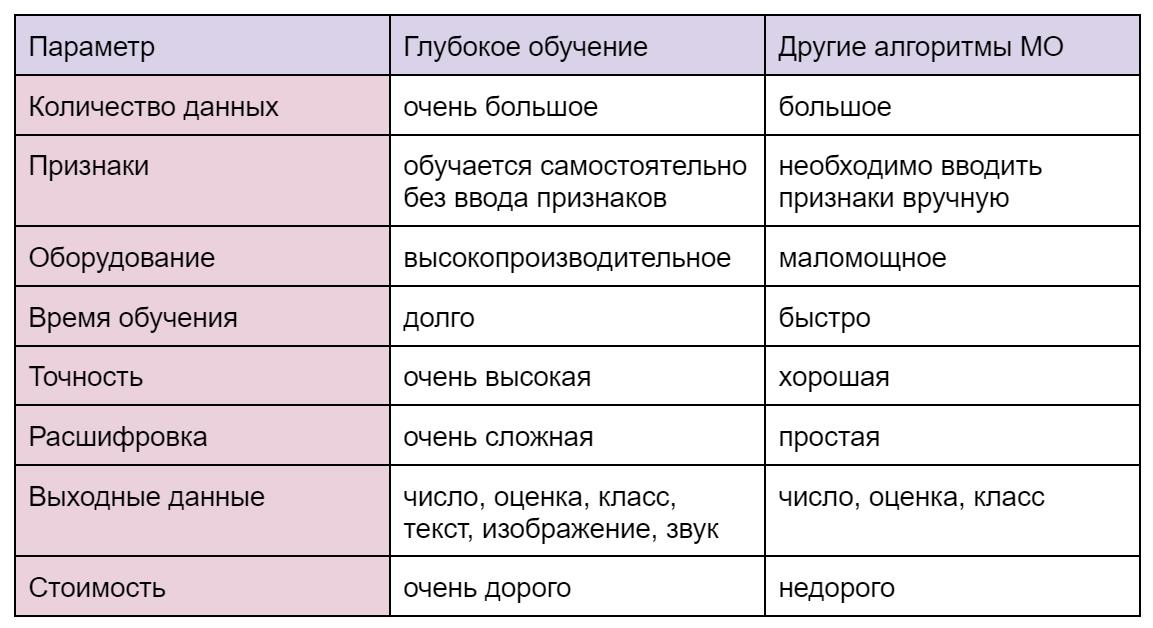
А вот небольшая таблица которая показывает отличия нейронных сетей глубинного обучения от других алгоритмов машинного обучения

Нейронные сети являются самым сложным вариантом реализации машинного обучения, поэтому они больше похожи на человека в своих решениях.

В качестве результата вычислений нейронки могут выдавать не просто числа, оценки и кодировки, но и полноценные тексты, изображения и даже мелодии, что не под силу обычным алгоритмам машинного обучения.

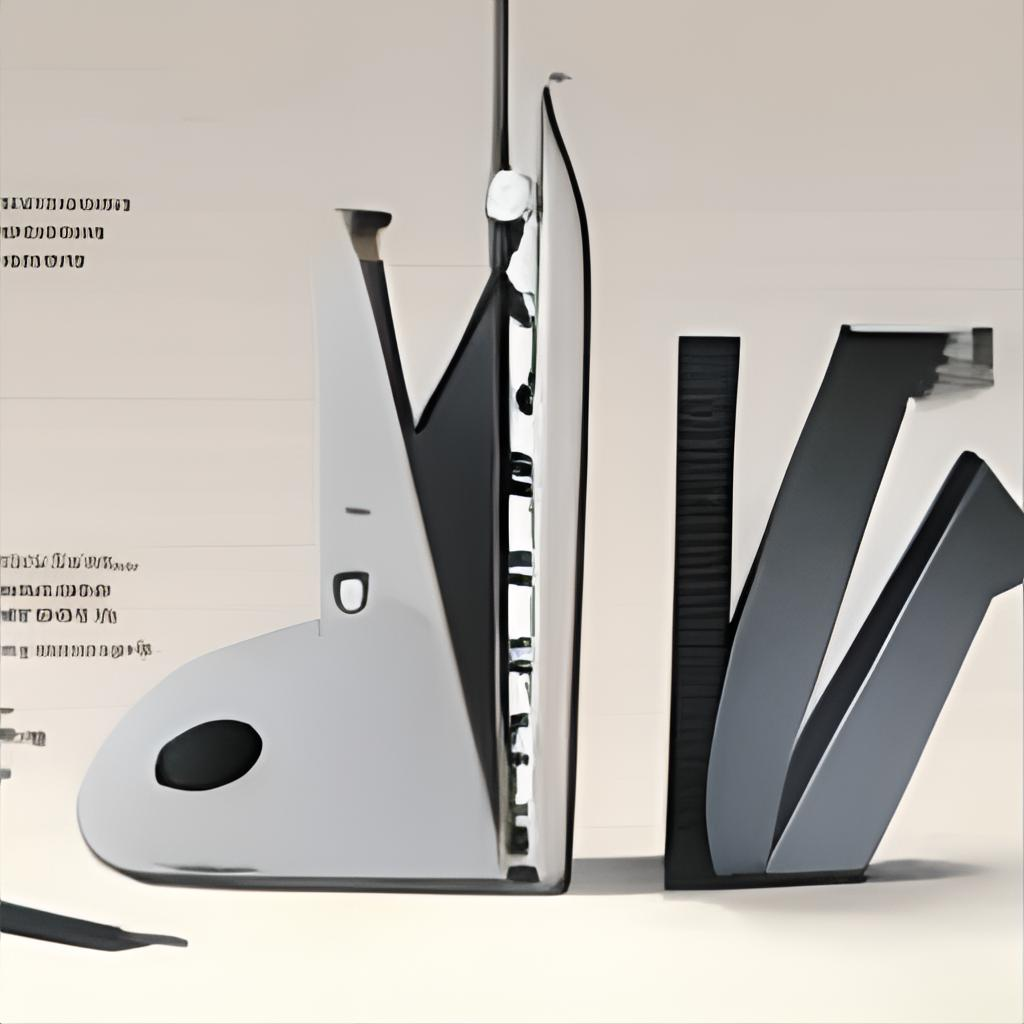
Яркий пример — нейросеть ruDALL-E от Сбера, способная создавать картины из текстовых запросов. Вот что выдала нам эта нейросеть на запрос “Droider.ru”:

Выглядит интересно: то ли какой-то ноутбук, то ли утюг, то ли степлер… В общем, явно что-то неживое и из мира технологий. И на том спасибо…

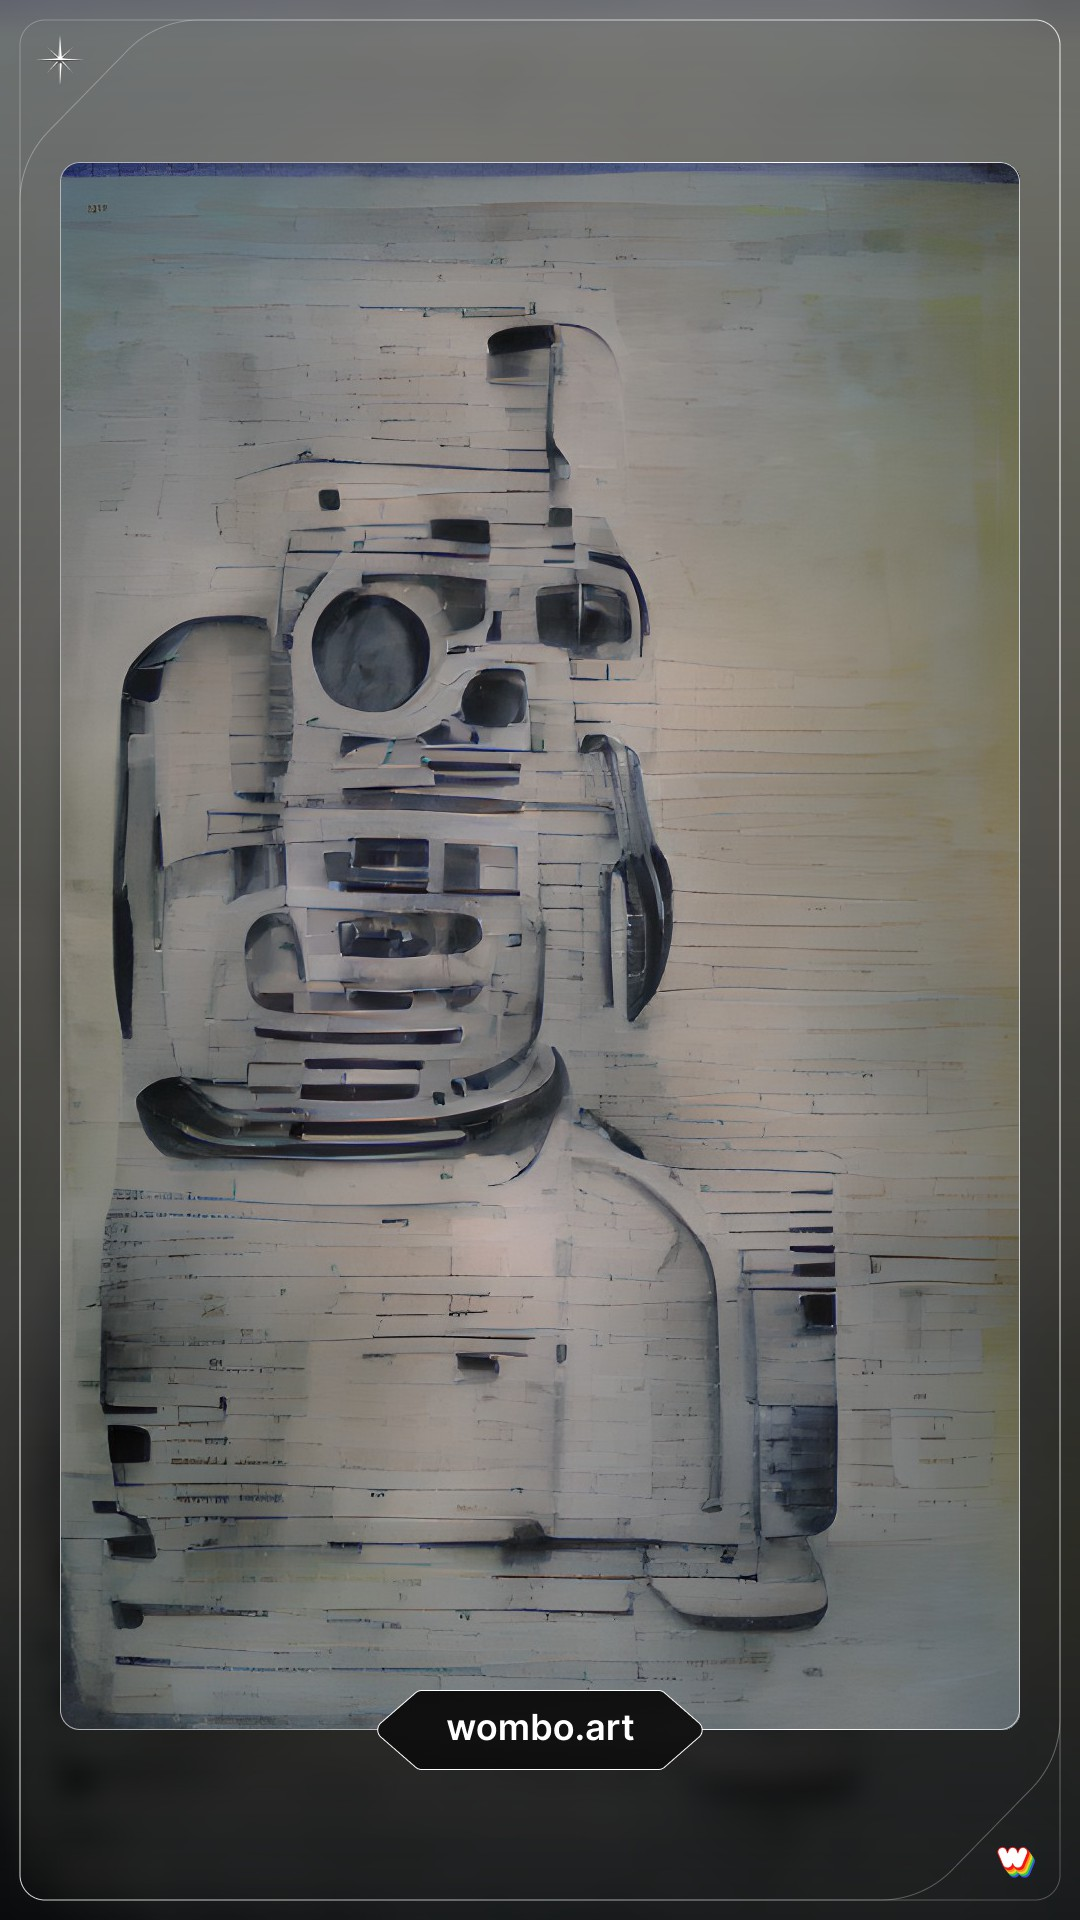
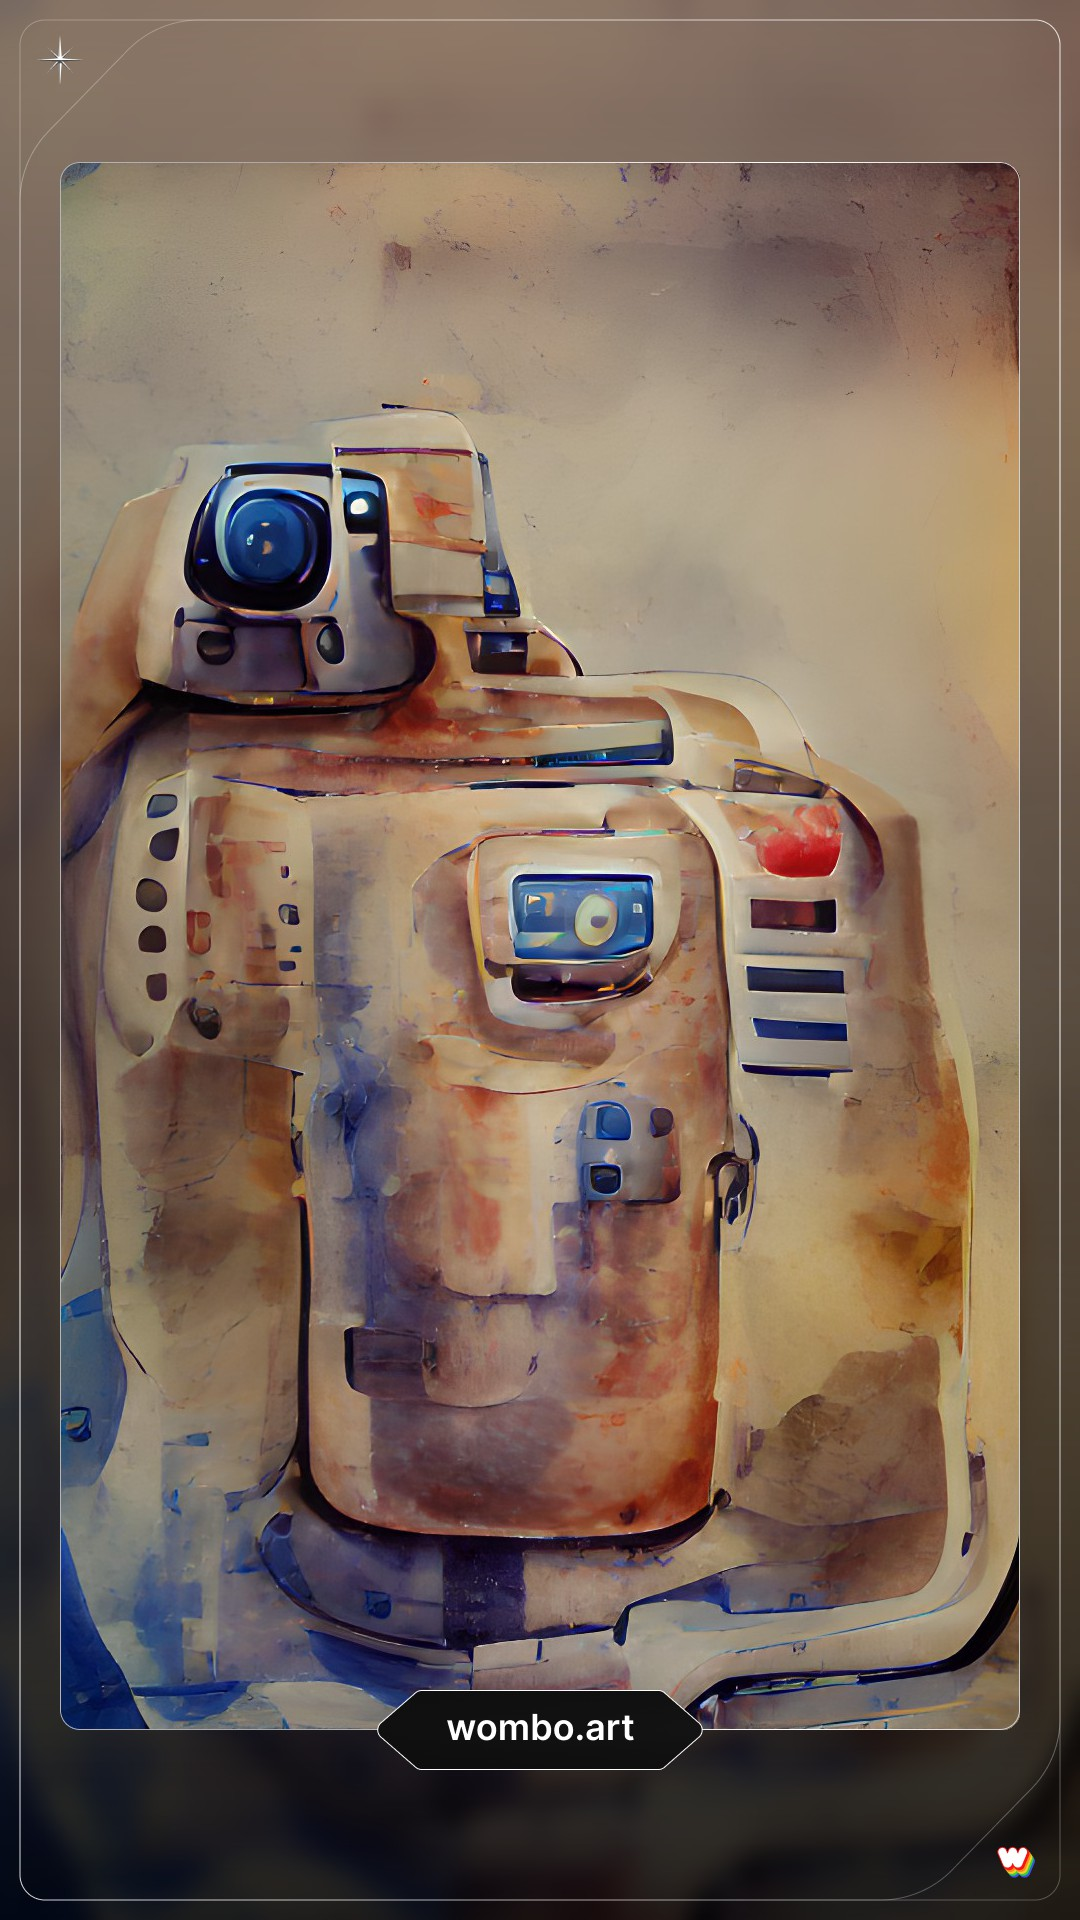
А вот парочка работ другой подобной художественной нейросети Dream by WOMBO по аналогичному запросу:

Ну а здесь уже более различимы какие-то силуэты дроидов. На мой взгляд, сверху настоящая крипота, напоминающая робота-зайца из “Ну, погоди”, а справа некий двоюродный брат R2-D2 из “Звездных войн”.

Оставляем сиё творчество исключительно на ваш суд!

Выводы

Что ж, надеюсь, что вы дочитали материал до конца и усвоили разницу в понятиях искусственного интеллекта, машинного обучения, нейросетей и глубокого обучения.

Теперь мы понимаем, что распознавание образов, лиц, объектов, речи, вся робототехника и беспилотные устройства, машинный перевод, чат-боты, планирование и прогнозирование, машинное обучение, генерирование текста, картин, звуков и многое-многое другое — всё это искуственный интеллект, точнее, разновидности его воплощений. Если совсем коротко резюмировать наш сегодняшний материал, то:

  1. ИИ относится к устройствам, проявляющим в той или иной форме человекоподобный интеллект.
  2. Существует множество разных методов ИИ, но одно из подмножеств этого большего списка — машинное обучение — оно позволяет алгоритмам учиться на наборах данных.
  3. Нейронные сети — это разновидность алгоритмов машинного обучения, построенных по аналогии с реальными биологическими нейронами человеческого мозга.
  4. Ну и, наконец, глубокое обучение — это подмножество машинного обучения, использующее многослойные нейронные сети для решения самых сложных (для компьютеров) задач.

Сегодня мы с вами являемся, по сути, свидетелями рождения искусственного разума.

Только задумайтесь: ИИ применяется сейчас практически везде. Скоро даже в сельском туалете можно будет получить контекстную рекламу на основе ваших персональных рекомендаций. И это далеко не всё. ИИ уже проходит тесты на “человечность”, может заменять нам собеседника и создавать произведения искусства. Что же дальше? Создание общего и сильного ИИ и порабощение человечества?

Так все-таки ИИ — это хорошо или плохо? И главное — сделает ли ИИ нас бессмертными? Можно ли будет оцифровать сознание?

Состоялась премьера фильма Fellini Forward, снятого с помощью ИИ

В Венеции состоялась премьера «одного из неснятых фильмов Федерико Феллини», а в Москве — закрытый показ! Далее — Нью-Йорк и широкий показ.
aka_opex 11 сентября 2021 в 10:08

9 сентября в Москве состоялась премьера фильма Fellini Forward, который был снят с помощью искусственного интеллекта. В рамках премьеры российские режиссеры Кирилл Сребренников и Анна Меликян поделились своими мыслями о роли ИИ в кино. Широкая аудитория сможет увидеть фильм в октябре.

Интересно, что мировая премьера состоялась всего пару дней назад в рамках 78-го Венецианского кинофестиваля. Также короткометражку покажут 29 сентября на Нью-Йоркском кинофестивале.

В рамках проекта Campari Red Diaries 2021 было проведено масштабное исследование творчества легендарного итальянского режисеера, а позднее они были переосмыслены с помощью новых технологй и искусственного интеллекта и был создан фильм-зарисовка, которую мог бы снять Федерико Феллини в Риме. Также у Fellini Forward есть документальная часть, в которой эксперты рассказывают о проекте создания уникальной картины и рассуждают о будущем кинематографа.

Фильм вдохновлен жизнью Федерико Феллини и представляет собой метафоричную историю дебюта и творческого пути Маэстро в мире кинематографа, где публика сопровождает каждый его шаг: от первой искры в страстном юноше до выдающихся творений.

Проектом занималась студия UNIT9, которая проанализировала работы режиссера, чтобы понять важные детали сценариев, характерные речевые обороты, фирменные кадры и присущие героям выражения. На основе этих данных были разработаны алгоритмы машинного обучения, с помощью которых искусственный интеллект предложил варианты сценариев и визуальных элементов для нового короткометражного фильма, пронизанного тем самым ощущением Felliniesque.

Также в проекте приняли участие племянница Федерико Феллини — Франческа Фаббри Феллини и коллеги режиссера: оператор фильма «Клоуны» Бласко Джурато, художник-постановщик Данте Феррети, который принимал участие в съёмках фильма «Репетиция оркестра», «Город женщин», «И корабль плывает», «Джинджер и Фред», «Голос Луны», директор итальянского магазина-мастерской Sartoria Farani, где можно увидеть сохранившиеся костюмы из некоторых величайших фильмов Феллини Луиджи Пикколо. Они делились своими воспоминаниями о выдающемся режиссере.

DeepL Переводчик: Кажется, лучший переводчик в онлайне…

Глубокое машинное обучение и искусственный интеллект берут новую высоту: с их помощью сделали лучший переводчик в онлайне!
aka_opex 3 августа 2021 в 03:27

Компания DeepL, специализирующаяся в области машинного обучения, разрабатывает всевозможные системы искусственного интеллекта.

В 2017 году компания представила DeepL Переводчик — бесплатную систему машинного перевода, которая работает на высоком уровне.

Также есть предложение DeepL Pro — этот продукт новее и он предлагает профессиональный API и расширенные возможности для перевода онлайн.

Переводчик работает на 26 языках, переводит как отдельные части текста, так и целые файлы и и презентации. Также, кроме онлайн-версии, у DeepL переводчика есть еще и отдельные программы для Windows и Mac.

Мы его попробовали и знаете что? Он отлично работает и справляется с текстами разной сложности… И это бесплатно.

Не могли не поделиться с вами…


Искусственный Интеллект снял короткометражный фильм в духе Феллини

Федерико Феллини уже давно нет с нами, но с помощью современных технологий и машинного обчения, искусственный интеллект создал новый фильм маэстро.
roydroider 23 июля 2021 в 09:20

Как насчет того, чтобы применить искусственный интеллект и создать с помощью новых технологий и алгоритмов машинного обучения короткометражный фильм в двух великого Федерико Феллини? Именно такую нетривиальную задачу поставил себе бренд Campari и создал проект Fellini Forward в рамках компании Red Diaries. Cоздатели проекта переосмысливают работы одного из величайших кинорежиссеров в истории, используя методы искусственного интеллекта.

Документальный фильм о создании короткометражки будет представлен 7 сентября на Венецианском кинофестивале и 29 сентября на Нью-Йоркском кинофестивале.

Интересно, что Федерико Феллини при жизни пересекался с Campari — в 1984 году он создал рекламную кампанию. Спустя 37 лет появляется короткометражный фильм, посвященный жизни Феллини и его мечтам, а благодаря слаженному сотрудничеству человека и искусственного интеллекта, создателям картины удалось отразить уникальный авторский стиль режиссера.

Команда экспертов в области искусственного интеллекта из студии UNIT9 разработала инструменты, которые позволили исследовать творчество Федерико Феллини. С самого начала работы над проектом к его команде присоединилась племянница режиссера Франческа Фаббри Феллини. Именно она выступила в качестве консультанта проекта и представила  режиссера картины Максимилиана Нимана и авторов документального фильма коллегам Феллини. Франческа также приняла участие в кастинге, создании костюмов и написании сценария для короткометражного фильма.

На всех этапах проекта были задействованы члены съемочной группы, с которой работал Федерико Феллини в разные годы и на разных этапах своего творчества. Среди них — оператор Бласко Джурато («Клоуны», 1970), художник по костюмам и обладатель трех премий «Оскар» Данте Феррети («Репетиция оркестра», 1978; «Город женщин», 1980; «И корабль плывет…», 1983; «Джинджер и Фред», 1986; «Голос Луны», 1990), а также Луиджи Пикколо, директор прославленного итальянского ателье Sartoria Farani, в котором хранятся восстановленные костюмы из величайших фильмов Феллини, включая «Сатирикон» (1969), «Клоуны» (1970) и «Амаркорд» (1973). Именно они проследили, чтобы все  элементы фильма являлись по-настоящему «феллиниевскими» или по-итальянски «felliniesque».

Закари Канепари и Дреа Купер, участники режиссерского дуэта ZCDC, запечатлели процесс создания короткометражного фильма. Для этого они пригласили экспертов в области искусственного интеллекта и творчества Маркуса дю Сутуа и доктора Эмили Л. Спратт, а роль консультантов документального фильма предложили искусствоведу и исследователю творчества Феллини Хава Алдуби и куратору Galleria Campari Анита Тодеско. С их помощью в фильме отобразили разноплановые точки зрения на роль искусственного интеллекта в творчестве.

Премьера короткометражного фильма Fellini Forward и торжественная церемония состоятся 7 сентября на Венецианском кинофестивале, а 29 сентября картина будет представлена на Нью-Йоркском кинофестивале.

P.S. Так и хочется вспомнить слова песни группы Би-2: «В одном из неснятых фильмов Федерико Феллини…»

Google использует ИИ, чтобы создать дизайн чипов меньше чем за 6 часов

Обычно на этот процесс уходит не один месяц у людей, но искусственный интеллект позволяет драматически ускорить этот процесс.
aka_opex 14 июня 2021 в 10:42

Компания Google объявила о создании софта, который использует машинное обучение и искусственный интеллект для создания дизайн процессоров и чипов. Благодаря этому чип может быть создан всего за 6 часов. Для сравнения человеку требуются месяцы.

Интересно, что метод создания чипов описан в журнале Nature. «Наш метод мы использовали при разработке дизайна нового поколения Google TPU (тензорных процессоров)» — сказала глава отдела машинного обучения для систем Goole Азалия Мирхосейни.

По сути, ИИ рисует некий «план этажа» для более продвинутых систем, далее искусственный интеллект расставляет компоненты, включая CPU, GPU и ядра памяти. Именно на последний процесс «расстановки» у человека может уйти несколько месяцев поскольку инженеры должны продумать все ключевые характеристики, включая площадь чипа, энергопотребление и мощность, в то время как новая система обучения от Google натренирована на 10 тысячах всевозможных вариантов таких «планов этажей». За счет этого она может сделать работу меньше чем за 6 часов.

LaMDA: Новая технология машинного обучения в поиске

Google LaMDA — это новый шаг от Google в освоении возможностей искусственного интеллекта и машинного обучения. Теперь можно говорить с Плутоном.
aka_opex 18 мая 2021 в 08:42

Компания Google в рамках ключевого доклада на Google I/O 2021 показала новый необычный движок для перевода данных из Интернета в текст и даже речь — LaMDA. Этот движок работает на базе машинного обучения и изучает мультимодальные модели: текст, звук, видео и картинки, чтобы узнать различные факты по всевозможным поисковым запросам.

В частности Google продемонстрировал общение реального пользователя с планетой Плутон, которая рассказала факты о себе, или вопросы бумажному самолётику, который рассказал о самой лучшей конструкции и самом длинном полёте.

Крайне интересная технология на базе мобильного обучения, которая может помочь во многих сферах жизни.

Неизвестно, когда и каким образом будет доступен движок Google LaMDA и тем более будет ли он доступен в России.

Самый большой процессор в мире — Cerebras CS-1. Разбор

Сегодня мы расскажем вам про действительно большой процессор — самую большоую однокристалльную систему в мире. Почему это круто и как он работает?
Валерий Истишев 4 января 2021 в 02:43

Наверняка вы подумали, что это какой-то очередной кликбейт. Что это за самый большой процессор в мире? Похоже сейчас нам будут рассказывать о процессоре, который на 5 процентов больше других, и то если рассматривать этот процессор только с определенной стороны. И да просмотры и прочтения мы хотим собрать, но…

Сегодня мы расскажем вам о процессоре компании Церебро, под названием Cerebras CS-1. И он действительно огромный!

Например GPU, который считался самым большим раньше — это процессор Nvidia V100, а вот новый процессор Церебро. Он почти в 57 раз больше! Площадь самого чипа — 462 квадратных сантиметра — это почти столько же сколько площадь всей Nvidia 3090, вместе с системой охлаждения и разъемами.

А что вы скажете на то, что этот монстр способен симулировать некоторые физические модели быстрее самих законов физики? Заинтриговали? Что ж тогда присаживайтесь, наливайте чаек. Сегодня будет разбор по-настоящему огромного однокристального процессора!

Итак, что же это за монстр такой и зачем он нужен? Давайте сразу ответим на второй вопрос — этот процессор создан для машинного обучения и искусственного интеллекта. Кроме того он сильно расширит возможности для различного сложного моделирования и сможет заглядывать в будущее. Вообще, искусственный интеллект — это невероятно интересная и актуальная тема, а ее главные ограничения — это слабые вычислительные мощности. А если хотите узнать о реальных проектах с использованием искусственного интеллекта — у Илона Маска есть такой в запасе — Open UI.

Если вы думали, что закон Мура со своим увеличением количества транзисторов в процессоре каждые 1,5 года — это быстро, то посмотрите на потребности в области ИИ, ведь спрос на эти вычисления удваивается каждые 3,5 месяца!

Классический подход — это напихать кучу процессоров в серверные стойки, к каждому подвести систему охлаждения и питания, при этом каждый отдельный процессор еще надо связать друг с другом, а это, кстати, неизбежно вызывает задержки.

Скажем так — если вы возьмете двигатель от Ferrari и запихнете ее в старые Жигули, то машина конечно поедет быстрее, но как Ferrari все равно не поедет. Поэтому тут нужен принципиально иной подход, ведь для того? чтобы получить настоящий гиперкар надо взять хорошие тормоза, подвеску, рассчитать аэродинамику; с компьютерами точно также.

Компания Церебро это и сделала — они решили разработать свою систему с нуля, то есть вообще все — от архитектуры самих процессоров, до системы охлаждения и питания.

Это огромная машина, потребляющая 20 килоВатт, и занимающая треть стандартной серверной стойки, то есть можно размещать по три таких компьютера в одной стойке! А сам чип, по своей сути и предназначению, напоминает серверные GPU от NVIDIA, так что давайте их и сравним. Возьмем Nvidia Tesla V100.

Цифр много, приготовьтесь! Кроме размеров самого кристалла, процессор Церебро обладает четырьмя сотнями тысяч ядер, что в 78 раз больше, чем число ядер на NVIDIA Tesla V100! Количество транзисторов взрывает мозг — 1,2 триллиона, против 21 миллиарда у NVIDIA.

А сколько там памяти? 18 гигабайт l2 cash memory прямо на чипе! Это в три тысячи раз больше, чем у V100. Кстати у 3090 от той же NVIDIA, памяти на чипе тоже 6 мегабайт, прямо как у V100. Ну а про ширину полосы пропускания даже говорить страшно — у V100 это 300 Гигабит в секунду, а у Церебро — 100 ПЕТАбит в секунду. То есть разница в 33 тысячи раз!

А чтобы достичь схожей вычислительной мощности они заявляют, что нужна тысяча 100 карт NVIDIA, что суммарно будет потреблять в 50 раз больше мощности и занимать в 40 раз больше места — это очень значительная экономия электроэнергии и свободного пространства.

Это конечно прекрасно — цифры поражают. Но как удалось их достичь?

Суть именно в размере. Чип — большой, нет, даже огромный. Именнр это позволяет разместить столько всего на одном кристалле. И главное, что связь между элементами мгновенная, потому что не нужно заниматься сбором данных с разных чипов.

Однако, размер — это одновременно и главный недостаток Церебро.

Давайте по-порядку. Первое и главное — нагрев. Разработчики этого монстра прекрасно понимали, что они создают и какая система охлаждения нужна, поэтому она, как и сам процессор, были разработаны с нуля. Она представляет из себя комбинацию жидкостного охлаждения, которое направляется к охлаждаемым медным блокам! Охлаждающая жидкость проходя через мощный насос попадает в радиатор, где с помощью вентилятора происходит ее охлаждение, а горячий воздух уже выдувается наружу четырьмя дополнительными вентиляторами.

При потреблении 20 кВт, которые подаются через двенадцать разъемов питания, четыре уходит только на питание вентиляторов и насосов для системы охлаждения. Но в результате они достигли того, что чип работает при вдвое меньших температурах, чем стандартные GPU, что в конце концов повышает надежность всей системы.

Ну и конечно отдельно хочется сказать, что инженеры создали систему так, что она позволяет быстро менять почти любой компонент, что очень круто, так как в случае поломки — это уменьшает время возможного простоя.

Сам же чип собирает TSMC по, вы не поверите, 16 нанометровому техпроцессу. И тут вы можете справедливо возмутится. Как же так? Все уже делают чипы на 5 нм, какой смысл делать на древних 16 нм?

Тут то и скрывается вторая проблема. При производстве классических чипов, неизбежно бывает брак, который приводит к тому, что несколько чипов оказываются негодными и выкидываются или используются для других задач, и чем мельче тех процесс, тем выше процент брака. Но когда у тебя вся кремниевая подложка — это один чип, то любая ошибка в производстве приводит к тому, что всю пластину можно выкидывать. А при условии что одна пластина может изготавливаться несколько месяцев и стоит около миллиона долларов, что ж….

Суть в том, что ребята решили, как бы, подстраховаться. Ведь 16 нм техпроцессу уже почти семь лет: детали и тонкости при его производстве отлично изучены. Так сказать — уменьшают риски! Но стоит сказать, что уже ведется разработка и тестирование такого чипа на 7 нм, но его выход конечно будет зависеть от спроса на первое поколение! И там цифры просто огромные, только посмотрите на таблицу.

И тут вы можете справедливо заметить, что мы пока что ни слова не сказали о результатах, которых можно достичь с помощью этого монстра. Тут сложно, так как информация, в основном, закрытая, однако какие-то детали все равно просачиваются в медийное пространство.

Национальная лаборатория энергетических технологий Министерства энергетики США заявила, что CS-1 — первая система, которая смоделировала работу более миллиона топливных ячеек быстрее, чем в режиме реального времени.

Это означает, что когда CS-1 используется для моделирования, например, электростанции на основе данных о ее текущем состоянии, она может сказать, что произойдет в будущем быстрее, чем законы физики дадут такой же результат. Вы поняли? С помощью этого ПК можно заглянуть в будущее с высокой точностью, и если нужно подкорректировать и изменить его. И еще, например, в симуляции с 500 миллионами переменных Cerebras CS-1 уже обогнал суперкомпьютер Joule, занимающий 69-е место в рейтинге самых мощных суперкомпьютеров мира. Так что похоже со спросом проблем не ожидается.

Церебро планируется использовать для прогнозирования погоды или температуры внутри ядерного реактора или, например, проектирования крыльев самолета. Несомненно, лаборатории и различные исследовательские центры по всему миру найдут для Церебро области применени. Как вы понимаете, компьютер будет дорогим, но точная цена неизвестна.

Из открытых источников мы нашли только что в 2020 году в суперкомпьютерном центре Питтсбурга было куплено 2 компьютера Cerebras CS-1 за 5 миллионов долларов. Но система делается только под заказ и под каждого конкретного клиента, так что цена может варьироваться.

Выводы

Это явно уникальная система. И такого раньше никто не делал! Большинство производителей считают, что гораздо выгоднее и эффективнее наштамповать кучу маленьких процессоров, так как вероятность брака или поломки сильно падает и каждая ошибка сильно дешевле. Разработчики Церебро же решили пойти рискованным путем и, судя по тому, что процессор Cerebras CS-2 уже тестируют, их путь успешен.

И если все что они заявили — сбудется, то нас ждет абсолютно новая эра серверных вычислений, невероятные возможности для создания компьютерных моделей, новые мощности искусственного интеллекта. Нет сомнений, что и гиганты рынка, такие как Nvidia, Intel, Google, посмотрев на удачный опыт Церебро займутся разработкой своих огромных однокристальных систем. А вы только представьте, что будет если совместить это с квантовыми вычислениями, о которых мы недавно делали разбор? Ух!

Будем следить за развитием технологий, и продолжим дальше делать для вас такие интересные обзорные материалы про самые современные достижения!

PS. Кстати, лайк если поняли пасхалку в Церебро — ведь решетка радиатора выполнена в форме специальной сетки, которая используется в компьютерном моделировании для расчетов. Отсылка к предназначению Церебро!