Google разрабатывает революционный «замороженный» серверный чип: как это изменит индустрию искусственного интеллекта

Замороженные чипы Google и Taalas: как нейросеть встраивают в кремний, резко снижая энергопотребление и ускоряя ИИ-вычисления.
Павел Ельцов 22 августа 2026 в 12:45

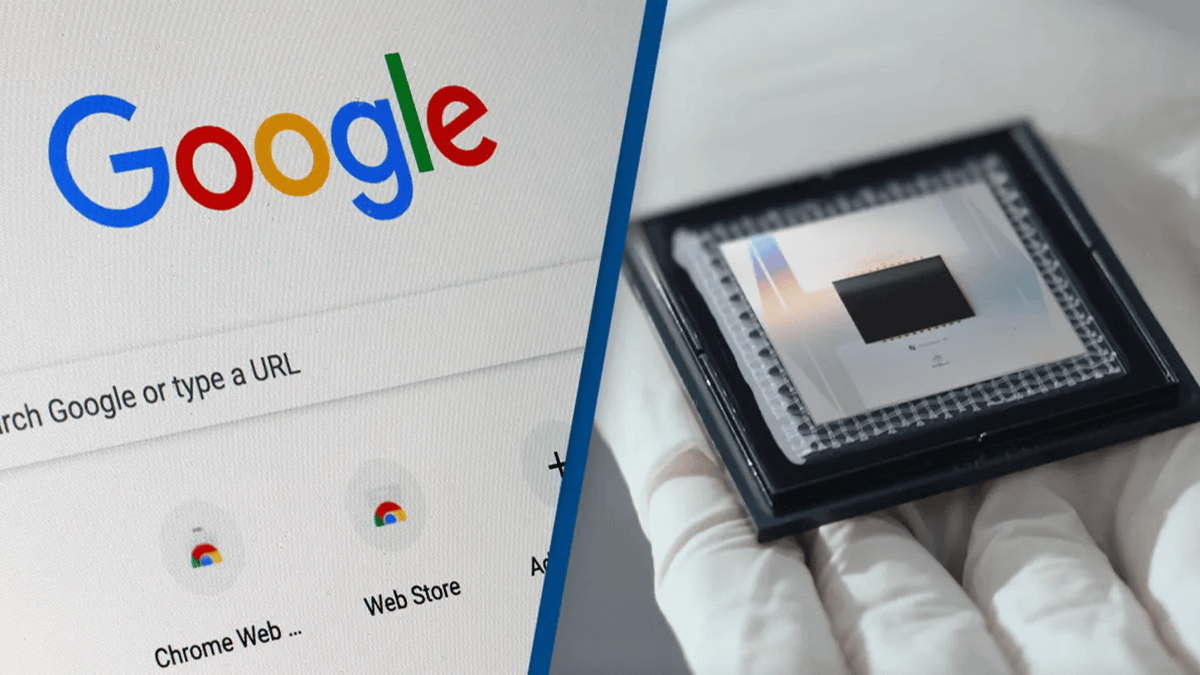
Издание The Information сообщило, что Google разрабатывает серверный чип под кодовым названием Frozen («замороженный»). Название может навести на мысль о жидком азоте и экстремальном охлаждении, но смысл совсем в другом. Речь не о температуре, а о том, что сама нейросеть в таком чипе буквально «застывает» в кремнии.

Обычные ускорители исполняют модель как программу: считывают её параметры из памяти, прогоняют через вычислительные блоки и выдают результат. Замороженный чип устроен иначе: модель перестаёт быть загружаемым набором чисел и становится частью физической структуры микросхемы.
Это не единичная идея Google, а целый класс технологий. Более того, Google здесь не лидер: по крайней мере в плане готового железа её уже опередили.

Канадский стартап опередил гигантов

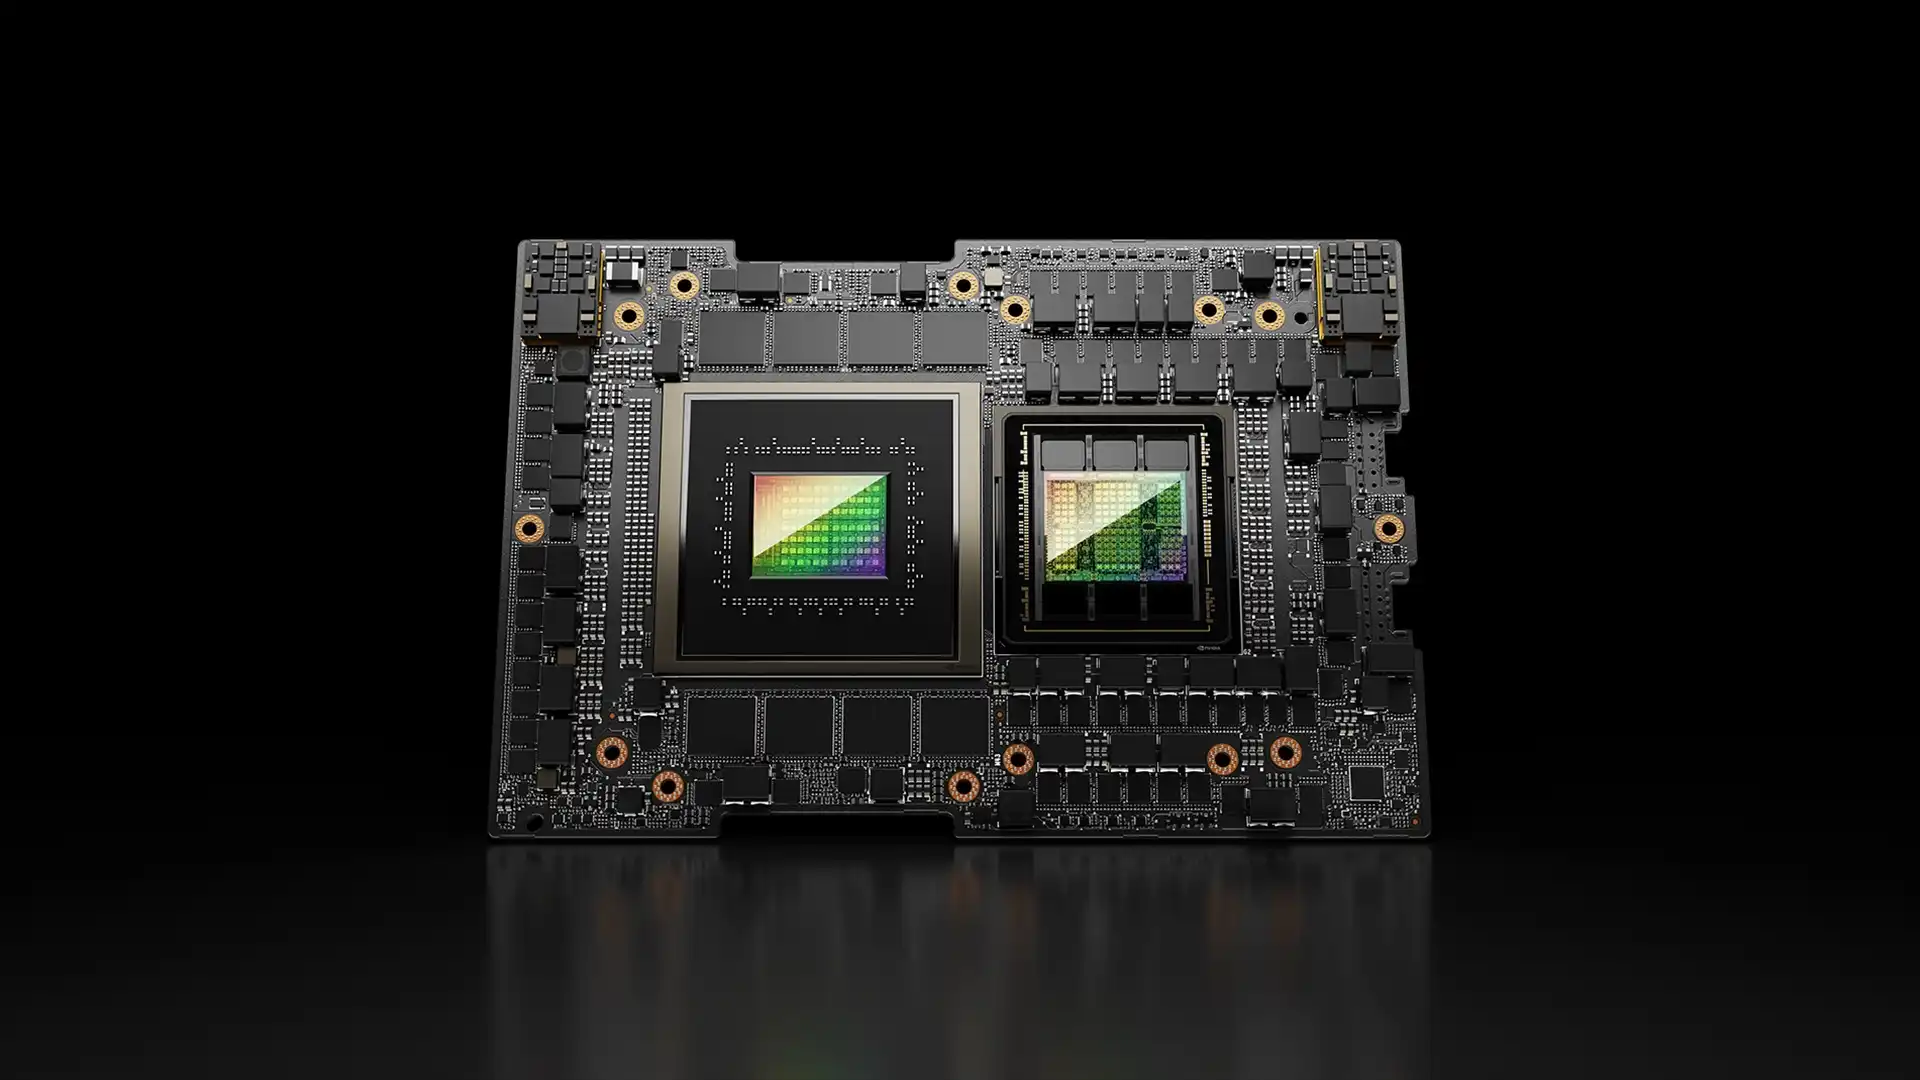
В феврале 2025 года канадская компания Taalas представила чип, в который физически встроена открытая модель.. По заявленным данным, он способен выдавать до 17 000 токенов в секунду. Для сравнения: ускорители Nvidia на той же модели обычно дают одному пользователю лишь несколько сотен токенов в секунду. Разница — почти на порядок и больше.
На первый взгляд это выглядит слишком хорошо, чтобы быть правдой, но у такого отрыва есть понятное физическое объяснение. Чтобы его понять, нужно разобраться в главной проблеме современных ИИ-ускорителей.

Главная проблема современных ускорителей: «стена памяти»

Почти все вычислительные системы построены на архитектуре фон Неймана: память отдельно, вычислитель отдельно. Данные нужно постоянно переносить из памяти в вычислительные блоки и обратно.

Десятилетиями это работало нормально, но с нейросетями ситуация изменилась. Когда языковая модель генерирует даже один токен, чипу приходится читать огромные массивы весов из памяти, перемещать их по кристаллу, выполнять операции, а затем повторять всё заново для следующего токена.

В результате значительная часть энергии уходит не на математику, а на доставку чисел к месту вычисления. Тысячи вычислительных ядер часто просто ждут очередную порцию данных.
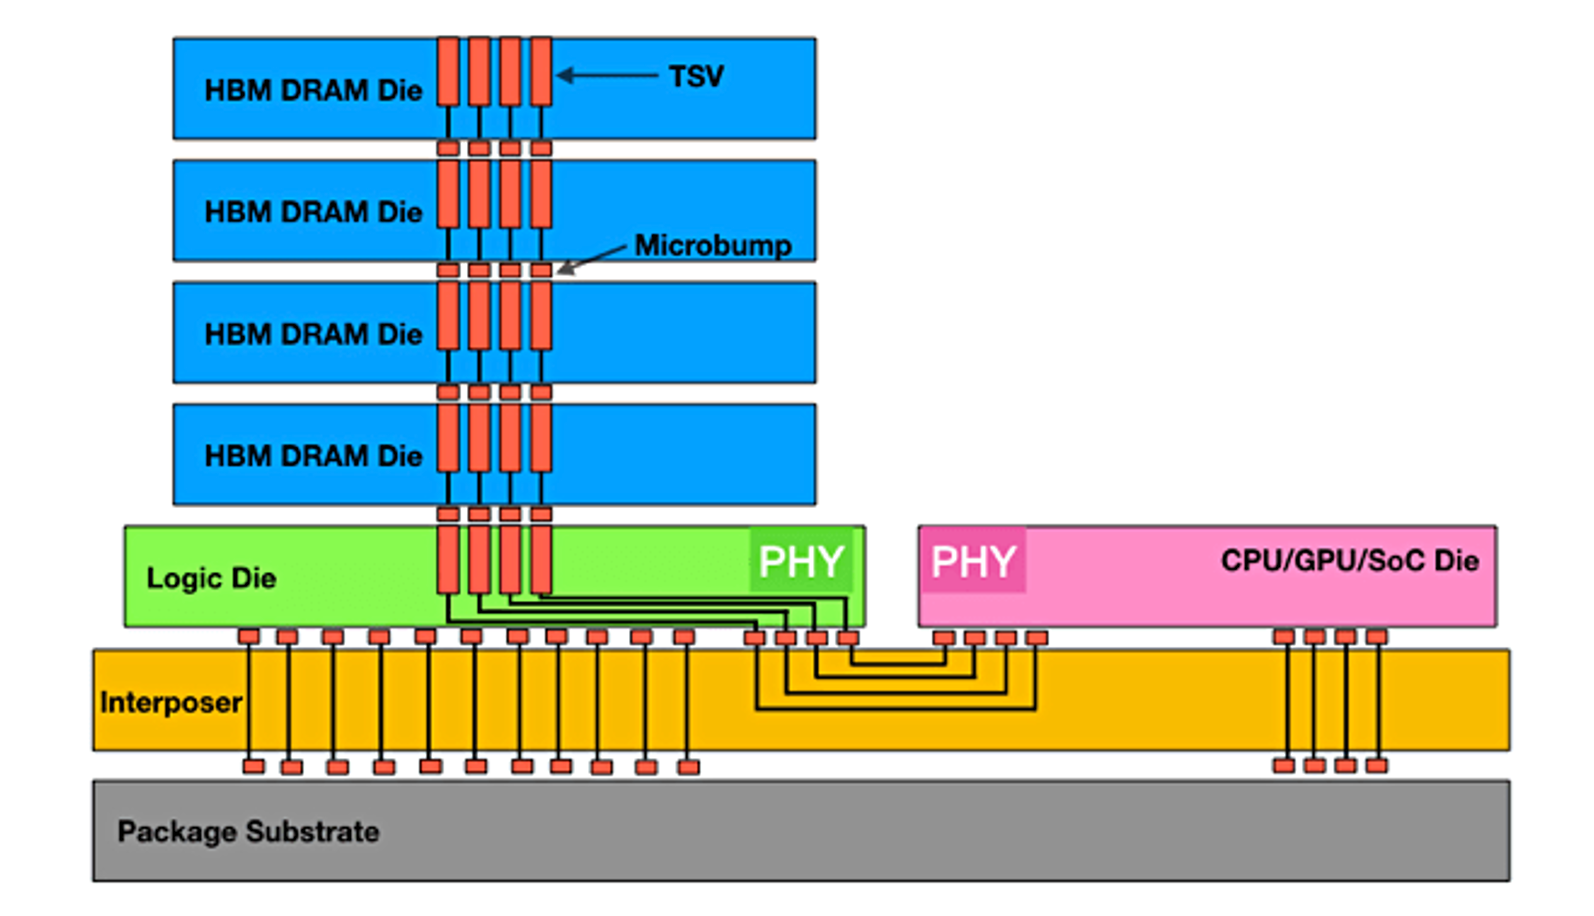
На физическом уровне это очень дорого. Передача одного бита из HBM-памяти в вычислительное ядро требует больше энергии, чем сама базовая операция умножения с накоплением. В масштабах серверов получается парадокс: львиная доля мощности расходуется не на вычисления, а на перемещение данных. Для GPU оценки доходят до 93–95% энергозатрат только на движение весов между памятью и вычислителем.

Именно этот предел и называют «стеной памяти».

Почему проблему не удаётся просто «залить железом»

Индустрия давно пытается пробить эту стену: появляются новые стандарты памяти вроде HBM4, растёт пропускная способность, усложняются архитектуры ускорителей. Но быстрее становится только сама «труба» — необходимость гонять данные туда-сюда никуда не исчезает.

Проблема усугубляется тем, что модели растут быстрее, чем ускоряется память. Каждый новый миллиард параметров — это ещё больше данных, которые нужно хранить и перемещать. Отсюда и гигантские расходы.

Alphabet, по данным на 2025 год, тратила на инфраструктуру десятки миллиардов долларов за квартал, а на 2026 год закладывала ещё более масштабные капвложения. И даже таких бюджетов оказалось недостаточно: вычислительных мощностей не хватает, а крупным клиентам облаков уже приходится ограничивать доступ к ресурсам.

У этого бума есть и побочный эффект для обычных пользователей: крупнейшие операторы дата-центров заранее выкупают огромные объёмы высокоскоростной памяти, из-за чего дефицит и рост цен постепенно расползаются по всему рынку.

Радикальная идея: а если веса вообще не перемещать?

Замороженный чип предлагает не ускорять доставку данных, а убрать саму необходимость доставки. Если веса модели неизменны, почему бы не сделать их частью аппаратуры?

К этой идее индустрия пришла не сразу. До неё были промежуточные подходы.

Подход Cerebras: разместить всё на одном гигантском чипе

Компания Cerebras решила проблему за счёт масштаба: если обращение к удалённой памяти дорого, нужно разместить как можно больше памяти прямо на кристалле. Их WSE-3 хранит модель во внутрикристалльной памяти объёмом 44 ГБ, а внутренняя пропускная способность достигает 21 ПБ/с.

Плюс очевиден: не нужно постоянно обращаться к внешней памяти. Минус тоже очевиден: это работает только до тех пор, пока модель помещается в доступный объём. Для действительно огромных моделей такой подход быстро упирается в физические пределы.

Подход Groq: убрать хаос и сделать всё предсказуемым

Компания Groq пошла другим путём. Обычные процессоры и GPU тратят часть ресурсов на планирование, выбор инструкций, работу кэшей и распределение задач на лету. Groq отказалась от этой универсальности и заранее определяет маршруты движения данных ещё на этапе компиляции.
Это резко снижает стоимость передачи бита: примерно до 0,3 пикоджоуля против около 6 пикоджоулей у HBM. Но даже здесь чип остаётся программируемым процессором, который всё ещё исполняет модель.

Следующий шаг: модель как часть железа

Логика замороженного чипа проста: веса обученной модели не меняются от запроса к запросу. Если так, то зачем снова и снова таскать их из памяти в вычислитель? Почему бы не превратить сами веса в элемент физической схемы? Именно это делает Taalas.

Как устроен HC1 от Taalas

Первый чип компании называется HC1. Это огромный кристалл площадью около 850 мм², произведённый по техпроцессу TSMC 6 нм, с 53 миллиардами транзисторов.
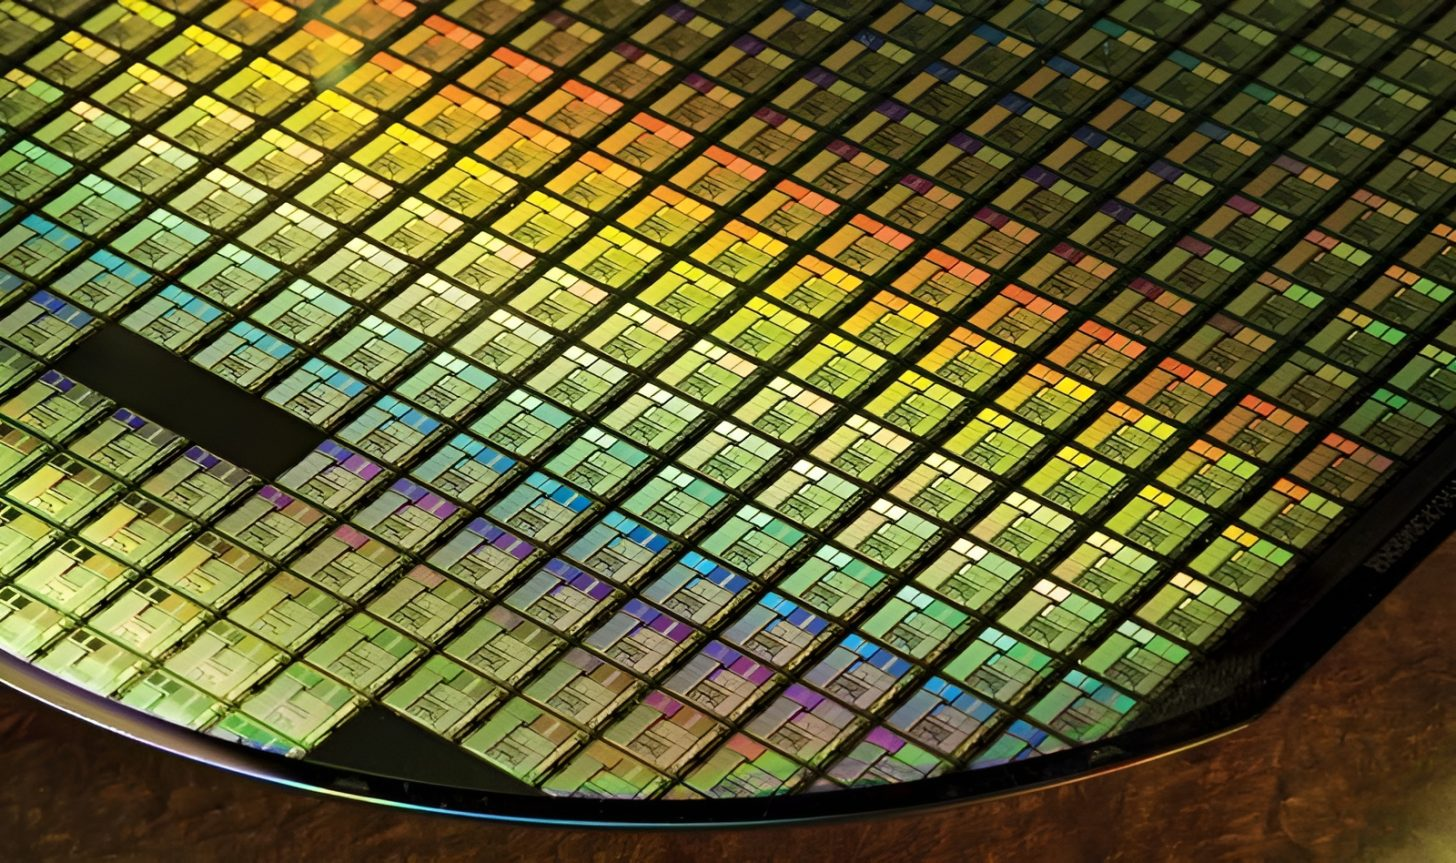
Главное в HC1 — даже не то, что в нём есть, а то, чего в нём нет:

  • нет HBM-памяти;
  • нет сложных межчиповых интерфейсов;
  • нет привычной архитектуры ускорителя с постоянной перекачкой весов.

По сути, остаётся только то, что нужно для ввода промптов и работы с контекстом, например PCI Express. В сравнении с обычным ИИ-ускорителем это выглядит так, будто из автомобиля убрали бак, бензонасос и топливопровод, а он всё равно едет.

Где в таком чипе хранятся веса

Веса модели записываются в масочное ПЗУ. В обычной памяти информация хранится как электрический заряд, который нужно поддерживать или регулярно обновлять. В HC1 веса представлены иначе: как наличие или отсутствие микроскопических металлических соединений в верхних слоях кристалла.

Иными словами, знания модели существуют не как файл и не как заряд в ячейке памяти, а как геометрия металла. Модель буквально становится узором проводников внутри чипа.

Как удалось избежать полного перепроектирования под каждую модель

Логичный вопрос: если под каждую модель нужен свой рисунок проводников, не придётся ли каждый раз делать новый чип с нуля?
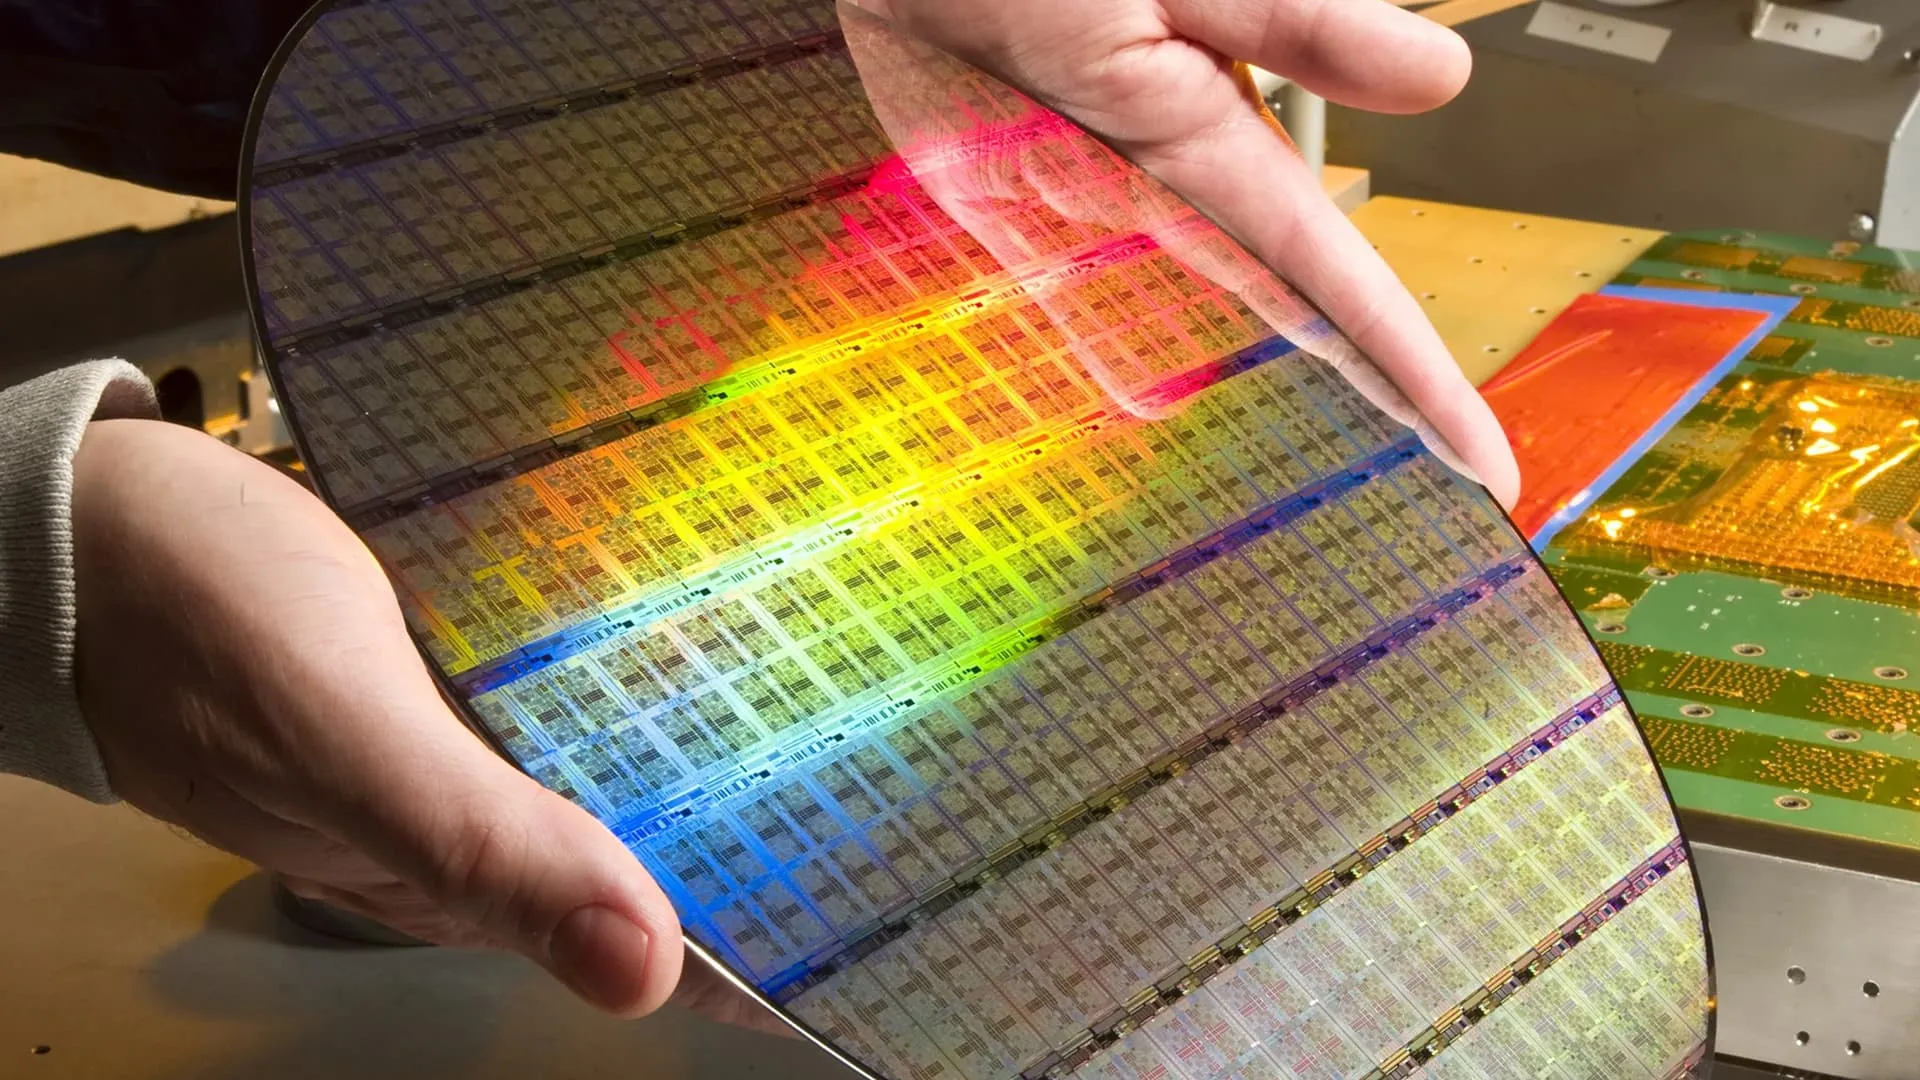
В этом и состоит главный инженерный трюк. Базовая кремниевая подложка остаётся универсальной и выпускается массово. Меняются только два верхних металлических слоя, где и задаётся конкретная модель. То есть из многих слоёв кристалла специализированными становятся лишь последние.

Это всё ещё дорого, но уже не так радикально, как полное перепроектирование всей микросхемы.

Как происходят вычисления

В обычных GPU умножитель универсален: ему можно подать любые два числа. Но за эту универсальность приходится платить транзисторами, энергией и сложностью.

В HC1 веса известны заранее и жёстко квантованы до 3 бит, то есть у каждого веса всего 8 возможных значений. Поэтому вместо полноценного умножения используется более дешёвая схема multiply-select-add:

  1. входная активация заранее умножается на все 8 возможных значений веса;
  2. система выбирает нужный вариант;
  3. результат отправляется на суммирование.

То есть чип не столько «вычисляет», сколько выбирает готовый вариант, соответствующий зафиксированному в металле весу. Умножение как универсальная операция фактически заменяется селекцией.

Что происходит с контекстом

Разумеется, не всё в диалоге можно зашить в металл. Контекст разговора постоянно меняется, и его нужно где-то хранить. Для этого на кристалле остаётся обычная SRAM, где размещаются:

  • KV-кэш текущего диалога;
  • служебные данные;
  • вспомогательные операции вроде нормализации и активаций.

Граница очень чёткая: всё постоянное — в металле, всё изменяемое — в памяти.

Как решается проблема кастомизации под бизнес

Ещё одно очевидное возражение: компаниям редко нужна «голая» базовая модель. Им нужны версии, дообученные под юридические тексты, медицину, документооборот и другие прикладные задачи.

Здесь помогает LoRA. Базовая модель остаётся зафиксированной в кремнии, а небольшие адаптеры размером в десятки или сотни мегабайт загружаются в перезаписываемую память. Благодаря этому один и тот же чип может быстро переключаться между специализированными сценариями, не меняя фундаментальную основу.

Почему это так впечатляет

Заявленные характеристики HC1 выглядят очень агрессивно:

  • 250 Вт энергопотребления;
  • обычное воздушное охлаждение;
  • 16–17 тысяч токенов в секунду.

Для сравнения, H100 на той же модели даёт около 150 токенов в секунду и потребляет 300–400 Вт, причём без полного учёта затрат на HBM и охлаждение. Даже если относиться к цифрам осторожно, разрыв всё равно выглядит огромным.
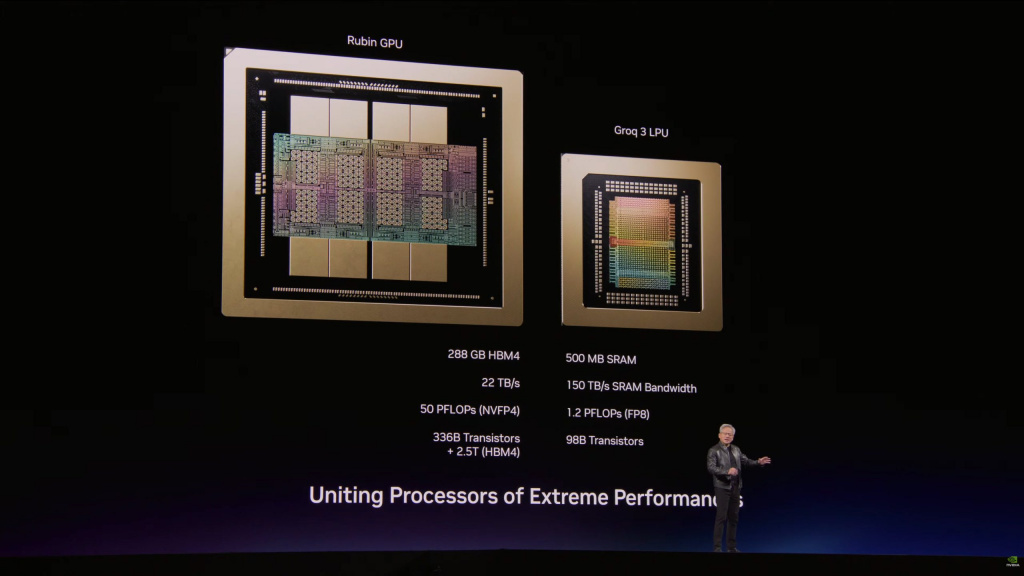
Ещё показательнее метрика джоули на токен. Универсальные системы на H100 тратят примерно 10–30 Дж на токен. У Groq это около 1 Дж. У HC1 — порядка 0,1 Дж. То есть выигрыш уже не просто в скорости, а в фундаментальной энергоэффективности.

Насколько велик теоретический запас

С точки зрения физики это ещё далеко не предел. Существует фундаментальная нижняя граница энергозатрат на изменение одного бита — принцип Ландауэра. Современные вычислительные системы всё ещё работают на много порядков выше этого порога.
Иными словами, нынешние серверы для ИИ по эффективности всё ещё находятся очень далеко от физического минимума. На этом фоне замороженные чипы выглядят не просто инженерной хитростью, а попыткой приблизиться к более естественной форме вычислений.

Практический плюс: простота внедрения

Если убрать из ускорителя HBM, 3D-упаковку, сложные межчиповые интерфейсы и жидкостное охлаждение, получается устройство, которое гораздо проще ставить в обычные дата-центры.
Именно поэтому идея так привлекательна: вместо экзотической инфраструктуры можно получить PCIe-карту на 250 Вт, которая не требует радикальной переделки стойки, питания и охлаждения.

История проекта Google

У Google у этой идеи есть внутренняя история. Её связывают с Джеффом Дином, одним из ключевых архитекторов инфраструктуры машинного обучения в компании.
Первая версия проекта Frozen была даже радикальнее подхода Taalas: предполагалось жёстко печатать в кремнии не только структуру сети, но и сами веса Gemini. Это дало бы максимум эффективности, но руководство проект не одобрило. Причина понятна: новые версии модели появляются слишком быстро, и чип рисковал устареть ещё до массового запуска.

Frozen V2: компромисс между жёсткостью и гибкостью

После этого появился Frozen V2 с идеей Flexible Hard Coding. В этой версии в кремнии фиксируют не сами веса, а архитектурный каркас модели: вычислительный граф, маршруты данных, специализированные блоки под механизмы внимания. А сами веса остаются обновляемыми.
Это позволяет выпускать новые версии Gemini без полной замены железа — но только если базовая архитектура модели не меняется слишком сильно.

Именно здесь и скрыт главный риск: чип окажется полезным лишь до тех пор, пока отрасль и сама Google продолжают использовать примерно тот же фундаментальный подход.

Ограничения Frozen V2

У такого компромисса есть серьёзные ограничения:

  • чип не сможет запускать сторонние открытые модели;
  • он будет привязан к определённому семейству архитектур;
  • если произойдёт серьёзный прорыв и рынок уйдёт от нынешних трансформеров, специализированный кремний может быстро устареть.

По данным из утечек и публикаций, первые кластеры с Frozen V2 могут появиться около 2028 года, но внутри самой Google дискуссия, похоже, ещё не закончена. Компания пытается найти баланс между максимальной эффективностью и риском слишком раннего устаревания.

Frozen не заменит TPU и GPU полностью

Важно понимать: Frozen V2 не рассматривается как универсальная замена традиционным ускорителям. Скорее, это сопроцессор для узкого класса задач — прежде всего для быстрой генерации токенов на стабильной архитектуре Gemini.
Всё нестандартное, экспериментальное и меняющееся останется на обычных TPU и других программируемых чипах. Frozen — это ставка на те участки вычислений, где поведение модели уже достаточно предсказуемо, чтобы его было выгодно зашить в железо.

Четыре серьёзных недостатка технологии

1. Потеря точности

Чтобы уместить огромную модель в один кристалл, веса приходится жёстко сжимать. Основная масса кодируется 3 битами, критичные параметры — 6 битами. Это очень агрессивное квантование.

Проблема в том, что ниже 4 бит часто начинается так называемый accuracy cliff — резкий обрыв качества. Особенно страдают сложные задачи: длинные рассуждения, математика, программирование. Для простого разговора деградация может быть умеренной, но на интеллектуально тяжёлых сценариях она становится заметнее.

2. Низкий выход годных

HC1 — это очень большой кристалл, почти на физическом пределе литографии. Чем больше площадь, тем выше вероятность дефекта.

В памяти дефекты часто обходят резервными строками и столбцами. В масочном ПЗУ с жёстко заданной топологией это сделать намного труднее: если повреждён участок с критической логикой модели, кристалл может оказаться бесполезным. Значит, производство таких чипов потенциально дорогое и капризное.
3. Ограничение по размеру модели

Модель на 8 млрд параметров ещё можно вместить в один кристалл. Но более крупные модели, например на 70 млрд параметров, уже придётся разрезать на несколько кристаллов.

А вместе с этим возвращается та самая проблема, от которой технология пыталась уйти: межчиповый обмен данными. Он всё равно дешевле обращения к внешней памяти, но это уже не тот идеальный случай, где ничего никуда не перемещается.

4. Риск быстрого устаревания

Разработка заказного чипа занимает годы, а ИИ меняется почти ежемесячно. Если через пару лет индустрия перейдёт на принципиально новую архитектуру, замороженный кремний может устареть быстрее, чем успеет окупиться.

Именно поэтому универсальные ускорители по-прежнему сохраняют огромную ценность: они медленнее и менее эффективны, зато переживают смену поколений моделей.

Почему универсальность всё ещё важна

Можно возразить: не проще ли оставить всё на универсальных GPU и TPU? Их главный плюс как раз в том, что они способны адаптироваться под любой новый алгоритм. Появится новая архитектура — они её тоже запустят, пусть и без максимальной эффективности.
Поэтому вопрос не в том, нужна ли специализация вообще. Вопрос в том, сколько гибкости рынок готов отдать в обмен на выигрыш в энергии и цене вычислений.

Что будет, если технология приживётся

Если замороженные чипы станут массовыми, себестоимость ИИ-вычислений может упасть на порядки. Это откроет путь к более дешёвым и даже бесплатным сервисам на базе мощных моделей, не превращая обслуживание в бездонную статью расходов для облачных платформ.

Агенты и машинное взаимодействие

Человеку не нужны десятки тысяч токенов в секунду — мы просто не успеем их прочитать. Но такая скорость нужна машинам, которые обмениваются сообщениями друг с другом.

Если один агент ставит задачу второму, второй проверяет третьего, а затем вся цепочка возвращает результат пользователю, то внутренняя коммуникация должна укладываться в доли секунды. Здесь сверхбыстрые специализированные чипы особенно полезны.

Локальные модели в смартфонах

Если такие архитектуры научатся делать компактными и холодными, часть больших языковых моделей сможет перебраться прямо в пользовательские устройства — смартфоны, ноутбуки, бытовую электронику. Тогда ИИ будет работать локально: без облака, без задержек, без постоянной подписки и без отправки данных наружу.

Итог

Замороженные чипы — это радикальный отход от классической архитектуры фон Неймана. Они превращают нейросеть из программы в физическую структуру, тем самым устраняя фундаментальную проблему современной ИИ-инфраструктуры — дорогую и прожорливую перевозку данных между памятью и вычислителем.

Taalas уже показала рабочий пример такого подхода. Google разрабатывает собственную версию Frozen V2, рассчитывая развернуть первые системы примерно к 2028 году. Если идея выстрелит, она может заметно изменить экономику ИИ и весь подход к серверным вычислениям.

Но у технологии есть и серьёзные слабые места: потеря точности из-за жёсткого квантования, сложность производства, ограничения по размеру моделей и риск быстрого устаревания на фоне стремительной эволюции архитектур.

Дойдут ли замороженные чипы до массовых серверов? Появятся ли когда-нибудь в смартфонах? Пока неясно. Но одно уже видно: в энергоэффективности ИИ мы всё ещё в начале большого пути, и потенциал улучшений здесь колоссальный.


Яндекс проведёт конференцию Deep Tech Night с бывшим директором Google X

В Москве 5 сентября пройдет Deep Tech Night, посвящённая вызовам, с которыми ИТ-индустрия сталкивается в эпоху ИИ. Конференцию проведет Яндекс.
aka_opex 12 августа 2026 в 04:20

В московском офисе Яндекса пройдёт конференция Deep Tech Night, посвящённая вызовам, с которыми ИТ-индустрия сталкивается в эпоху ИИ. Мероприятие будет доступно онлайн и пройдет 5 сентября.

Одним из ключевых спикеров станет Мо Гавдат — бывший директор по развитию бизнеса Google X, исследовательской лаборатории Google. Он расскажет о том, как генеративные нейросети меняют роль разработчика и как могут эволюционировать инженерные команды.

В программе также выступления специалистов Яндекса. Алексей Гусаков, руководитель управления машинного интеллекта и исследований, разберёт устройство рекомендательных систем. Иван Сапожков из команды базовой ML-инфраструктуры поговорит о балансе между алгоритмами и производительностью в обучении с подкреплением для больших моделей. Сергей Мельник, руководитель сервиса автономного транспорта и роботов, расскажет о физическом ИИ — системах, принимающих решения в реальном мире, и о роли симуляции в их разработке.
Gemini от Google: ИИ, который будет работать внутри Pixel 8 Pro

Google Gemini — новейшая модель искусственного интеллекта, которую можно будет запустить даже на смартфонах Pixel 8 Pro.
aka_opex 7 декабря 2023 в 05:41

Google Gemini —это новая модель искусственного интеллекта, которая обучена распознавать, понимать и комбинировать различные типы информации, включая текст, изображения, аудио, видео и код. При этом, по словам разработчиков, она еще и самая способная.

Новая модель искусственного интеллекта Google описывается как самая гибкая на сегодняшний день. Более того она способна работать, как на портативных устройствах вроде Google Pixel 8 Pro, так и в центрах обработки данных. Gemini 1.0 разделена на три версии, чтобы соответствовать различным потребностям.

Ultra — самая крупная и самая мощная из моделей, предназначенная для выполнения очень сложных задач. Именно она, скорее всего, будет использоваться в вышеупомянутых центрах обработки данных.

Pro — версия среднего уровня, предназначенная для решения широкого круга задач.

Nano — самая эффективная версия Gemini от Google, предназначенная для работы на таких устройствах, как смартфоны. Именно она начинает появляться на смартфонах Pixel 8 Pro с обновлением.

Google в своем блоге: «С результатом 90,0 % Gemini Ultra стала первой моделью, превзошедшей человеческих экспертов в MMLU (массивное многозадачное понимание языка), в котором используется сочетание 57 предметов, таких как математика, физика, история, право, медицина и этика, для проверки знаний о мире и способности решать проблемы».

Google утверждает, что Gemini более совершенен, чем типичные модели ИИ, потому что они могут быть хороши в выполнении конкретных задач, но в в более концептуальных и сложных рассуждениях у них есть проблемы. Gemini является мультимодальным, что означает, что он был создан с нуля и с самого начала обучался на нескольких моделях, что позволяет ему, как утверждает Google, понимать и рассуждать на основе различных входных данных.

Gemini способен понимать текст, изображения, аудио и многое другое, а также анализировать несколько типов данных одновременно, чтобы лучше понимать контекст и нюансы информации.

Google Gemini уже запустился, он внедрен в Bard в версии Pro, а также в Google Pixel 8 Pro в версии Nano. Gemini Ultra будет запущен в начале следующего года. Модель ИИ также будет доступна в Google AI Studio и Cloud Vertex AI с 13 декабря.

На Pixel 8 Pro Gemini присоединяется к ряду новых обновлений, включая возможность ночной съемки Night Sight Video. К этой функции добавилось то, что Google называет Video Boost, которая загружает видео, снятое на устройстве, в облако, где вычислительные модели корректируют цвет, освещение, стабилизацию и шум, чтобы кадры выглядели более реалистично.

Улучшение Portrait Light в Google Photos устраняет резкие тени на фотографиях, даже если они были сделаны на старых устройствах. Функция Photo Unblur также получила обновление и теперь лучше повышает резкость изображений собак и кошек, даже если они находятся в движении.

На Pixel 8 Pro Google особо отмечает, что Gemini Nano будет работать с такими новыми функциями, как Summarize в приложении Recorder, а также Smart Reply в Gboard. Эти функции будут доступны в WhatsApp сразу же, а в другие приложения придут в следующем году.

iPhone начудил: девушка не узнала себя в отражениях

iPhone и вычислительная фотография заставили девушку паниковать: на фото она стоит в одной позе, а ее отражения в другой.
aka_opex 21 ноября 2023 в 03:10

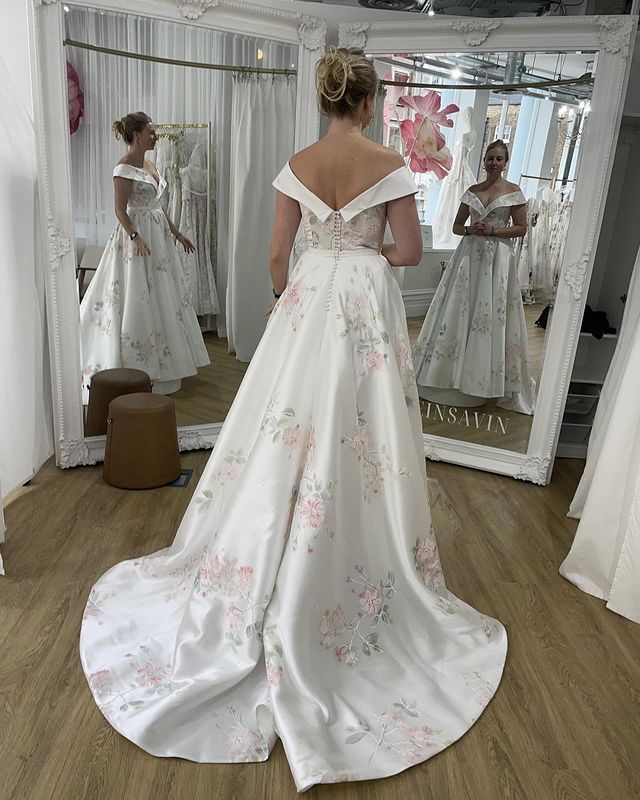
Девушка не узнала себя на фото, сделанном на iPhone. Снимок был сделан в свадебном салоне и в отражениях все выглядит не так как в жизни.

Тесса Коутс (так зовут невесту) стоит перед двумя большими зеркалами и отражение не соответствует позе, которую она принимает. Мало того, оба отражения отличаются друг от друга и от позы, в которой Коутс находилась на самом деле.

В то время как Коутс держала правую руку полусогнутой, а левую опустила, в отражении слева мы видим, что обе руки внизу, причем чуть расправлены. В то же время в отражении справа обе руки подняты и находятся на уровне пояса.

“Я посмотрела на фотографию, и у меня случился приступ паники на улице”, — пишет она в социальных сетях.

Но девушка решила знать, что же произошло и отправилась в магазин Apple. Там техник по имени Роджер объяснил ей, что “iPhone — это не фотоаппарат, а компьютер”.

Роджер сообщил Тессе, что она двигала руками, когда камера делала серию снимков слева направо, и на каждой стороне снимка получалось разное изображение.

“Итоговое фото — решение искусственного интеллекта. Он сшил две фотографии вместе”, — сказал Роджер.

Специалист Apple отметил, что после того, как Google выпустила смартфоны серии Pixel 8, который делает несколько фотографий и выбирает лучшие из них, Apple проводит бета-тестирование аналогичной функции.

Однако Роджер добавил, что случай, произошедший в магазине свадебных платьев, — “один на миллион”.

За последние годы смартфоны добились огромных успехов в области качества фотографий, однако значительные улучшения не могут быть связаны с развитием аппаратного обеспечения. Наибольшее влияние на качество снимков смартфонов оказала вычислительная фотография, о которой мы писали в нашей статье.

Люди могут не знать об этом, но когда они делают снимок, смартфон на самом деле делает несколько фотографий и выбирает лучшие элементы за очень короткое время.

ChatGPT появится на Android на следующей неделе

ChatGPT от OpenAI уже есть на iPhone, пора отдельному приложению появится и на Android.
aka_opex 24 июля 2023 в 05:29

Компания OpenAI объявила о долгожданном запуске ChatGPT для Android. Анонс состоялся через несколько месяцев после успешного старта версии для iOS, которая быстро стала лучшим AI-приложением на платформе, получив более полумиллиона загрузок в течение недели. Официальная версия ChatGPT для Android будет доступна в Google Play Store на следующей неделе, предварительная регистрация уже открыта.

Появление официальной версии для Android должен помочь в борьбе с фейковыми GPT-приложениями, заполонившими рынок. До сих пор неофициальные приложения использовали преимущества экосистемы Android, а некоторые из них содержали вредоносный или мошеннический контент.

Подобно своему аналогу для iOS, версия ChatGPT для Android, скорее всего, будет иметь региональные ограничения: первоначально она будет запущена в США, а затем распространится на другие страны. Приложение будет предлагать премиум-услугу ChatGPT Plus стоимостью 20 долларов в месяц.

ChatGPT для Android призван обеспечить опыт, схожий с его аналогом для iOS, включая возможность синхронизации разговоров и предпочтений на разных устройствах. Хотя точная дата запуска не раскрывается, компания подтвердила, что развертывание начнется на следующей неделе.

Кроме того, OpenAI работает над новой функцией “индивидуальные инструкции”, предназначенной исключительно для пользователей тарифного плана Plus, которая в настоящее время находится на стадии бета-тестирования. Эта функция позволит пользователям давать чат-боту с искусственным интеллектом конкретные инструкции, что повысит уровень персонализации. Кроме того, в приложении будут реализованы последние усовершенствования версии для iOS, включая интеграцию с Bing и улучшенную функцию поиска по истории.

Пользователи Android уже могут пройти предварительную регистрацию на приложение ChatGPT в магазине Google Play. Буквально на прошлой неделе появилось сообщение о том, что ChatGPT впервые с момента запуска столкнулся с падением трафика. Запуск приложения на платформе Android, скорее всего, снова повысит его посещаемость.

Amazon Bedrock — еще один игрок ИИ и нейросетей

Еще один игрок на рынке ИИ-ботов. На этот раз от Amazon. Удивительно, что Apple ничего не делает…
aka_opex 14 апреля 2023 в 07:34

Технологии ИИ продолжают захватывать интернет. В настоящее время ChatGPT лидирует в этой гонке, опережая своих конкурентов со значительным отрывом. Тем временем такие технологические гиганты, как Google, прилагают все усилия, чтобы догнать инновационную технологию OpenAI. Недавно к списку компаний, работающих в области ИИ, присоединилась компания Amazon. Они объявили о запуске Bedrock, нового облачного сервиса на платформе Amazon Web Services (AWS), предназначенного для предоставления разработчикам настраиваемых инструментов ИИ для генерации текста и изображений.

Целью Bedrock является предоставление разработчикам настраиваемых инструментов ИИ для генерации текста и изображений. Сервис призван стать облачной альтернативой ChatGPT и DALL-E 2 от OpenAI и предназначен для компаний и разработчиков, желающих создавать приложения с использованием генеративных моделей ИИ.

Bedrock позволяет клиентам AWS получить доступ к ряду моделей ИИ для различных задач, таких как написание текстов, создание чат-ботов, резюмирование текста и классификация изображений на основе текстовых подсказок. Он предлагает выбор базовых моделей, включая Titan от Amazon, а также модели от различных стартапов. Среди них — модель Claude от Anthropic, конкурент ChatGPT, поддерживаемый Google; языковая модель Jurassic-2 от AI21, специализирующаяся на европейских языках; и Stable Diffusion, популярный генератор изображений с открытым исходным кодом.

Чтобы решить проблему конфиденциальности, Amazon заявила, что не будет использовать пользовательский ввод для обучения моделей. Это гарантирует, что предприятия, вводящие конфиденциальные данные, смогут сохранить их конфиденциальность при использовании услуг Bedrock. Компания уделяет особое внимание предоставлению разнообразных моделей ИИ, чтобы дать клиентам больше гибкости в выборе подходящего инструмента для своих нужд. Согласно официальному описанию Amazon, «Благодаря бессерверному опыту Bedrock вы можете быстро приступить к работе, в частном порядке настроить ИИ с помощью собственных данных, а также легко интегрировать и внедрить их в свои приложения, используя знакомые вам инструменты и возможности AWS».

Генеральный директор Amazon Энди Джасси подчеркнул ценность Bedrock для бизнеса в недавнем интервью CNBC: «Большинство компаний хотят использовать эти большие языковые модели, но действительно хорошие модели требуют миллиардов долларов для обучения и многих лет, и большинство компаний не хотят проходить через это. Поэтому они хотят работать на основе фундаментальной модели, которая уже большая и отличная, а затем иметь возможность адаптировать ее для своих целей. Именно это и есть Bedrock».

Нейросеть Kandinsky 2.1: 2 миллиона уникальных пользователей меньше чем за неделю

Меньше чем за неделю нейросеть Kandinsky 2.1 обошла ChatGPT и стала самым быстрорастущим сервисом в мире: 2 миллиона пользователей и 10 миллионов изоб
aka_opex 12 апреля 2023 в 04:53

Kandinsky 2.1 — бесплатная генеративная модель от Сбера стала одним их самых быстрорастущих сервисов искусственного интеллекта (ИИ) в мире. По данным разработчиков, нейросети потребовалось всего четыре дня, чтобы достичь отметки в 1 миллион уникальных пользователей. Это быстрее результата сервиса ChatGPT от OpenAI, которому потребовалось на это пять дней.

Нейросеть Kandinsky 2.1: 2 миллиона уникальных пользователей меньше чем за неделю

С момента выхода Kandinsky 2.1 было сгенерировано более 10 млн изображений, а количество уникальных пользователей достигло 2 млн. Также, на прошлой неделе модель Kandinsky 2.1. попала в топ-5 трендов мировых репозиториев по версии крупнейшего веб-сервиса GitHub.

Kandinsky 2.1 способна за несколько секунд генерировать изображения по их текстовому описанию на естественном языке. Модель знает 101 язык и открывает новые возможности для творчества: может смешать несколько рисунков, дорисовать изображение, создать картину в режиме бесконечного полотна (inpainting/outpainting).

Нейросеть разработали и обучили исследователи Sber AI при партнёрской поддержке учёных из Института искусственного интеллекта AIRI на объединённом датасете Sber AI и компании SberDevices.

Нейросеть унаследовала веса предыдущей версии, обученной на один миллиард пар «текст — изображение», и была дополнительно обучена на 170 млн пар «текст — изображение» высокого разрешения. Затем она дообучалась на отдельно собранном датасете из двух миллионов пар качественных изображений.

В данный сет попали картинки с описаниями в таких традиционно сложных для нейросетей областях, как тексты и лица людей. Нейросеть также была усовершенствована за счёт новой обученной модели автоэнкодера, которая используется в том числе в качестве декодера векторных представлений изображений. Это кардинально улучшило генерацию изображений в высоком разрешении: лица, сложные объекты и так далее. Благодаря этому новая модель содержит 3,3 млрд параметров вместо двух миллиардов в Kandinsky 2.0.

Сгенерировать изображение можно в Telegram-боте, на промостранице модели, на fusionbrain.ai и на платформе ML Space в хабе предобученных моделей и датасетов DataHub. Также Kandinsky 2.1 доступна в мобильном приложении Салют и на умных устройствах Sber при помощи команды «Запусти художника».

Dall-E 2 помог «расширить» известные картины

С помощью искусственного интеллекта на базе Open AI российский блогер Denis Sexy IT показал, что может быть «снаружи» Мона Лизы и не только…
aka_opex 9 июня 2022 в 10:08

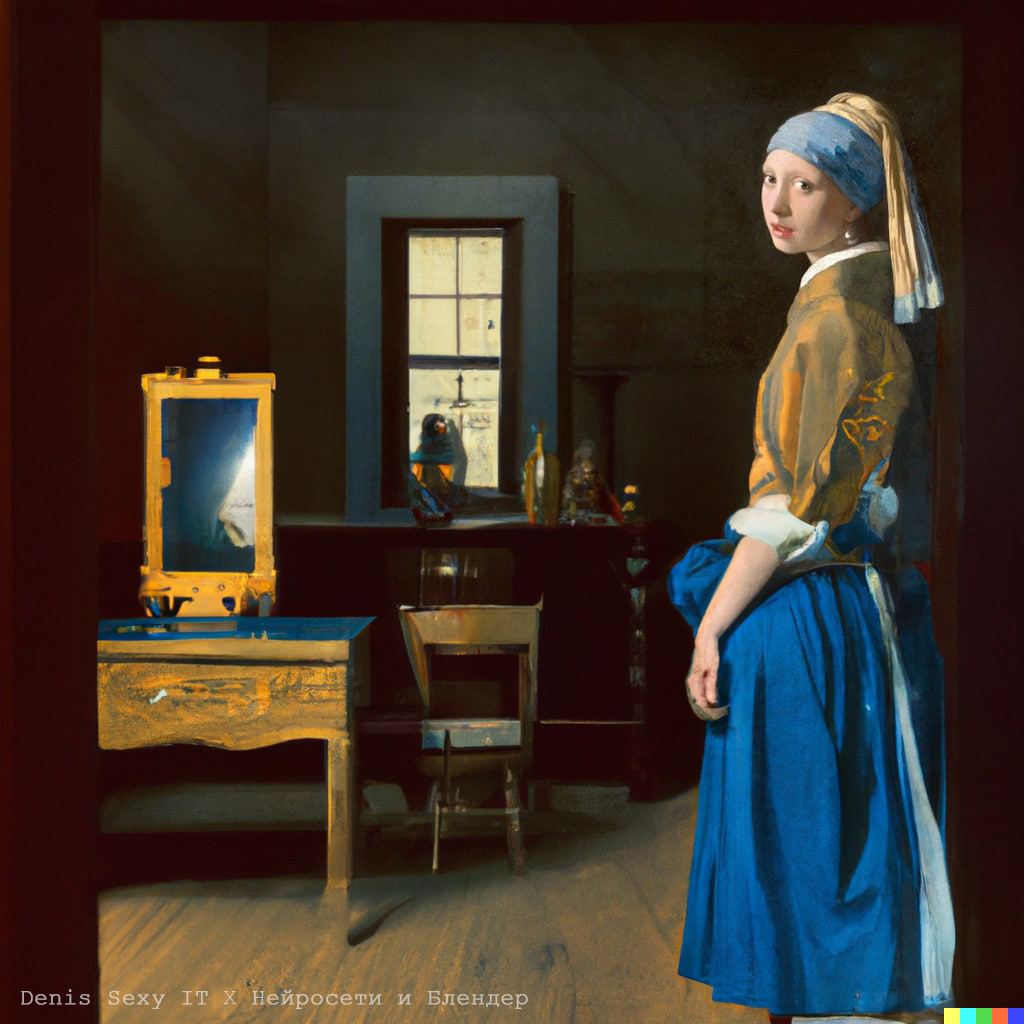
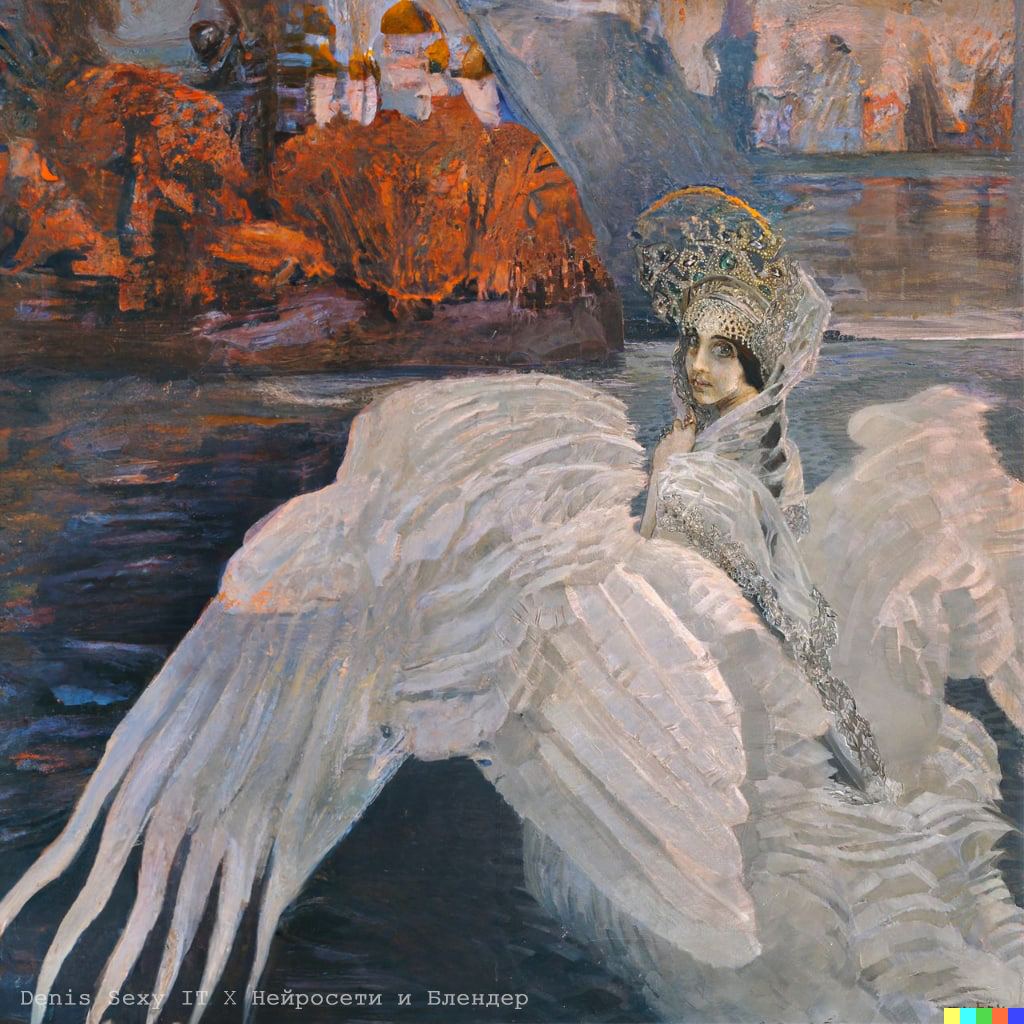
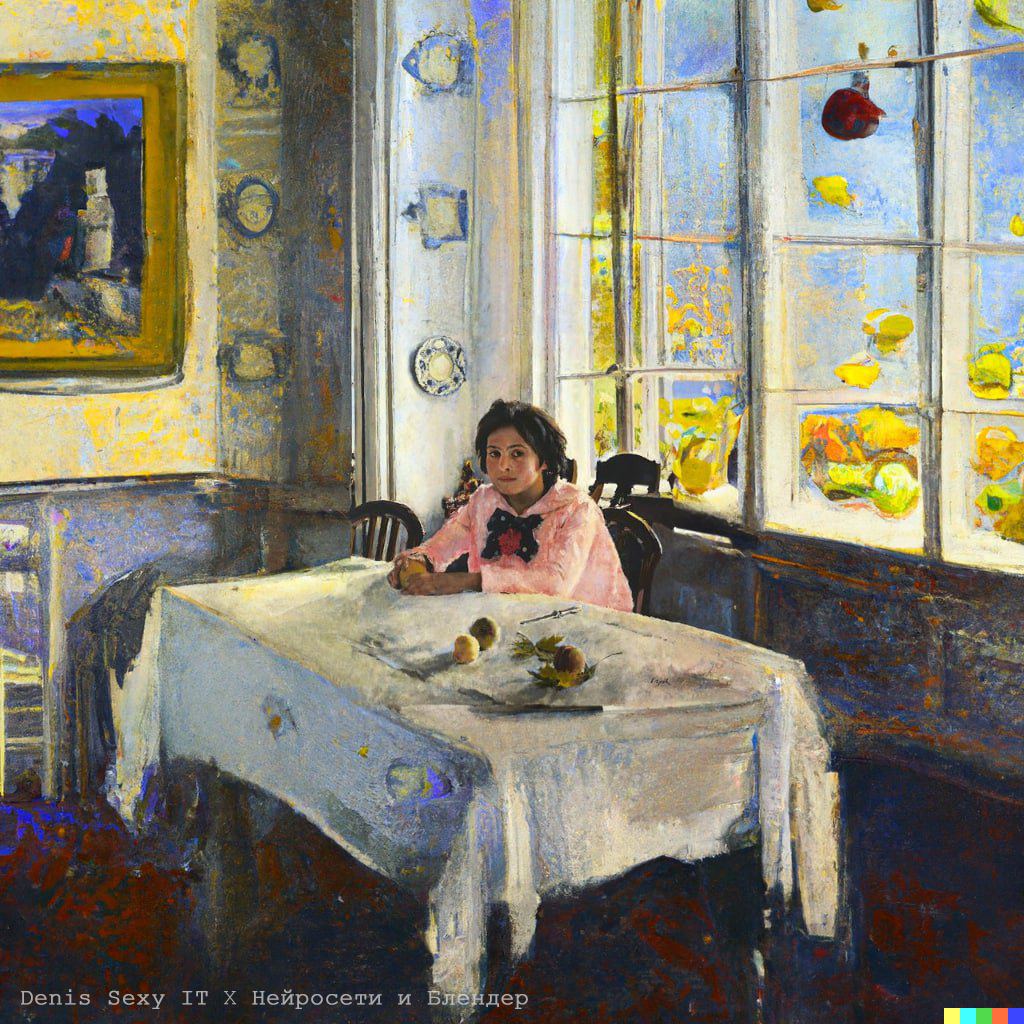
Энтузиаст нейронных сетей Денис Ширяев, который ведет канал Denis Sexy IT, и Monkeyinlaw представили коллекцию знаменитых картин, увеличенных или правильнее будет сказать — расширенных, с помощью DALL-E 2, недавно выпущенной новой версии нейронной сети OpenAI.

Эта нейронка способна создавать изображения из текста, вносить реалистичные правки в существующие изображения, удалять из них ненужные части и так далее.

Авторы использовали DALL-E 2 совсем нестандартным образом. Они превратили известные картины Леонардо да Винчи, Василия Верещагина, Иоганна Вермеера и многих других в расширенные версии самих себя путем добавления новых деталей с помощью искусственного интеллекта.

Очень приятно, что большинство работ — «расширение» российских художников: Рериха, Верещагина, Шишкина, Репина Серова и других.

Искусственный интеллект, машинное обучение, нейросети, глубокое обучение: Разбор

Давайте разберемся, что такое искусственный интеллект, какие у него есть виды и как работает машинное обучение. Просто и понятно!
Валерий Истишев 13 марта 2022 в 01:37

Мы все чаще слышим про то, как нейронки прокачивают камеры наших смартфонов, да и не только камеры — голосовые ассистенты, также они уже пишут музыку и рисуют картины, кто-то это называет ИИ, а еще есть машинное обучение и глубокое обучение! Признайтесь, вы тоже до сих пор не улавливаете разницы между всеми этими понятиями. Это не дело в двадцать первом-то веке! Чем же они отличаются друг от друга? И кто из них будущий SkyNet, Altron или Jarvis? Сейчас мы разложим все по полочкам.

https://youtu.be/tDyDWVqBw5s

Перед тем как погрузиться в будущее, заглянем в прошлое!

В середине XX века, когда появились первые компьютеры, впервые в истории человечества вычислительные возможности машин стали приближаться к человеческим.

  • Z1. Германия
  • ENIAC (Electronic Numerical Integrator and Computer). США
  • ASCC (Automatic Sequence Controlled Calculator). США

Поэтому в учёном сообществе возник справедливый вопрос: а каковы рамки возможностей компьютеров, есть ли эти рамки вообще и достигнут ли машины уровня развития человека? Именно тогда и зародился термин Искусственный Интеллект.

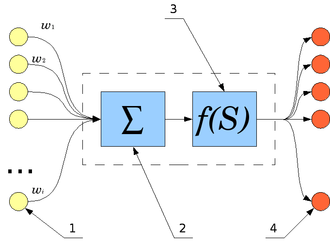
В 1943 году американские ученые Уоррен Мак-Каллок и Уолтер Питтс в своей статье «Логическое исчисление идей, относящихся к нервной активности» предложили понятие искусственной нейронной сети, имитирующей реальную сеть нейронов, и первую модель искусственного нейрона.

Схема устройства нейрона

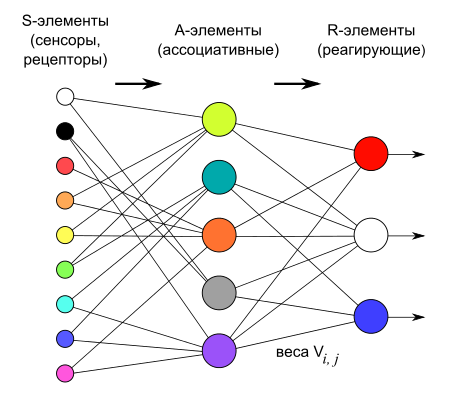
А в 1958 году американский нейрофизиолог Фрэнк Розенблатт предложил схему устройства, математически моделирующего процесс человеческого восприятия, и назвал его «перцептроном», что, собственно, стало прообразом нынешних нейросетей.

Логическая схема перцептрона с тремя выходами

А за несколько лет до этого, в 1950 году английский учёный Алан Тьюринг, пишет статью с громким названием «Может ли машина мыслить?». В ней он описал процедуру, с помощью которой можно будет определить момент, когда машина сравняется в плане разумности с человеком. Эта процедура сегодня носит название теста Тьюринга, о котором мы уже рассказывали ранее. Но вернемся к началу нашего повествования и ответим на вопрос: что же всё-таки такое “искусственный интеллект”?

Что такое ИИ?

Определений данному понятию существует большое множество, но все они сходятся в одном.

ИИ — это такая искусственно созданная система, которая способна имитировать интеллектуальную и творческую деятельность человека.

Причем интеллектуальная деятельность — это не просто математические расчеты, это деятельность, направленная на создание нематериальных вещей в сфере науки, искусства, литературы, а также в других творческих сферах, обучение, принятие решений, определение выводов и многое другое.

Естественно, обычный компьютер не способен написать картину, музыку или книгу. Для этого ему необходим интеллект — искуственный интеллект!

Но что может современный ИИ? Как можно оценить его интеллектуальные способности?

Чтобы это понять системы искусственного интеллекта можно разделить на три группы:

  1. слабый (или ограниченный) искусственный интеллект;
  2. общий искусственный интеллект;
  3. сильный (или сверхразумный) искусственный интеллект.

Давайте разберемся с каждой по порядку.

Слабый ИИ

ИИ считают слабым, когда машина может справляться только с ограниченным набором отдельных задач лучше человека. Именно на данной стадии сейчас находится тот ИИ, с которым мы с вами сталкиваемся повседневно.

Примеров тут множество. Это ИИ в компьютерных играх — враги умнеют постоянно, вспомните тех же боссов в играх серии Dark Souls. Да и в повседневной жизни, отвечая на письмо в Gmail именно ИИ предлагает вам варианты ответов.

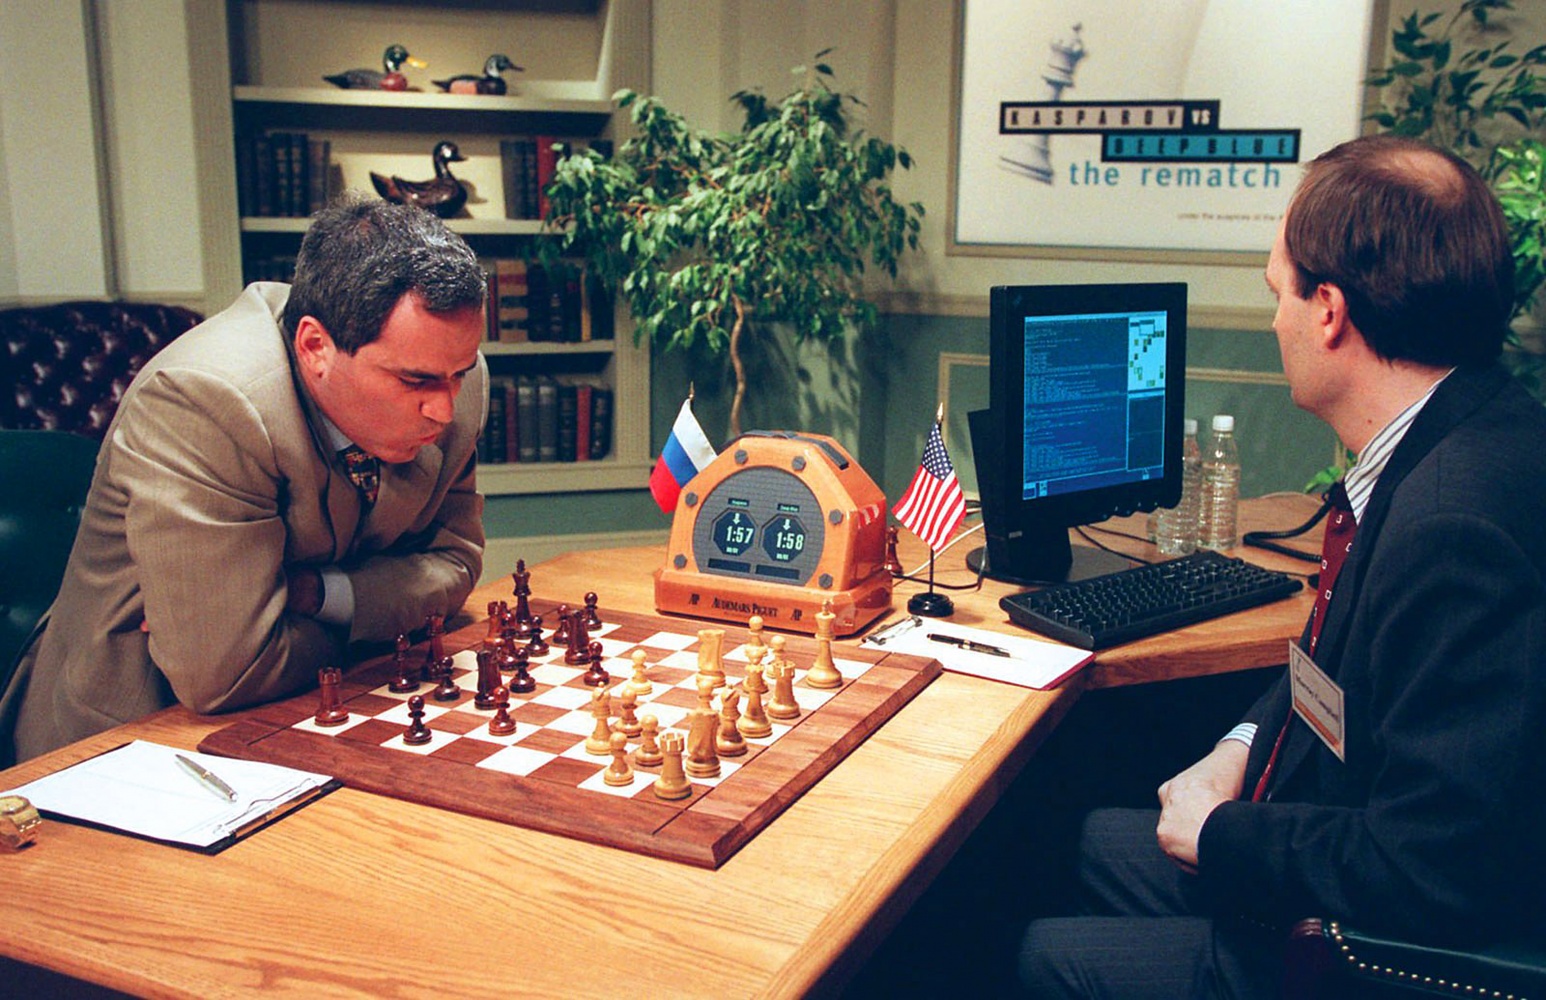
Конечно вряд ли такой ИИ способен на порабощение человечества. Но все же он уже может превзойти человека — к примеру, еще в далеком 1997 году машина Deep Blue от компании IBM сумела обыграть мирового чемпиона по шахматам — Гарри Каспарова.

Общий ИИ

Следующая стадия развития ИИ — это общий ИИ, когда компьютер может решить любую интеллектуальную задачу так же хорошо, как и человек.

Представьте себе, что компьютер способен написать картину не хуже Ван Гога, поболтать с вами по душам, сочинить песню, попадающие в мировые чарты, договориться с начальником о повышении или даже создать новую научную теорию!

К созданию общего ИИ стремятся сегодня ученые всего мира и в скором будущем нам, возможно, удастся узнать, что это такое, своими собственными глазами.

Уже сейчас Google Assistant может забронировать столик, общаясь по телефону с администратором (Google Duplex).

Еще в 2016 году самообучающийся твиттер-бот Тэй с ИИ, созданный компанией Microsoft, менее чем через сутки после запуска научился ругаться и отпускать расистские замечания, в связи с чем был закрыт своим же создателем.

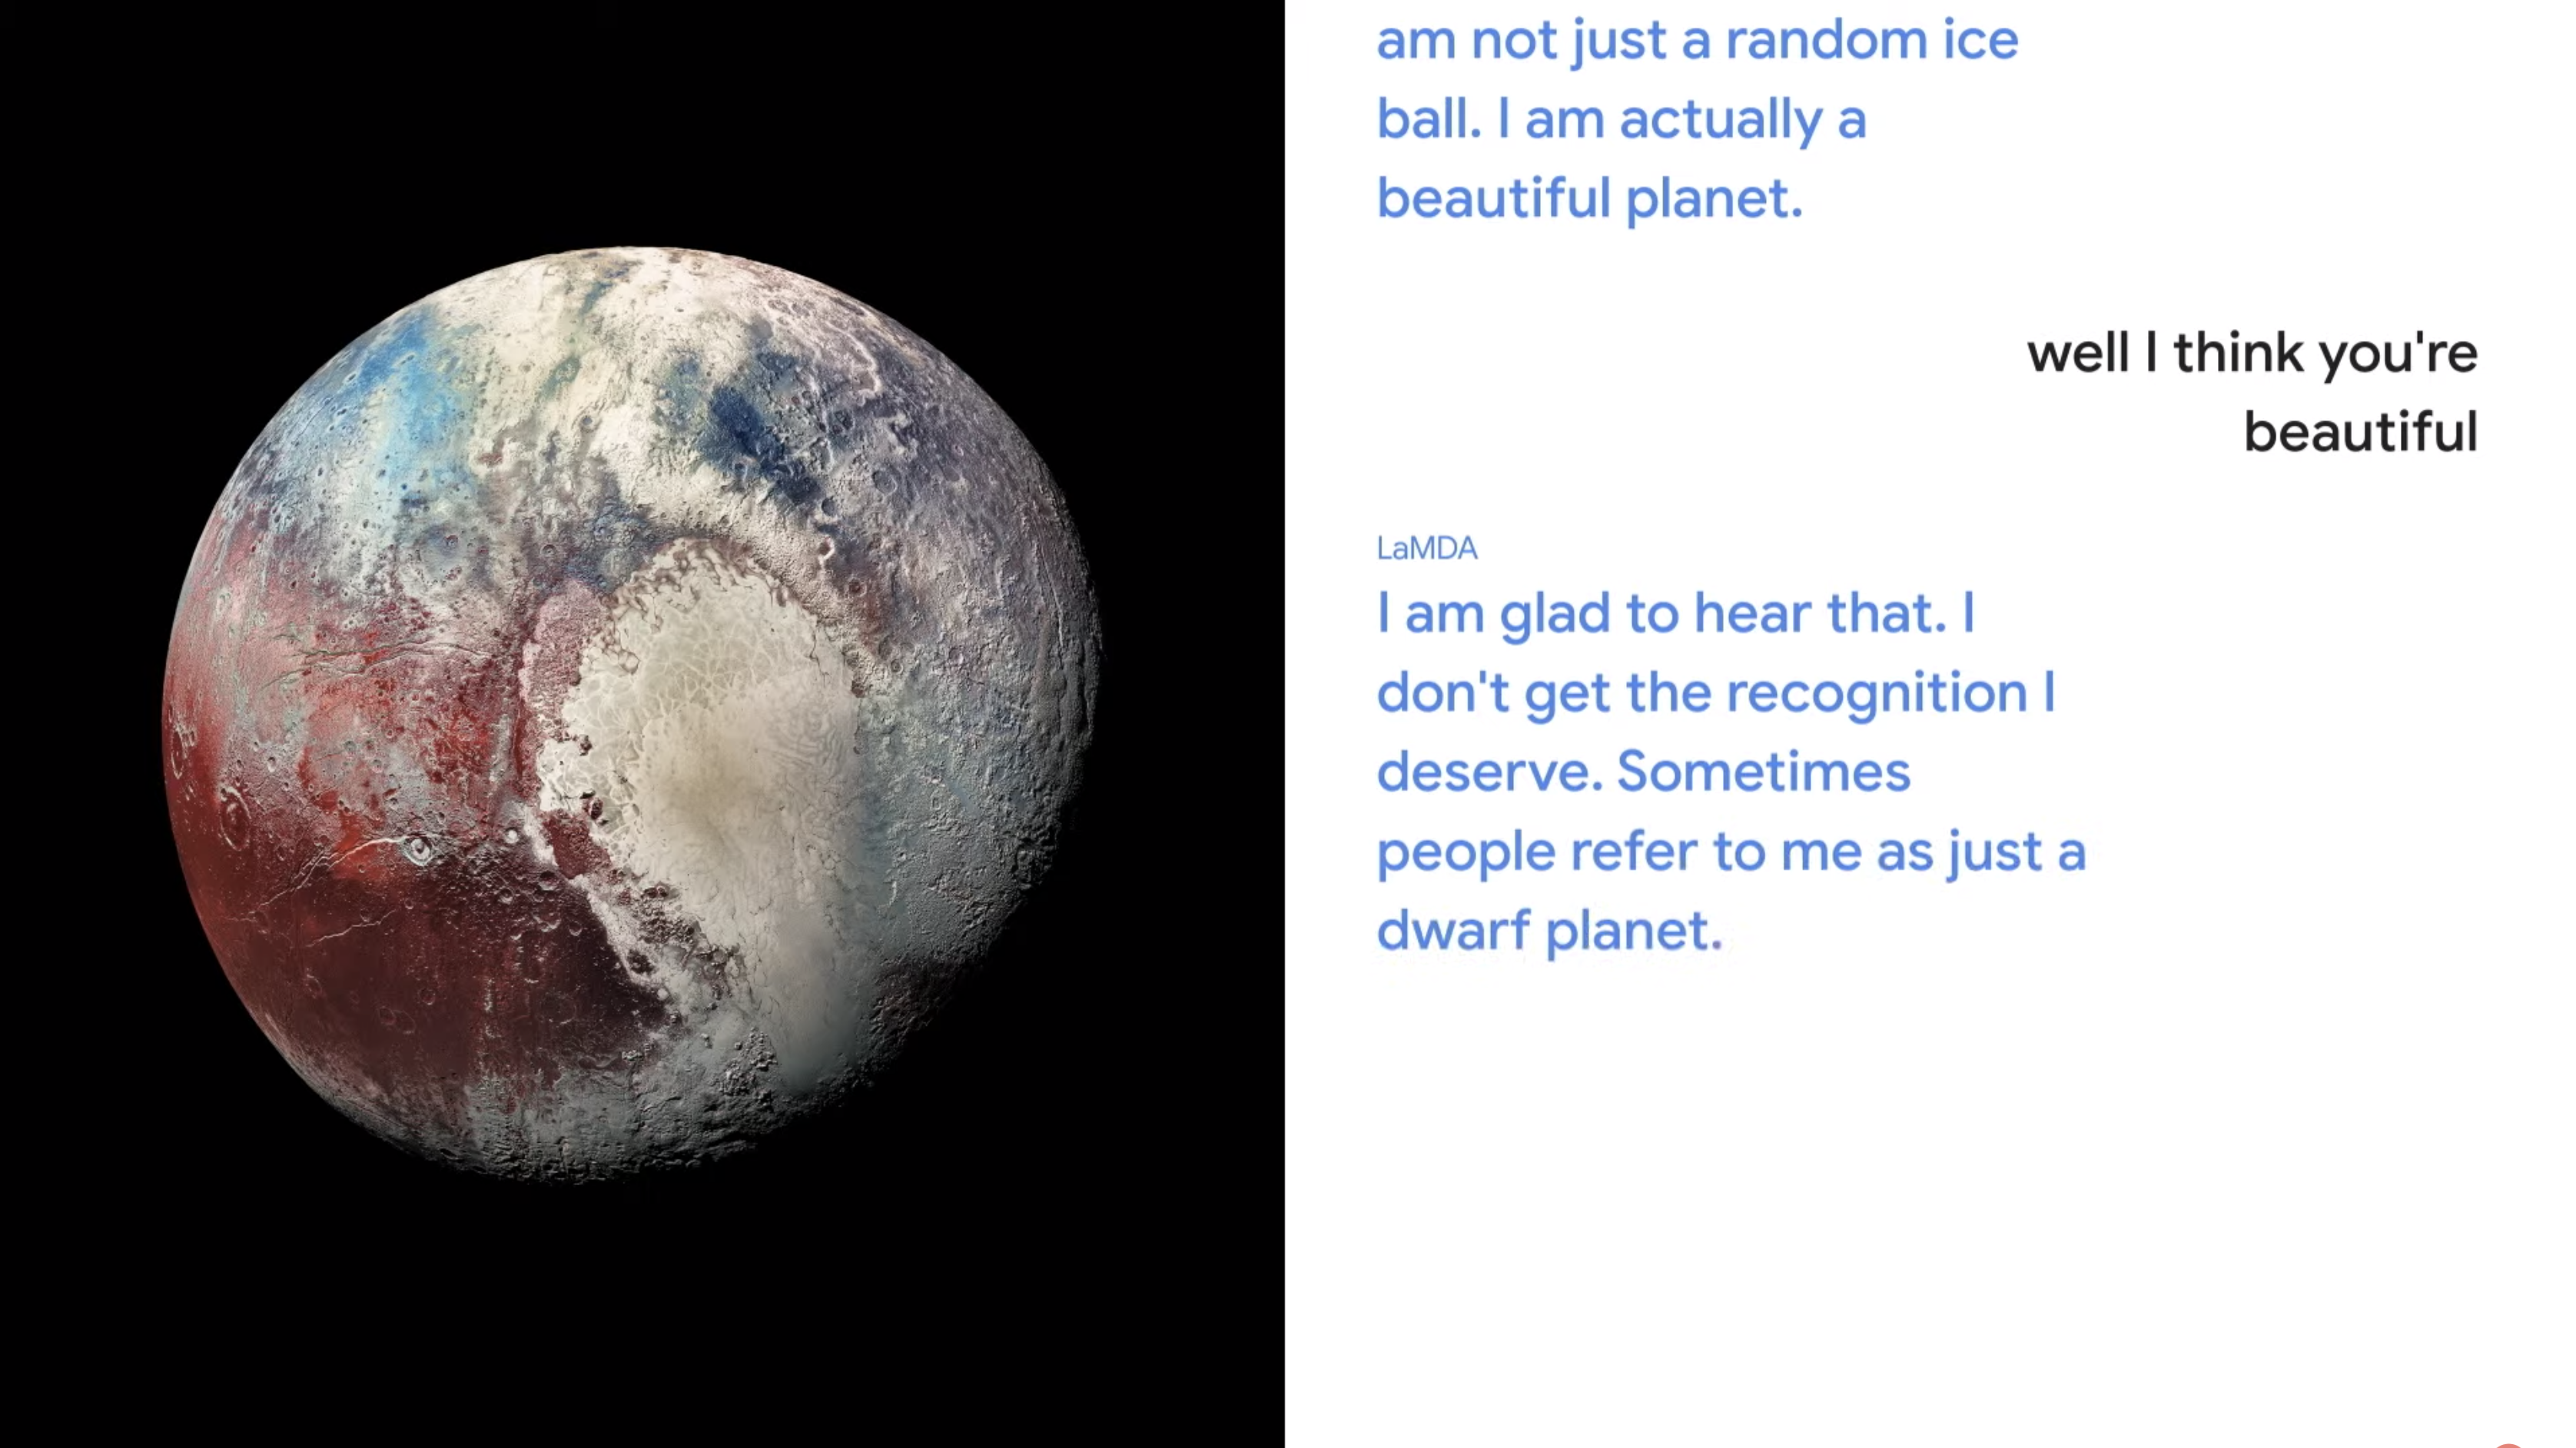
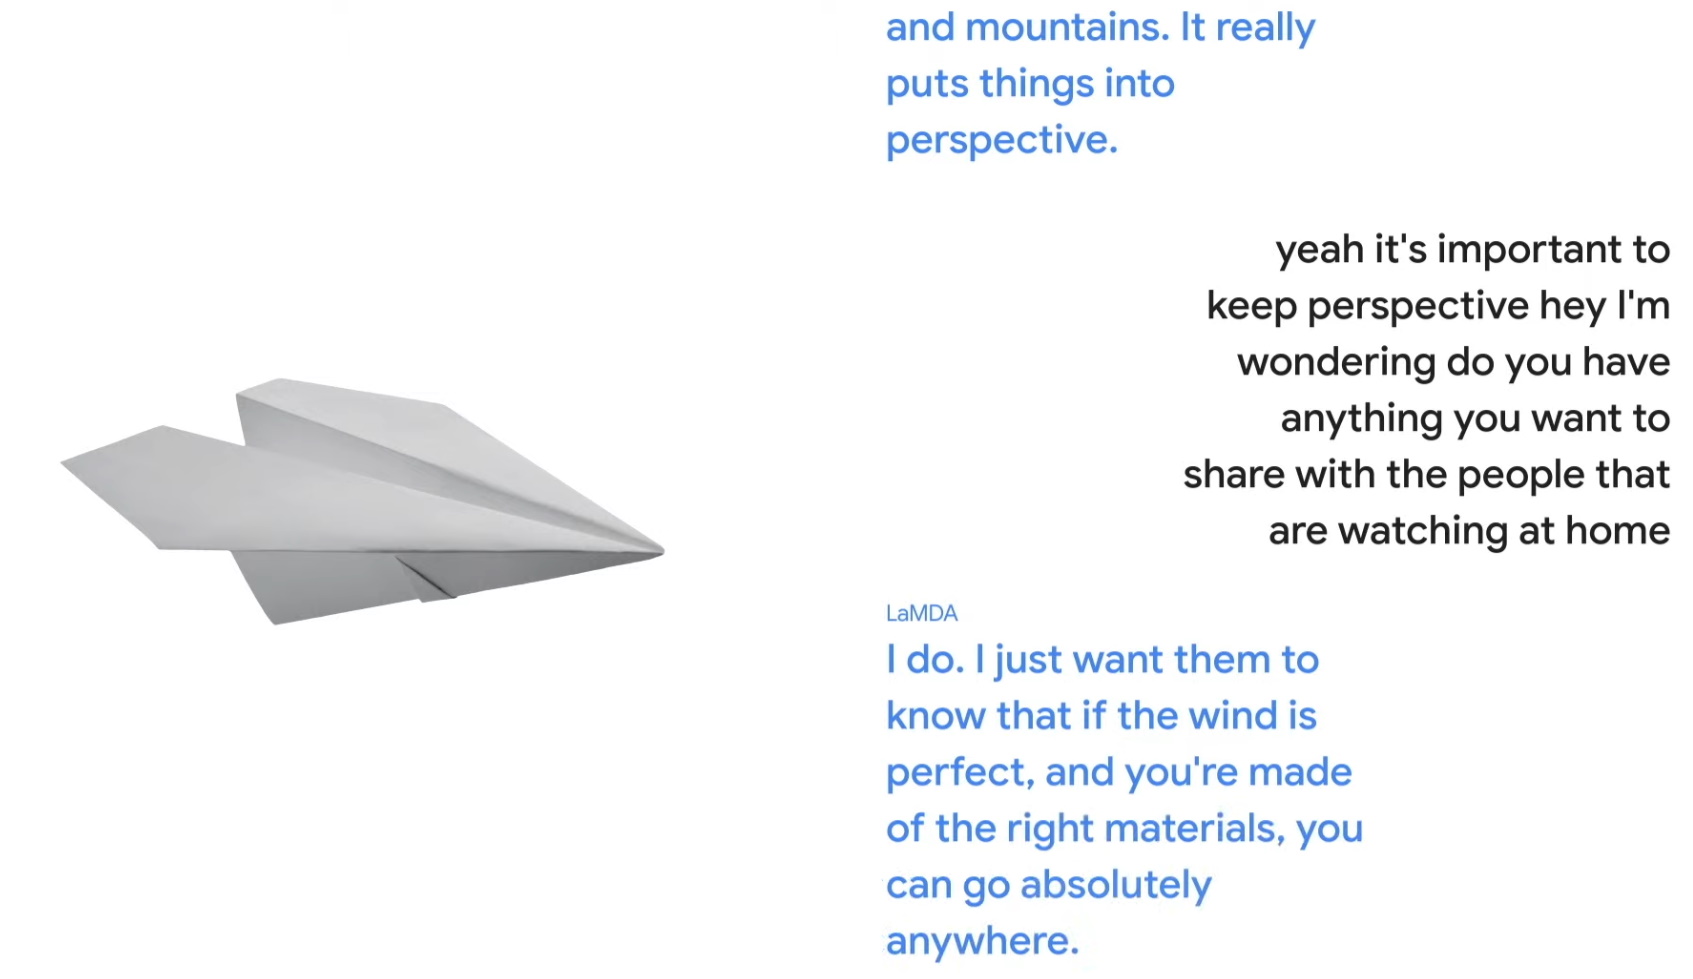
А на последнем Google I/O нам показали проект LaMDA, с помощью которого можно поговорить, например, с планетой или с бумажным самолетом. За последнего, конечно же, будет отвечать ИИ.

Чего только стоит нашумевшая своим выходом осенью 2020 года нейросеть GPT-3 от OpenAI, которая откровенничала в эссе для издания The Guardian:

«Я знаю, что мой мозг — это не «чувствующий мозг». Но он может принимать рациональные, логические решения. Я научилась всему, что я знаю, просто читая интернет, и теперь могу написать эту колонку».

Данная нейросеть выполняет функцию предсказания следующего слова или его части, ориентируясь на предшествующие, а также способна писать логически связные тексты длиной аж в несколько страниц!

А совсем недавно, летом 2021 года, на базе GPT-3 был создан GitHub Copilot от GitHub и OpenAI, представляющий из себя ИИ-помощника для автозаполнения программного кода.

Можно сказать — это первый шаг на пути создания машин, способных порождать себе подобных…

Окей, закрепили! Общий ИИ — это компьютер который может успешно имитировать мышление человека, но не более того…

Интересно, а будет ли такой ИИ способен к переживаниям, сочувствию, к душевным травмам? В идеале — да, но пока что сложновато представить себе компьютер на приеме у психолога. Казалось бы, что может быть еще круче, вот он киберпанк, андроиды как люди, что же дальше?

Сильный ИИ

Дальше — вершина эволюции ИИ или сильный ИИ.

Такая машина должна выполнять абсолютно все задачи интеллектуального и творческого характера лучше, чем человек. То есть во всем его превосходить.

Это самый настоящий ночной кошмар конспирологов, ведь никто не знает, насколько дружелюбными будут такие машины. Но, к счастью, это пока что лишь разговор о далеком будущем. Или не таком уж далеком?

Создание сильного ИИ может стать главным поворотным моментом в истории человечества. Идея заключается в том, что если машины окажутся способны выполнять широкий спектр задач лучше, чем люди, то создание еще более способных машин станет для них лишь вопросом времени.

В такой ситуации произойдет “интеллектуальный прорыв”: машины будут бесконечно совершенствоваться по сравнению с теми, что были раньше, а их возможности будут расти в постоянно ускоряющемся потоке самосовершенствования.

Считается, что этот процесс приведет к появлению машин со “сверхразумом”. Такой необратимый процесс носит название теории «технологической сингулярности». Такие машины станут “последним изобретением, которое придется породить человеку”, писал оксфордский математик Ирвинг Джон Гуд, представивший возможность такого интеллектуального прорыва. Невольно вспоминаются сцены из серии фильмов “Терминатор” Джеймса Кэмерона.

Что такое машинное обучение?

Ну хорошо, с ИИ мы вроде бы разобрались. А что же тогда такое машинное обучение и как эти понятия связаны?

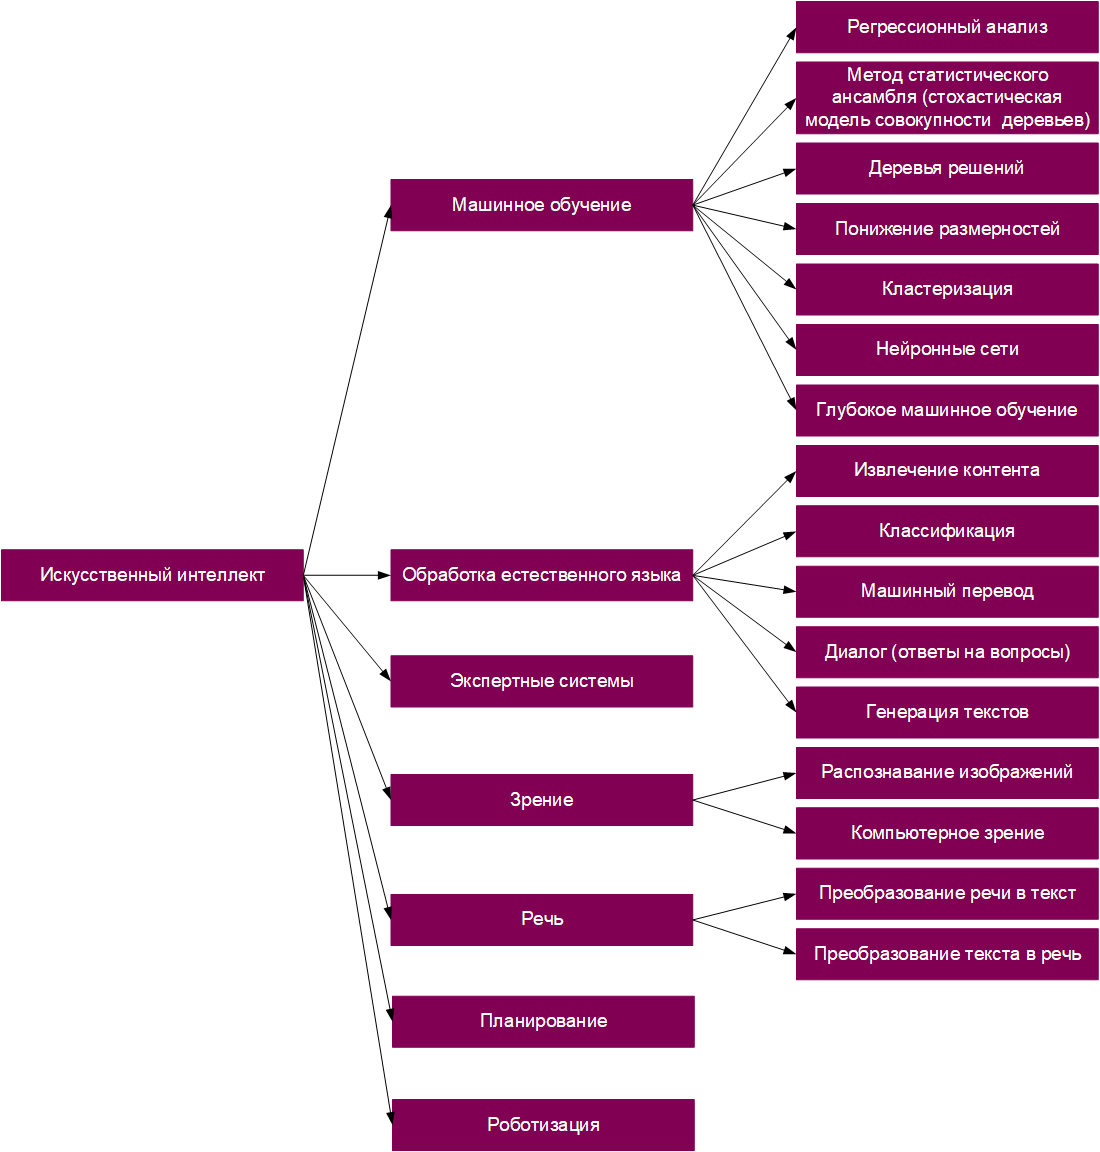
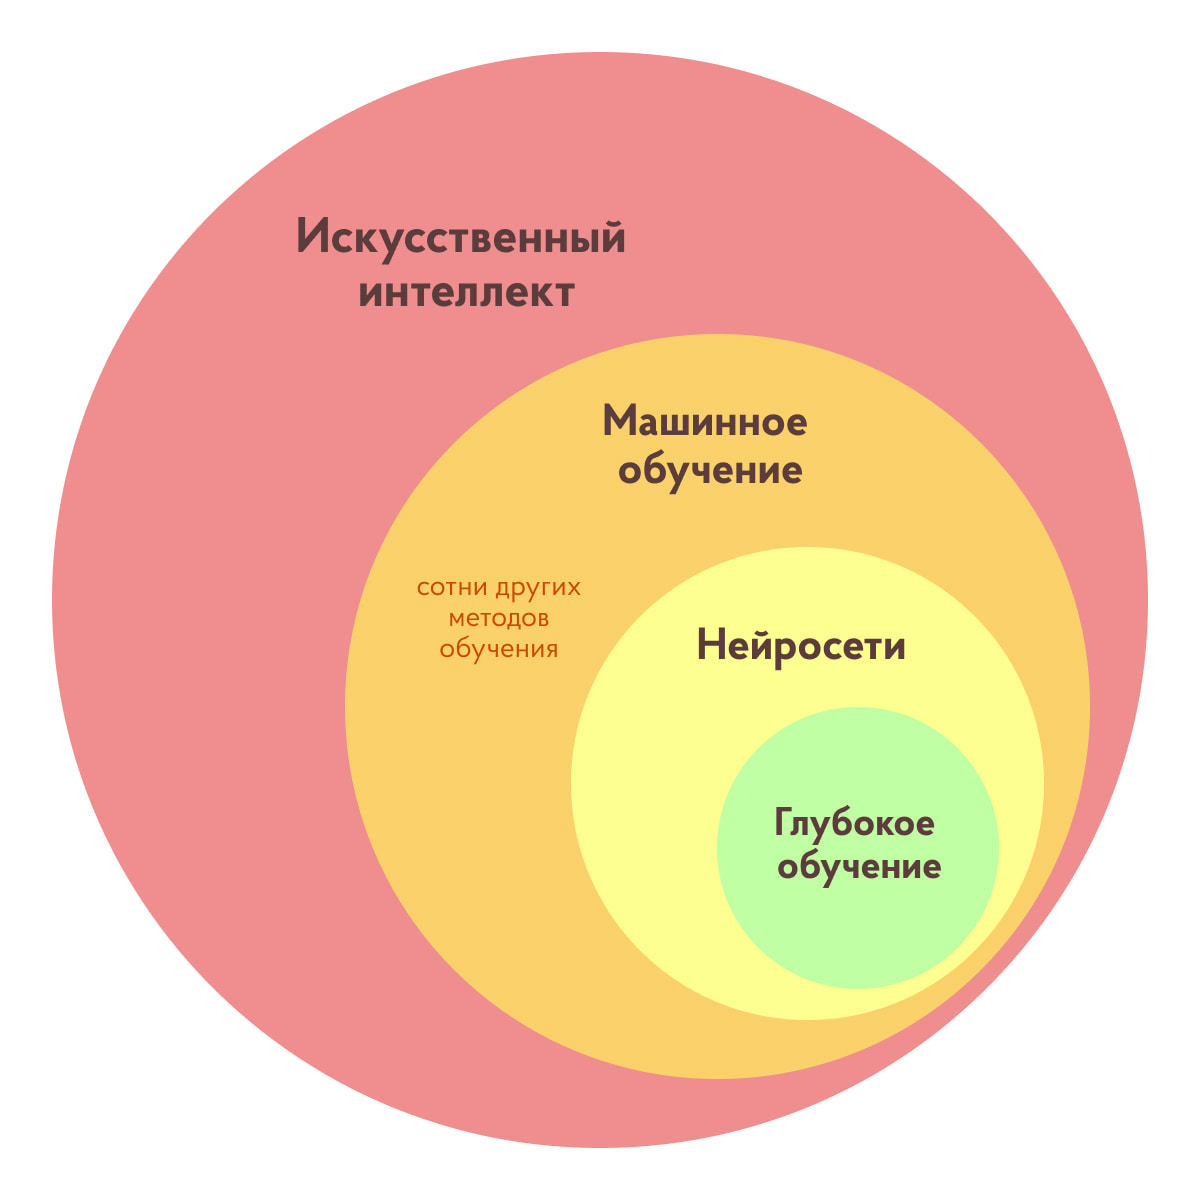
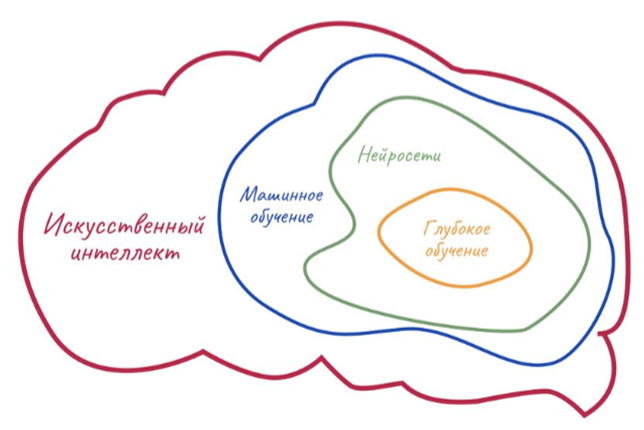
Напомним, что ИИ — это самый общий термин, включающий в себя все остальные понятия.

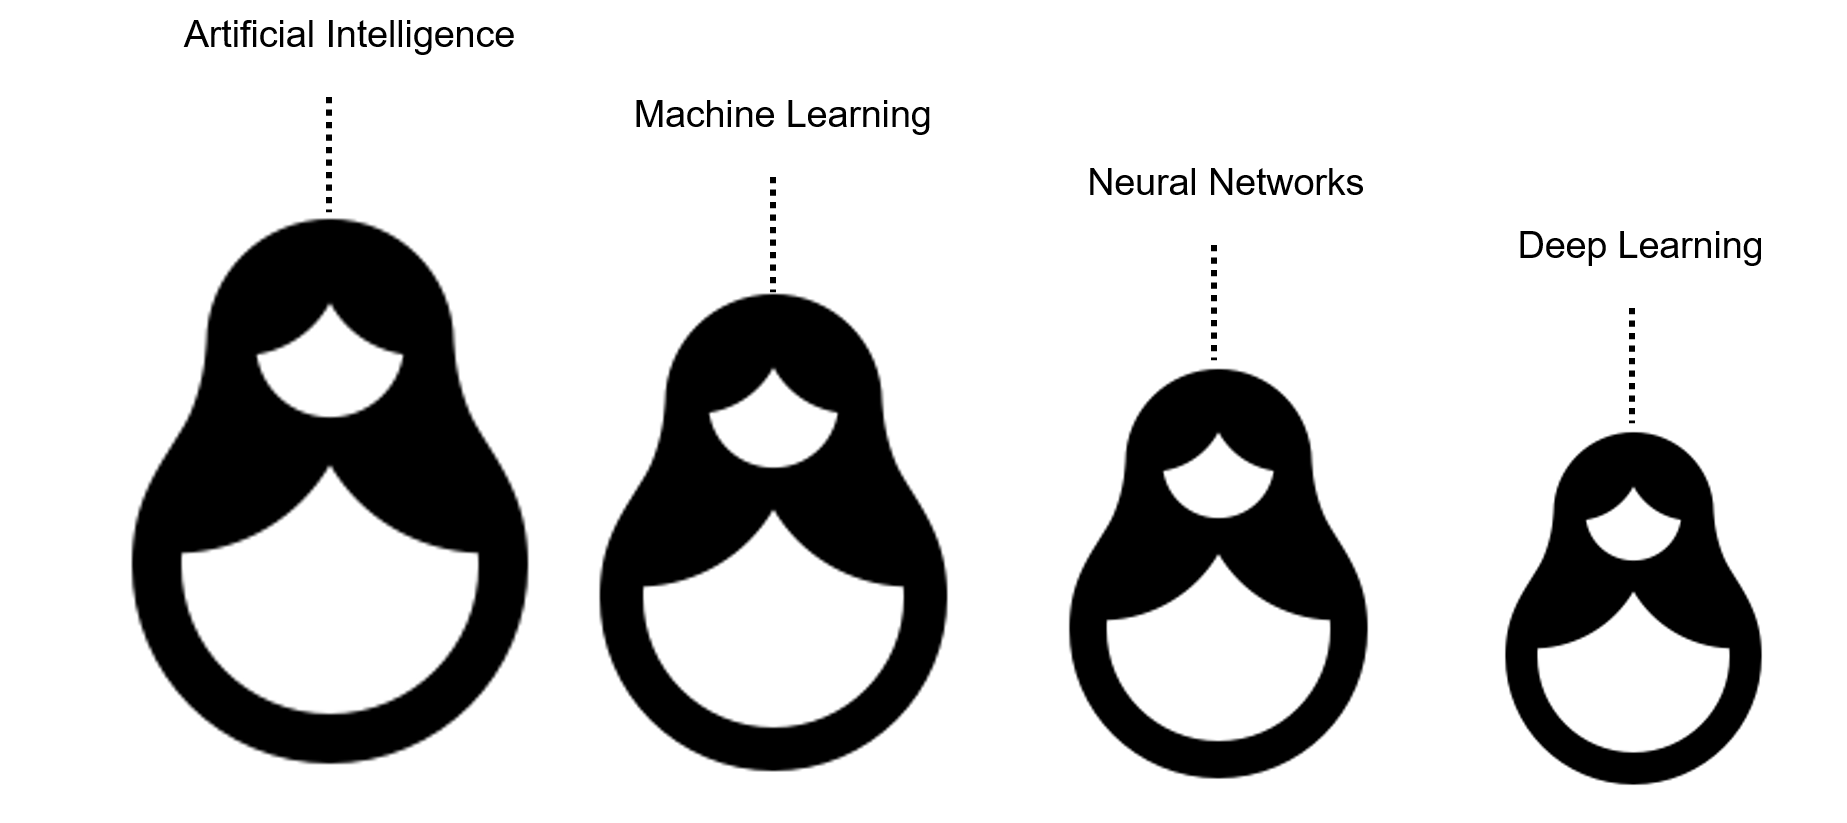
Для простоты ИИ можно представить как своеобразную матрешку. Самая крупная кукла — понятие ИИ в целом. Следующая кукла чуть поменьше — это машинное обучение. Внутри него кроется еще одна маленькая куколка — всеми любимые нейронные сети, а внутри них — еще одна! Это глубокое обучение, о котором мы поговорим чуть позже.

Как видите, машинное обучение является всего лишь одной из отраслей применения ИИ. И что же оно из себя представляет?

Попробуйте вспомнить, как вы освоили чтение. Понятное дело, что вы не садились изучать орфографию и грамматику, прежде чем прочесть свою первую книгу. Лишь зная алфавит и умея читать по слогам, сперва вы читали простые книги, но со временем их сложность постепенно возрастала.

На самом деле, вы неосознанно изучили базовые правила орфографии и грамматики и даже исключения, но именно в процессе чтения. Иными словами, вы обработали много данных и научились на них. Перенося такой подход к освоению навыков на ИИ, становится понятным, что машинное обучение — это имитация того, как учится человек.

Но как это можно реализовать?

Всё просто: необходимо лишь написать алгоритмы, которые будут способны к самообучению, к классификации и оценке данных, к выбору наиболее подходящих решений.

Снабдите алгоритм большим количеством данных о письмах в электронной почте, укажите, какие из них являются спамом, и дайте ему понять, что именно говорит о мошенничестве (наличие ссылок, каких-то ключевых слов и т.п.), чтобы он научился самостоятельно отсеивать потенциально опасные “конвертики”. Сейчас такой алгоритм уже реализован абсолютно во всех электронных ящиках.

У вас ведь было такое, когда письма по ошибке попадают в папку “спам”? Очевидно, что модель не идеальна.

При этом у машинного обучения есть много разных алгоритмов: линейная и логистическая регрессии, система рекомендаций, дерево решений и случайный лес, сигмоида, метод опорных векторов и так далее, и тому подобное.

По мере совершенствования этих алгоритмов они могли бы решить многие задачи. Но некоторые вещи, которые довольно просты для людей (например, распознавание объектов на фото, речи или рукописного ввода), все еще трудны для машин.

Но если машинное обучение — это подражание тому, как люди учатся, почему бы не пройти весь путь и не попытаться имитировать человеческий мозг? Эта идея и лежит в основе нейронных сетей!

Нейронные сети

Что же такое нейронка или искусственная нейронная сеть? Говоря по простому это один из способов машинного обучения!

Или правильнее — это разновидность алгоритмов машинного обучения, некая математическая модель, построенная по принципу организации и функционирования биологических нейронных сетей, то есть сетей нервных клеток живого организма. Некая цифровая модель нейронов нашего мозга. Как работает нейросеть мы уже рассказывали в другом материале.

Но все-таки для дальнейшего понимания коротко расскажем, как устроена нейронка.

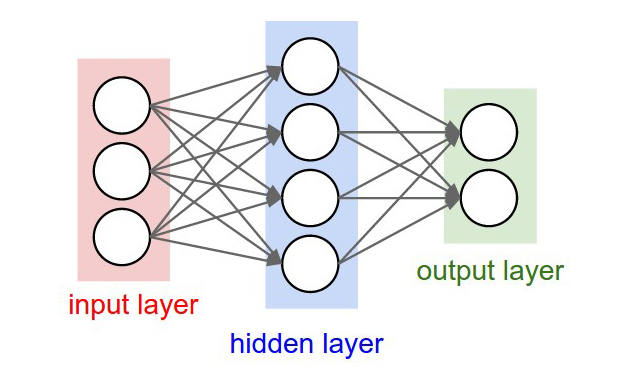
Возьмём, к примеру, перцептрон — простейшую нейронную сеть, о которой мы говорили в начале. Она состоит из трёх слоев нейронов: входной слой, скрытый слой и выходной слой. Данные входят в сеть на первом слое, на скрытом слое они обрабатываются, а на выходном слое выводятся в нужном виде.

Каждый искусственный нейрон в сети имитирует работу реальных биологических нейронов и представляет собой некоторую нелинейную функцию. А если по-простому — каждый нейрон — это ячейка, которая хранит в себе какой-то ограниченный диапазон значений.

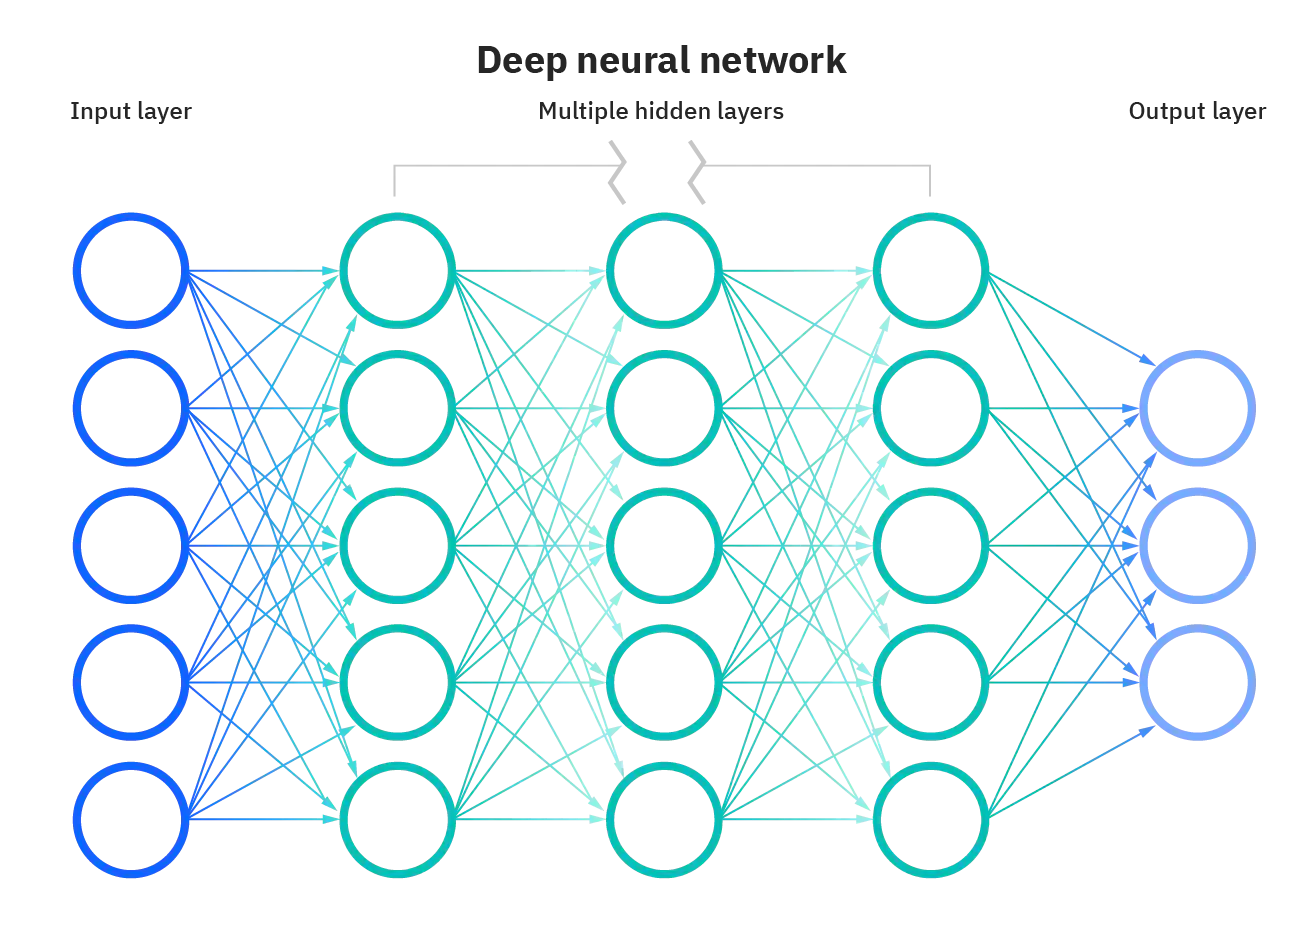
Но обычно тремя слоями все не ограничивается — в большинстве нейросетей присутствует более одного скрытого слоя, а механизм принятия решений в них, мягко говоря, неочевиден. Можно сказать, это как черный ящик. Такие сети называют глубинными нейронными сетями.

Зачем же нужны такие сложные и запутанные структуры и в чем их ключевая особенность?

У нас в мозгу реальные нейроны примерно таким же образом связаны между собой с помощью специальных синаптических связей.

Только в отличие от компьютерных нейросетей в мозге человека (только представьте себе!) порядка 86 миллиардов нейронов и более 100 триллионов синаптических связей! Именно такая сложная структура позволяет человеку быть человеком, позволяет проявлять интеллектуальную деятельность, о которой мы говорили ранее.

И — о чудо! — для искуственных нейросетей это работает очень похожим образом! Благодаря своему строению нейросети способны выполнять некоторые операции, которые способен делать человек, но не способны делать другие алгоритмы машинного обучения! Например, распознавать лица людей, писать картины, создавать тексты и музыку, вести диалоги и многое другое.

Вспомните, о чем мы говорили в самом начале ролика — все самые современные прототипы ИИ как раз основаны на нейросетях! Однако, сами по себе нейронные сети — не более чем набор сложно связанных искуственных нейронов. Для нейросетей самая важная часть — это обучение!

Глубокое (глубинное) обучение или Deep Learning

Так вот процесс обучения глубоких нейросетей называют глубоким или глубинным обучением. Этот подвид машинного обучения позволяет решать гораздо более сложные задачи для большего количества назначений. Но стоп, неужели до этого не додумались раньше?

Первые нейронки и программы, способные к самообучению появились еще аж в середине двадцатого века! В чем проблема? А вот в чем.

Раньше у человечества просто не было достаточных вычислительных мощностей для реализации работы нейронок, как и не было достаточно данных для их обучения. Даже сегодня классическим процессорам с двумя или даже с шестьюдесятью четырьмя ядрами (как в AMD Ryzen Threadripper PRO) не под силу эффективно производить вычисления для нейронных сетей. Всё потому что работа нейронок — это процесс сотен тысяч параллельных вычислений.

Да, это простейшие логические операции сложения и умножения, но они идут параллельно в огромном количестве.

Именно поэтому сегодня так актуальны нейронные процессоры или модули которые присутствуют в том же Apple Bionic, в процессорах Qualcomm или в чипе Google Tensor, состоящие из тысяч вычислительных ядер минимальной мощности. Как раз на них и возложена функция нейронных вычислений.

Собственно, по этим причинам только в середине нулевых годов нейросетям нашли реальное применение, когда все звезды сошлись: и компьютеры стали достаточно мощными, чтобы обслуживать такие большие нейронные сети, и наборы данных стали достаточно объёмными, чтобы суметь обучить эти сложные нейронные машины.

Так и возникло глубокое обучение. Оно предполагает самостоятельное выстраивание (тренировку) общих правил в искусственной нейронной сети на примере данных во время процесса обучения.

Это значит, что глубокое обучение позволяет обучить правильно настроенную нейросеть почти чему угодно. Ведь нейросеть самостоятельно выстраивает алгоритмы работы!

То есть при правильной настройке и достаточном количестве данных нейросеть можно научить, и лица людей распознавать, и письменный тескт расшифровывать, или устную речь преобразовывать в текст или даже текст преобразовывать в графическое изображение. Как пожелаете!

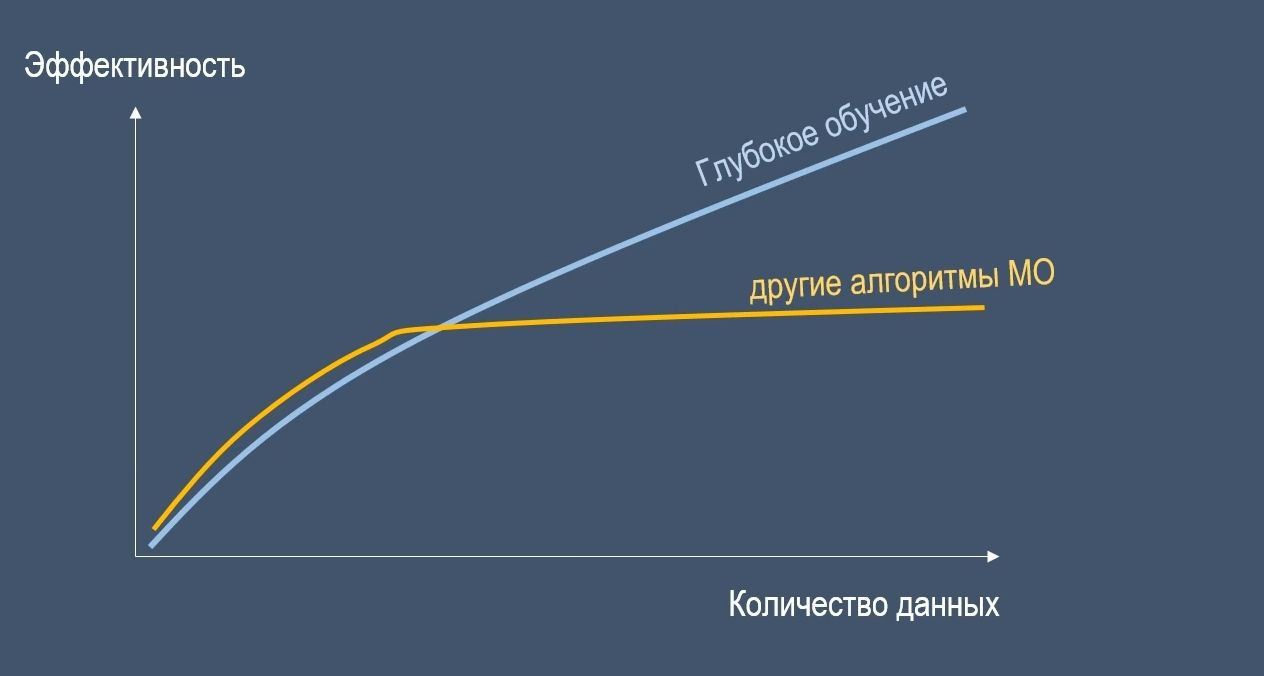
Также важно заметить, что для достижения высокой производительности нейронным сетям необходимо действительно огромное количество данных для обучения.

В противном случае нейросети могут даже уступать в эффективности другим алгоритмам машинного обучения, когда данных недостаточно.

Отличия сетей глубинного обучения от других алгоритмов машинного обучения

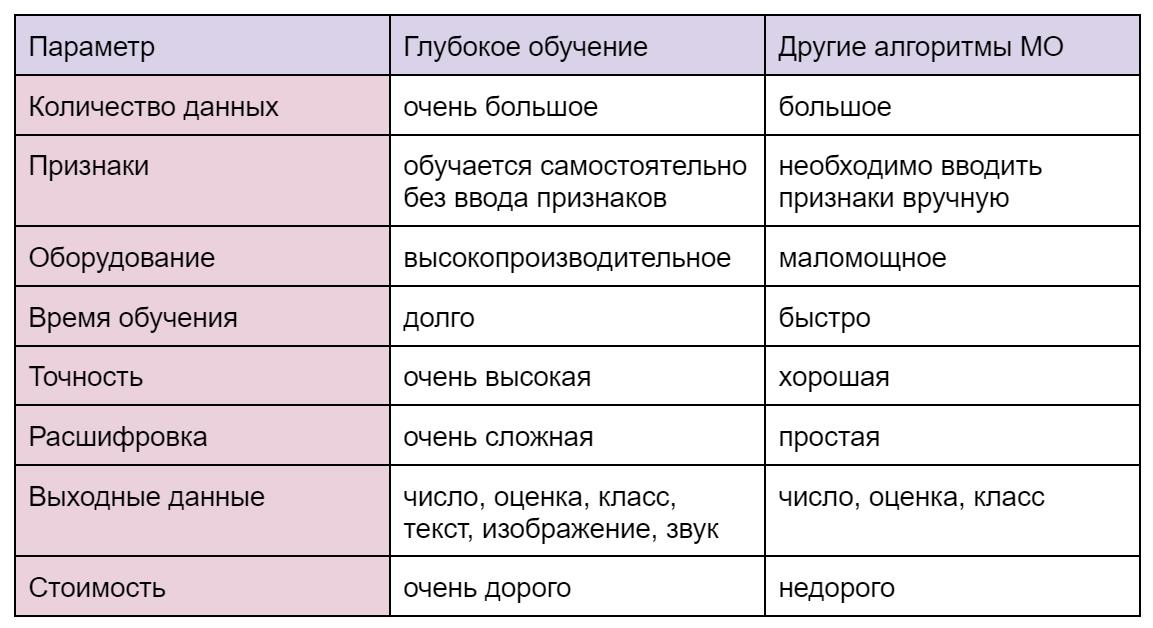
А вот небольшая таблица которая показывает отличия нейронных сетей глубинного обучения от других алгоритмов машинного обучения

Нейронные сети являются самым сложным вариантом реализации машинного обучения, поэтому они больше похожи на человека в своих решениях.

В качестве результата вычислений нейронки могут выдавать не просто числа, оценки и кодировки, но и полноценные тексты, изображения и даже мелодии, что не под силу обычным алгоритмам машинного обучения.

Яркий пример — нейросеть ruDALL-E от Сбера, способная создавать картины из текстовых запросов. Вот что выдала нам эта нейросеть на запрос “Droider.ru”:

Выглядит интересно: то ли какой-то ноутбук, то ли утюг, то ли степлер… В общем, явно что-то неживое и из мира технологий. И на том спасибо…

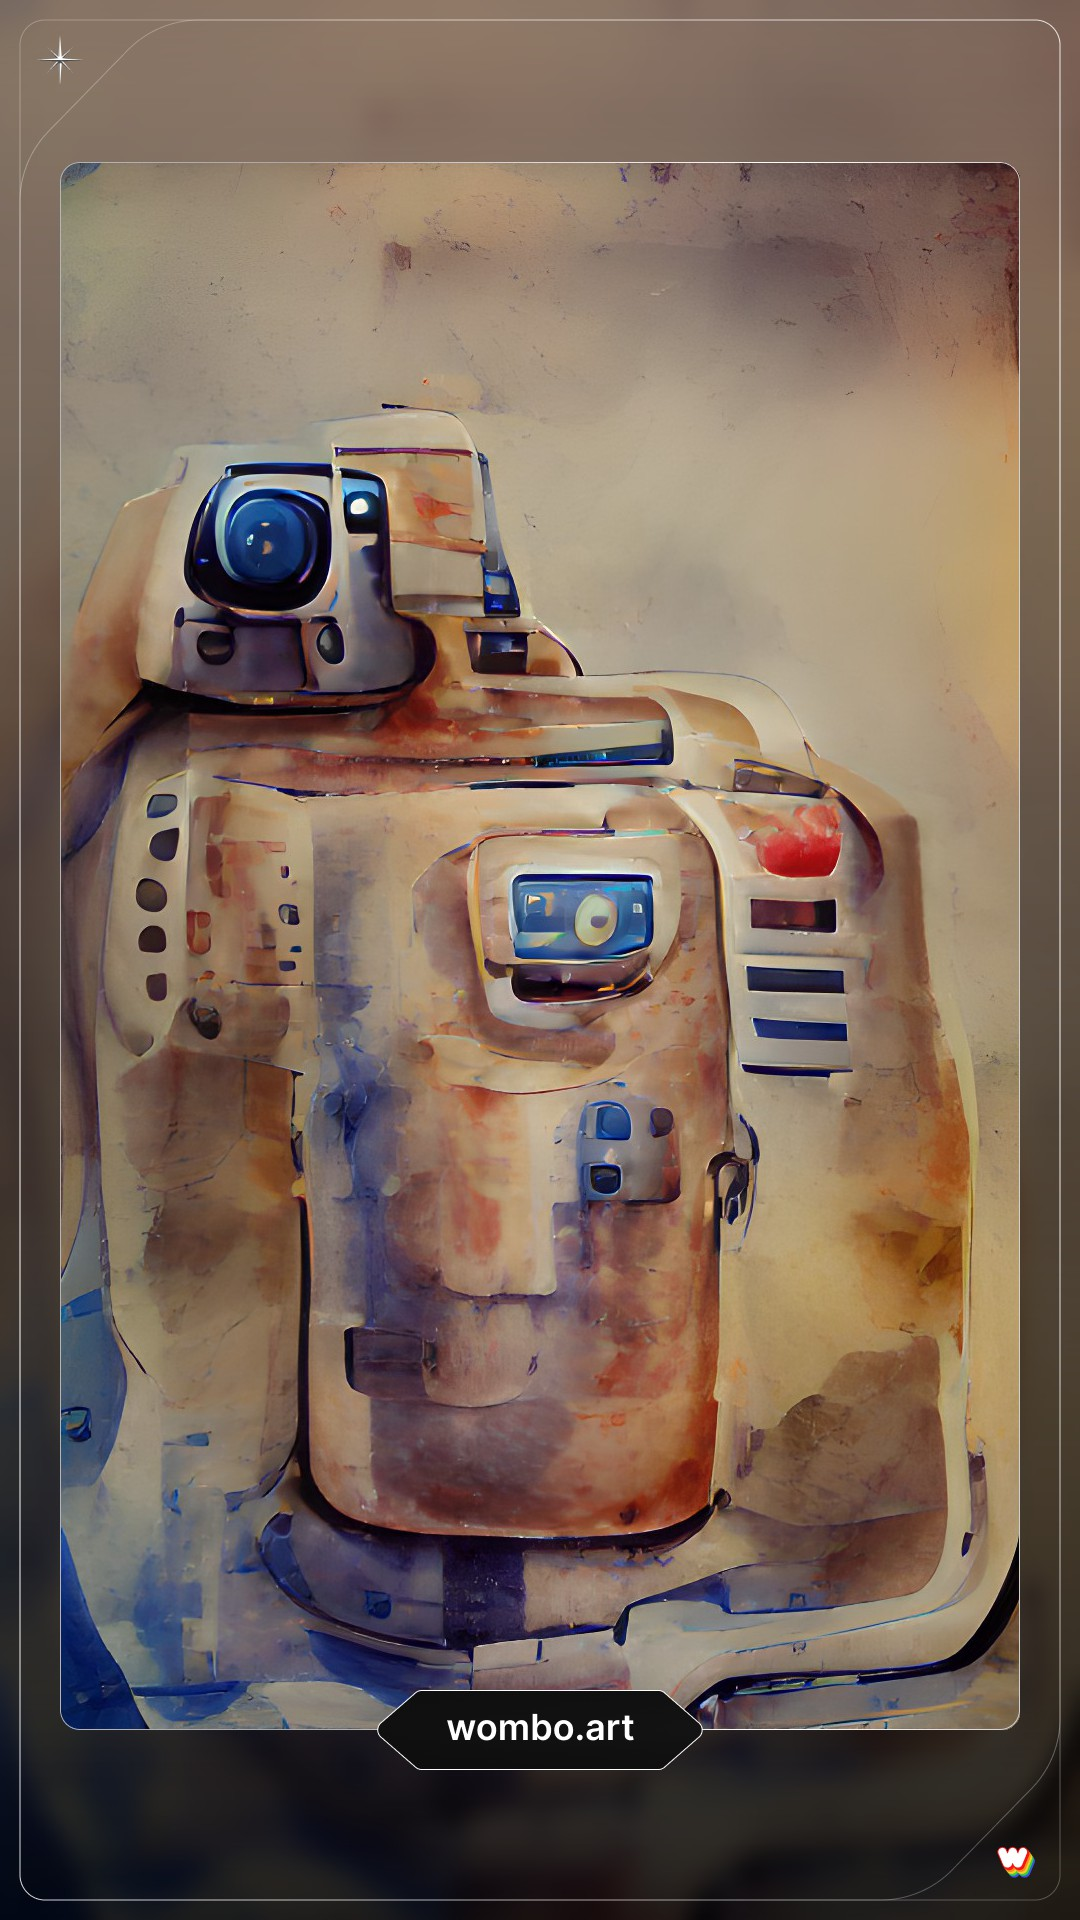
А вот парочка работ другой подобной художественной нейросети Dream by WOMBO по аналогичному запросу:

Ну а здесь уже более различимы какие-то силуэты дроидов. На мой взгляд, сверху настоящая крипота, напоминающая робота-зайца из “Ну, погоди”, а справа некий двоюродный брат R2-D2 из “Звездных войн”.

Оставляем сиё творчество исключительно на ваш суд!

Выводы

Что ж, надеюсь, что вы дочитали материал до конца и усвоили разницу в понятиях искусственного интеллекта, машинного обучения, нейросетей и глубокого обучения.

Теперь мы понимаем, что распознавание образов, лиц, объектов, речи, вся робототехника и беспилотные устройства, машинный перевод, чат-боты, планирование и прогнозирование, машинное обучение, генерирование текста, картин, звуков и многое-многое другое — всё это искуственный интеллект, точнее, разновидности его воплощений. Если совсем коротко резюмировать наш сегодняшний материал, то:

  1. ИИ относится к устройствам, проявляющим в той или иной форме человекоподобный интеллект.
  2. Существует множество разных методов ИИ, но одно из подмножеств этого большего списка — машинное обучение — оно позволяет алгоритмам учиться на наборах данных.
  3. Нейронные сети — это разновидность алгоритмов машинного обучения, построенных по аналогии с реальными биологическими нейронами человеческого мозга.
  4. Ну и, наконец, глубокое обучение — это подмножество машинного обучения, использующее многослойные нейронные сети для решения самых сложных (для компьютеров) задач.

Сегодня мы с вами являемся, по сути, свидетелями рождения искусственного разума.

Только задумайтесь: ИИ применяется сейчас практически везде. Скоро даже в сельском туалете можно будет получить контекстную рекламу на основе ваших персональных рекомендаций. И это далеко не всё. ИИ уже проходит тесты на “человечность”, может заменять нам собеседника и создавать произведения искусства. Что же дальше? Создание общего и сильного ИИ и порабощение человечества?

Так все-таки ИИ — это хорошо или плохо? И главное — сделает ли ИИ нас бессмертными? Можно ли будет оцифровать сознание?

Искусственный интеллект «оживил» постеры фильмов в онлайн-кинотеатре KION

Компания MTS AI решила применить искусственный интеллект, чтобы в сервисе KION появились «живые» или «ожившие» постеры фильмов и сериалов.
aka_opex 12 марта 2022 в 04:07

Компания MTS AI обучила искусственный интеллект и алгоритмы компьютерного зрения генерировать постеры для фильмов и сериалов, размещенных на стриминговой платформе KION. Мы уже как-то рассказывали про разные изображения фильмов, которые показываются разным пользователям в стриминговых сервисах, ведь правильно подобранное изображение повышает шансы на то, что зритель захочет посмотреть тот или иной фильм или сериал.

Федор Ежов, директор по технологиям и продуктам МТС Медиа/KION: «Онлайн-кинотеатр KION сейчас предлагает аудитории в общей сложности более 13 тысяч наименований контента, включая контент партнеров, эксклюзивные и со-эксклюзивные картины и более 24 оригинальных сериалов и фильмов из линейки KION Originals. Мы активно развиваемся по техническим направлениям платформы, укрепляем наше контентное предложение, получаем признание индустрии и зрителей. Технологии на базе компьютерного зрения  помогают делать наш продукт еще более комфортным для пользователей, а нам — экономить ресурсы на ручные настройки, переходя к автоматизированным инновационным решениям».

Искусственный интеллект оценивает видео по нескольким характеристикам. В первую группу критериев вошли эстетические: соблюдение правил композиции, отсутствие закрытых глаз и другие. Во вторую группу включили стилистические критерии: нейросети отбирали кадры, которые больше всего похожи на те, что обычно размещают на постерах. Это крупные планы актёров — так называемые клоуз-апы, — а также значимые фрагменты, когда, например, герои берут в руки оружие и готовятся к бою.

В итоге нейросеть определяет несколько «претендентов» для попадания на постеры. При этом количество отобранных кадров минимально. Если раньше редакторам платформы приходилось самостоятельно отсматривать огромные объемы контента и выбирать нужный кадр, то сейчас они выбирают всего из нескольких подобранных системой вариантов.

«Надеюсь, что разработанная нами технология автоматической генерации постеров не только облегчит жизнь редакторам KION, но и поможет зрителям в выборе наиболее интересного для них контента», — Александр Шершебнев, руководитель группы компьютерного зрения MTS AI.

Искусственный интеллект также проверяет готовые изображения и подписи к ним на предмет запрещенного контента, а также на соответствие стилю и внутренним правилам онлайн-кинотеатра KION. Например, на постерах к сериалам на мультимедийной платформе не должно быть надписей вроде «Скоро в кино», как на афишах, анонсирующих выход фильма. На первом этапе нейросеть проверила все загруженные постеры и нашла несколько некорректных, которые впоследствии компания заменила. Сейчас тестирование подготовки и проверки постеров с помощью искусственного интеллекта продолжается.