На презентации Made by Google в Нью-Йорке компания показала сразу четыре смартфона серии Pixel 11 на новом чипе Tensor G6. Базовая модель получила 12 ГБ оперативной памяти и 256 ГБ накопителя, а экраны флагманов теперь светят до 3600 нит. Складной Pixel 11 Pro Fold стал на 1 мм тоньше и на 10% легче предыдущего поколения.
Часы Pixel Watch 5 работают на чипе Qualcomm Snapdragon W5 Gen 2 и получили расширенные функции анализа здоровья. Новинкой линейки стала метка для поиска вещей Pixel Tag с чипом UWB, которая держит заряд до года от одной батарейки. Продажи стартуют 20 августа, цены в США начинаются от 899 долларов за Pixel 11.
Яндекс проведёт конференцию Deep Tech Night с бывшим директором Google X
В Москве 5 сентября пройдет Deep Tech Night, посвящённая вызовам, с которыми ИТ-индустрия сталкивается в эпоху ИИ. Конференцию проведет Яндекс.
В московском офисе Яндекса пройдёт конференция Deep Tech Night, посвящённая вызовам, с которыми ИТ-индустрия сталкивается в эпоху ИИ. Мероприятие будет доступно онлайн и пройдет 5 сентября.
Одним из ключевых спикеров станет Мо Гавдат — бывший директор по развитию бизнеса Google X, исследовательской лаборатории Google. Он расскажет о том, как генеративные нейросети меняют роль разработчика и как могут эволюционировать инженерные команды.
В программе также выступления специалистов Яндекса. Алексей Гусаков, руководитель управления машинного интеллекта и исследований, разберёт устройство рекомендательных систем. Иван Сапожков из команды базовой ML-инфраструктуры поговорит о балансе между алгоритмами и производительностью в обучении с подкреплением для больших моделей. Сергей Мельник, руководитель сервиса автономного транспорта и роботов, расскажет о физическом ИИ — системах, принимающих решения в реальном мире, и о роли симуляции в их разработке.
Alphabet продаёт акции на $85 млрд — рекорд ради ИИ-инфраструктуры
Alphabet продала акции на $85 млрд рекорд истории. $10 млрд взял Баффет. Деньги идут на ИИ-дата-центры при капрасходах $725 млрд у четырёх гиперскейле
Alphabet установила абсолютный рекорд крупнейшей эмиссии акций в истории, разместив бумаги на $80–85 млрд, включая $10 млрд Berkshire Hathaway Уоррена Баффета, — для финансирования строительства ИИ-дата-центров. Для сравнения: рекорд принадлежал бразильской Petrobras с её $70 млрд в 2010 году. Google Cloud вырос на 63% год к году до $20 млрд выручки в первом квартале, бэклог удвоился до $460 млрд.
Четыре крупнейших гиперскейлера — Alphabet, Microsoft, Amazon и Meta — в начале 2026 года планировали потратить $650 млрд на ИИ-инфраструктуру; уже через несколько месяцев цифра выросла до $725 млрд. Это 94% их операционного денежного потока — поэтому компании выходят на долговые и акционерные рынки. Баффет, не покупавший ни одной крупной технологической бумаги со времён Apple, впервые ставит на Google — и это само по себе сигнал рынку. Anthropic уже подала конфиденциальную заявку на IPO, OpenAI готовится сделать то же самое
Искусственный интеллект заменит Яндекс и Google? Большая история поиска в интернете
От первого поисковика Archie до ИИ-поиска: история интернет-поиска, Google, Яндекс и будущее с нейросетями и AGI
Ещё каких-то тридцать пять лет назад интернет был совершенно жутким местом. Действительно настоящей паутиной — запутанной, непроходимой и лишённой каких-либо ориентиров. Только представьте себе: чтобы найти нужный ресурс, вам приходилось искать его адрес в газете или специальном печатном каталоге. Да, речь идёт о времени до изобретения поиска в интернете.
А ведь, если задуматься, именно поиск изменил нашу жизнь и десятикратно облегчил доступ к информации. Это напоминает то, что сейчас, в 2025 году, происходит с искусственным интеллектом. Не находите?
В этой статье мы проследим весь путь поиска в интернете: как он зародился, как работает, почему он столь важен и, главное, какое будущее его ждёт.
Поиск вчера: от газетных вырезок до алгоритмов
Условно историю поиска можно поделить на три эпохи: каким он был вчера, что представляет собой сегодня и каким станет завтра. Давайте по порядку.
Главная проблема интернета прошлого — это отсутствие нормальной поисковой системы. Выкручивались все по-разному. Кто-то записывал на бумажке нужные ссылки. В кружках по интересам печатали журналы с адресами полезных ресурсов, а иногда информация передавалась просто из уст в уста, по старинке. Конечно, существовали и веб-подборки — специальные страницы, на которых можно было вручную искать нужный интернет-сайт. Не слишком удобно, но такая ситуация была вполне логичной: контента было мало, пользователей тоже, и в основном это были технические энтузиасты. Бизнеса в интернете не существовало как такового.
Archie — первый поисковик в истории
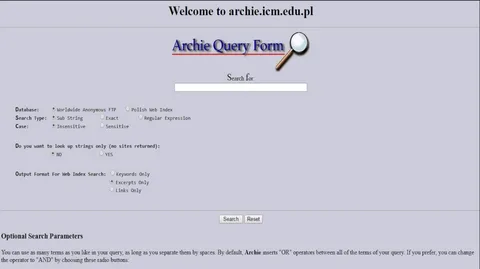
И вот молодой канадский студент по имени Алан Эмтейдж (Alan Emtage) устал от такого положения дел. Осенью 1990 года он представил первый в истории поисковик интернета — Archie (сокращение от «Archives»). Конечно, по нынешним меркам это была примитивная система, но даже в таком виде она значительно упростила жизнь людям.
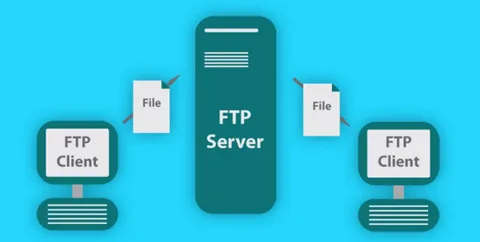
Archie объединял и индексировал содержимое общедоступных FTP-серверов. Возможно, кто-то ещё помнит такие «FTP-шники»: в те времена именно там можно было скачать игры вроде Duke Nukem, аниме или любой другой контент. Сервис собирал воедино названия файлов, а пользователю нужно было лишь ввести нужное ключевое слово. Проблема заключалась в том, что если в названии файла была ошибка, то Archie просто не мог его обнаружить.
Однако начало было положено. Цель тогда была проста: быстро находить хоть какую-либо подходящую информацию.
Индексация: библиотечная картотека для всего интернета
Чтобы двигаться дальше в изучении поиска, необходимо разобраться с одним чрезвычайно важным термином — индексация. Что вообще означает «проиндексировать интернет»?
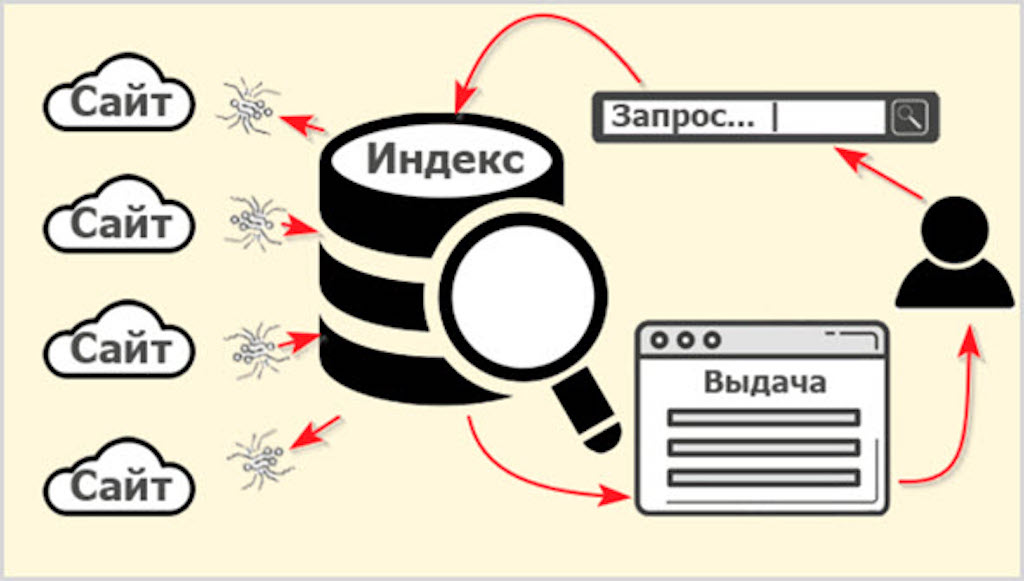
Чтобы любой поисковик мог найти нужный ответ, ему сначала необходимо создать некую базу данных, в которой этот ответ будет храниться. Но ведь весь интернет — это колоссальный объём данных. По некоторым оценкам, речь идёт о нескольких зеттабайтах. Для понимания масштаба: один зеттабайт равен миллиарду терабайт. А по данным на 2025 год, в интернете накоплено уже несколько десятков зеттабайт информации. Естественно, поисковик физически не может пропускать через себя каждый раз такой массив данных. Именно поэтому было найдено подходящее решение — индексация.
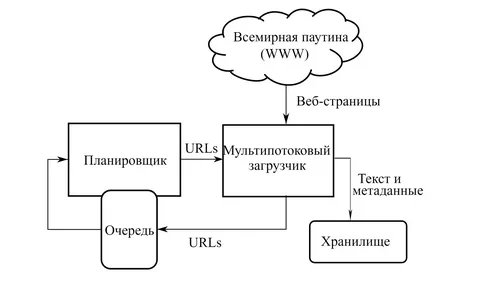
Принцип прост. Специальный поисковый бот регулярно обследует всё интернет-пространство и обрабатывает информацию. Сначала программа-планировщик выстраивает маршрут для обхода сайтов. Этот маршрут зависит от важных характеристик сайтов — например, их цитируемости или частоты обновления. Затем планировщик передаёт этот маршрут другой части поискового робота — так называемому «пауку» (crawler). Паук обходит документы по заданному маршруту, и если сайт работает и доступен, он выкачивает содержимое и отправляет его в хранилище.
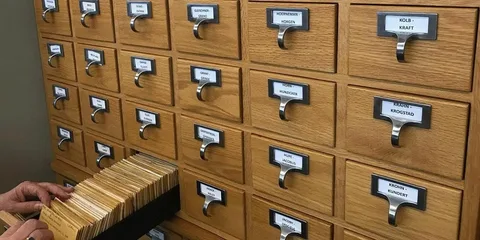
Таким образом, бот создаёт нечто вроде слепка интернета — библиотечной картотеки, если угодно, которая хранится на серверах. Туда переносится не весь интернет целиком, а только полезная информация — без спама, дубликатов и прочих ненужных документов. В результате получаются проиндексированные веб-страницы: поисковик знает адрес, по которому находится подходящий запросу пользователя контент — слова, изображения или любые другие данные.
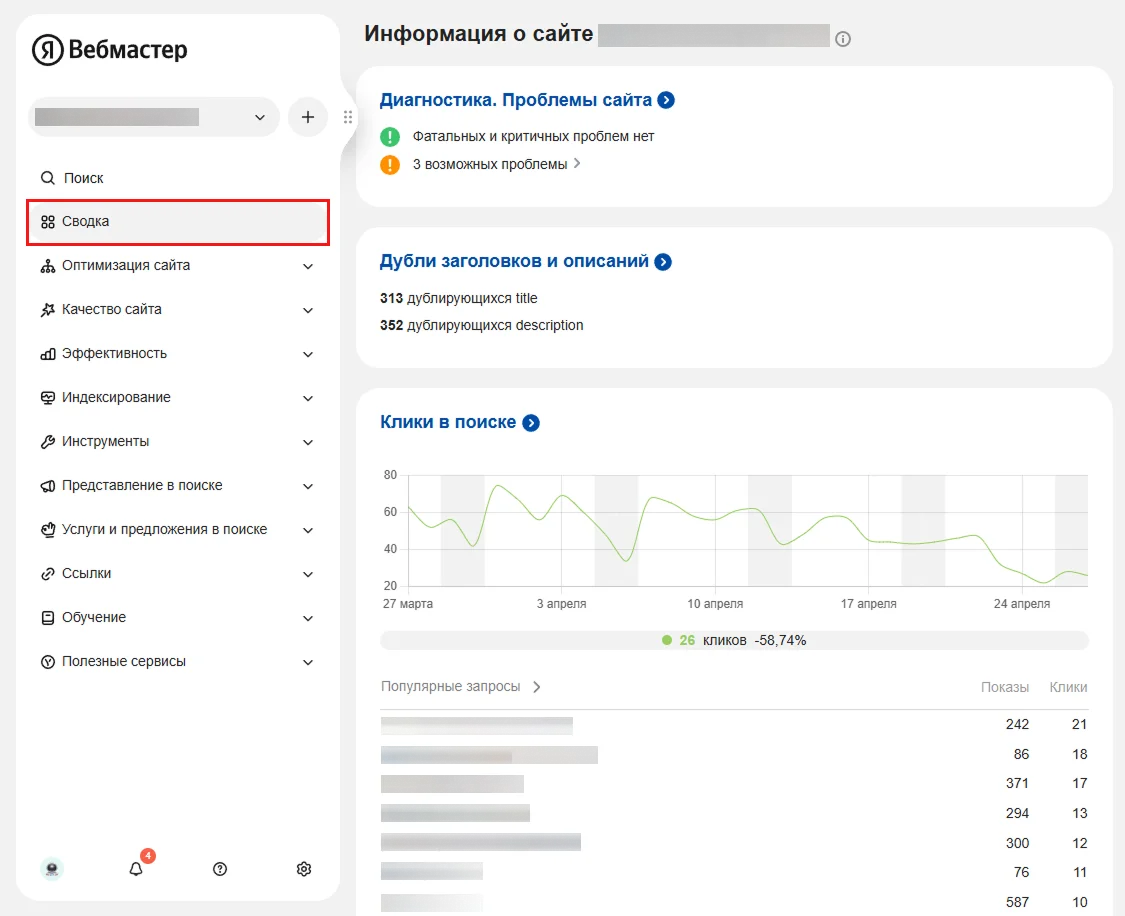
После индексации слепок веб-сайта добавляется в регулярно обновляемую базу данных, чтобы поиск не занимал много времени. Визуально увидеть проиндексированную веб-страницу обычный пользователь не может, однако с помощью специального инструмента это всё же возможно. Например, у Яндекса существует сервис Вебмастер, где можно проверить свой ресурс на индексацию.
Таким образом, проиндексированные веб-страницы — это важнейший элемент любого поисковика, будь то Google, Microsoft Bing или Яндекс. Без подобной картотеки оперативно находить нужную информацию попросту невозможно.
WebCrawler — стандарт на десятилетие
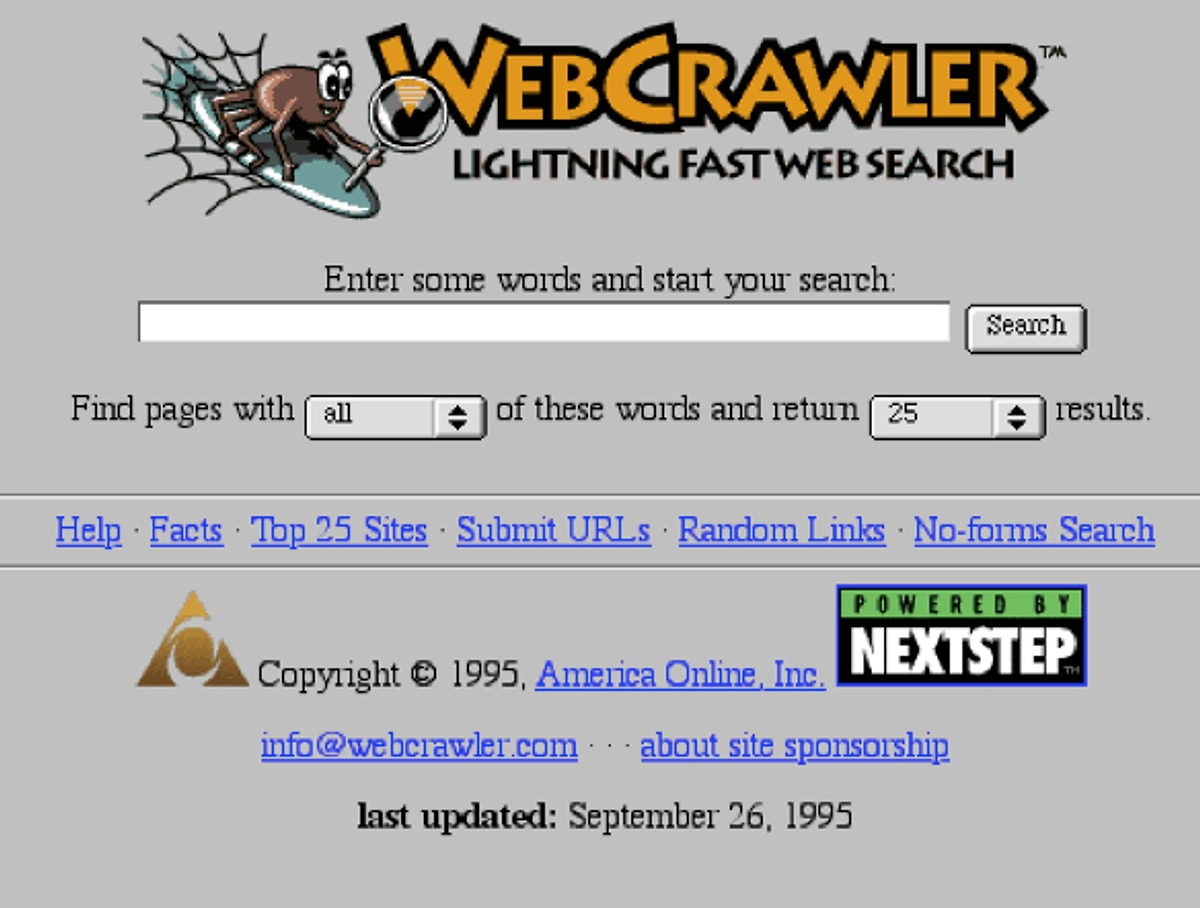
Первым поисковиком, который стал использовать индексацию в более или менее современном виде, стал WebCrawler, запущенный в 1994 году. Его робот-«паучок» собирал информацию со всей сети, индексировал её и вносил в собственную базу данных. Разработка имела огромный успех и, в сущности, задала стандарт на десятилетие вперёд. Даже сейчас принципы, которые заложил WebCrawler, продолжают работать в основе современных поисковых систем.
Морфология языка: как Яндекс покорил великий и могучий
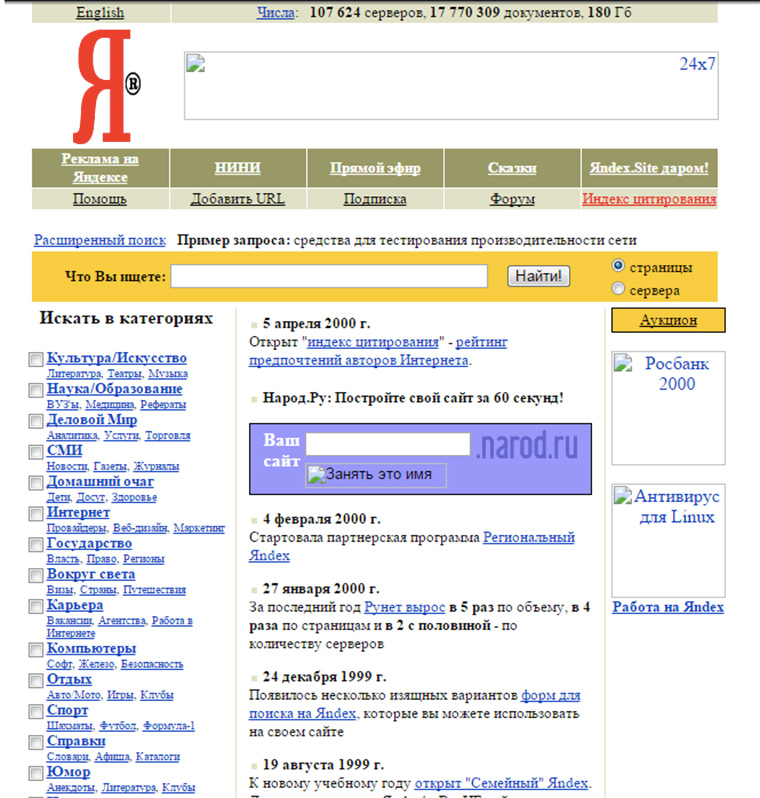
Но просто собрать и проиндексировать информацию — это лишь половина дела. Главное — правильно понять, что именно ищет пользователь. И здесь особенно интересен опыт Яндекса в работе с морфологией русского языка.
Дело в том, что поисковой системе необходимо находить не просто точное совпадение слов, а понимать смысл запроса. Подумайте сами: слово «шляпка» может относиться к грибу, головному убору или гвоздю. Русский язык полон подобных многозначных слов, что делает задачу на порядок сложнее, чем в английском.
Именно поэтому так показателен пример Яндекса. Компания анализировала, как часто слова встречаются вместе в текстах, используя данные Национального корпуса русского языка. Если пользователь ищет, например, «воронежский», система может автоматически добавить к поиску слово «Воронеж».
Яндекс также научился различать языки, чтобы не путаться при обработке запросов. Система определяла язык запроса по алфавиту, характерным сочетаниям букв и даже по региону пользователя. И, разумеется, люди постоянно допускают опечатки — примерно 12% поисковых запросов содержат ошибки. Поэтому поисковик автоматически проверял запрос на грамотность и предлагал исправленную версию.
Вот так, в зависимости от особенностей языка, поисковики справлялись с проблемами человеческих запросов.
Google и революция PageRank
Существовало и множество других поисковиков того времени — AltaVista, Excite и другие. Функционал у всех был примерно одинаковым, поэтому подробно останавливаться на каждом не имеет смысла. Важны первые и по-настоящему революционные.
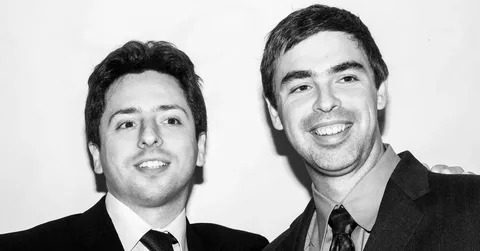
Примерно в это же время, в 1998 году, два аспиранта из Стэнфордского университета — Сергей Брин и Ларри Пейдж — разработали поисковик Google. О нём, конечно, можно рассказывать долго. Но на самом деле важен не столько сам поисковик, сколько технология, которую для него разработали эти двое. Она называется PageRank.
Это была по-настоящему революционная вещь. Давайте разберёмся, в чём заключалась основная проблема поисковиков того времени. Да, благодаря индексации они могли находить ресурсы с нужной информацией, но вот качество найденных сайтов оставалось под большим вопросом. Грубый пример: если бы вы дали поисковику того времени запрос «как поменять лампочку», на первом месте мог бы оказаться не форум электриков, а сайт анекдотов. То есть релевантность поиска была практически на нуле.
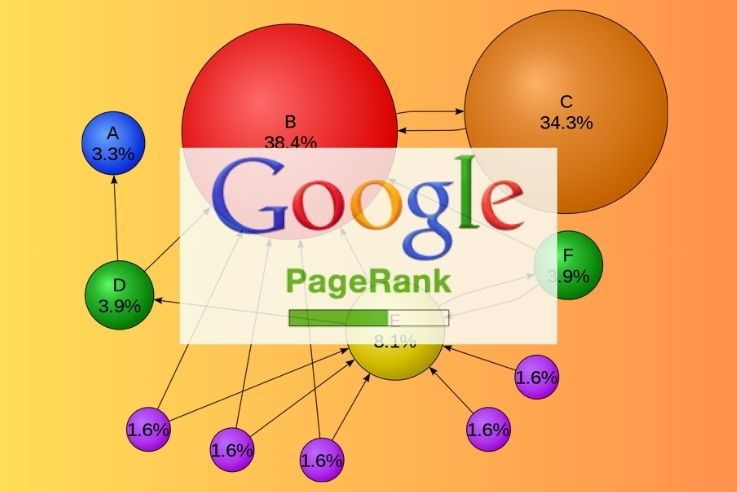
PageRank же делал простую, но гениальную вещь. Алгоритм присваивал каждой странице показатель важности. Чем больше ресурсов в интернете ссылалось на определённую веб-страницу, тем более важной она становилась. Соответственно, при запросе пользователя на первые позиции выходила ссылка на тот ресурс, который зарекомендовал себя в интернете. Просто и изящно.
Внедрение PageRank совершило настоящую революцию в зарождающейся отрасли поисковых систем. Буквально за считанные месяцы все конкуренты создали аналогичные системы ранжирования. Со временем аналоги PageRank эволюционировали в нечто гораздо более сложное, где учитывалось множество факторов — вплоть до местоположения пользователя. Но об этом чуть позже.
MatrixNet от Яндекса: машинное обучение раньше всех
Кстати, поиск от Яндекса и сама компания в целом были важными первопроходцами в индустрии. Разработчики Яндекса буквально первыми стали использовать машинное обучение в поиске, когда Google ещё даже не задумывался об этом.
В 2009 году Яндекс сделал важный шаг в развитии поисковых технологий, начав использовать машинное обучение (ML — Machine Learning) значительно раньше Google. Компания разработала собственную технологию под названием MatrixNet, которая совершила настоящий прорыв в области поисковых систем.
К тому моменту интернет уже был огромным, и по некоторым запросам находились миллионы страниц. Просто показать все сайты, содержащие слова из запроса, было уже недостаточно — ведь пользователю пришлось бы целую вечность листать страницы с результатами. Требовалось научиться определять, какие страницы действительно отвечают на вопрос пользователя.
Для этого поисковик анализировал множество факторов: как часто встречаются слова из запроса, сколько на сайт ведёт ссылок, насколько он популярен у пользователей, и так далее. Всего таких факторов были тысячи, и первоначально они отслеживались вручную. Специалисты-эксперты — так называемые асессоры — помогали системе учиться, оценивая качество результатов поиска. Они оценивали конкретные страницы по конкретным запросам, и затем на этих оценках обучалась формула, которая ранжировала сайты по любому запросу.
Главная особенность MatrixNet заключалась в том, что он мог автоматически работать с огромным количеством таких факторов и при этом не переобучаться. То есть формула ранжирования сайтов стала подбираться на основании всех известных факторов и знаний о том, какие страницы лучше соответствуют запросу, а какие — хуже. Обычные алгоритмы в подобной ситуации начинали находить несуществующие закономерности, а MatrixNet оставался точным.
Более того, сама система могла настраивать поиск для разного типа запросов. Например, можно было улучшить поиск по музыке, не испортив при этом поиск по другим темам. А ещё MatrixNet был невероятно быстрым: он успевал проверить все факторы за доли секунды. Всё это работало на тысячах серверов одновременно — каждый искал по своей части интернета, находил лучшие результаты, а потом они объединялись в единый список, и пользователь практически мгновенно получал именно те сайты, которые ему были нужны.
Эта технология стала важнейшим шагом в развитии поиска. Она позволила учитывать намного больше факторов, чем раньше, и при этом делать это точно. С появлением MatrixNet поиск стал значительно умнее — он начал гораздо лучше понимать, чего хочет пользователь.
Самое забавное: технология настолько опередила своё время, что инженерам Яндекса пришлось сооружать инсталляцию из водяных труб, чтобы наглядно объяснить журналистам, что такое машинное обучение.
Три кита поиска прошлого
Подведём итог «поиска вчера» и назовём три главных кита, на которых он держится:
Индексирование веб-страниц — создание своеобразной картотеки всего интернета.
Настройка релевантности поиска — по типу PageRank от Google.
Машинное обучение — впервые полноценно применённое Яндексом в 2009 году.
Поиск сегодня: от тысяч факторов до нейросетей
Нынешние поисковые системы эволюционировали в совершенно невероятные сервисы, которыми мы пользуемся каждый день. Когда компании осознали, что на продаже рекламы на самых посещаемых ресурсах интернета можно прекрасно зарабатывать, организации, которые изначально просто занимались поиском веб-страниц, превратились в настоящих технологических гигантов. Достаточно посмотреть на Google или Яндекс и оценить, в скольких сферах они присутствуют сегодня.
С расширением интернета стало очевидно, что искать нужно не только сайты, но и отдельные видеоролики, изображения, рестораны, природные локации и многое другое. Работы меньше не стало — интернет за последние десятилетия вырос многократно.
Предугадывание запросов
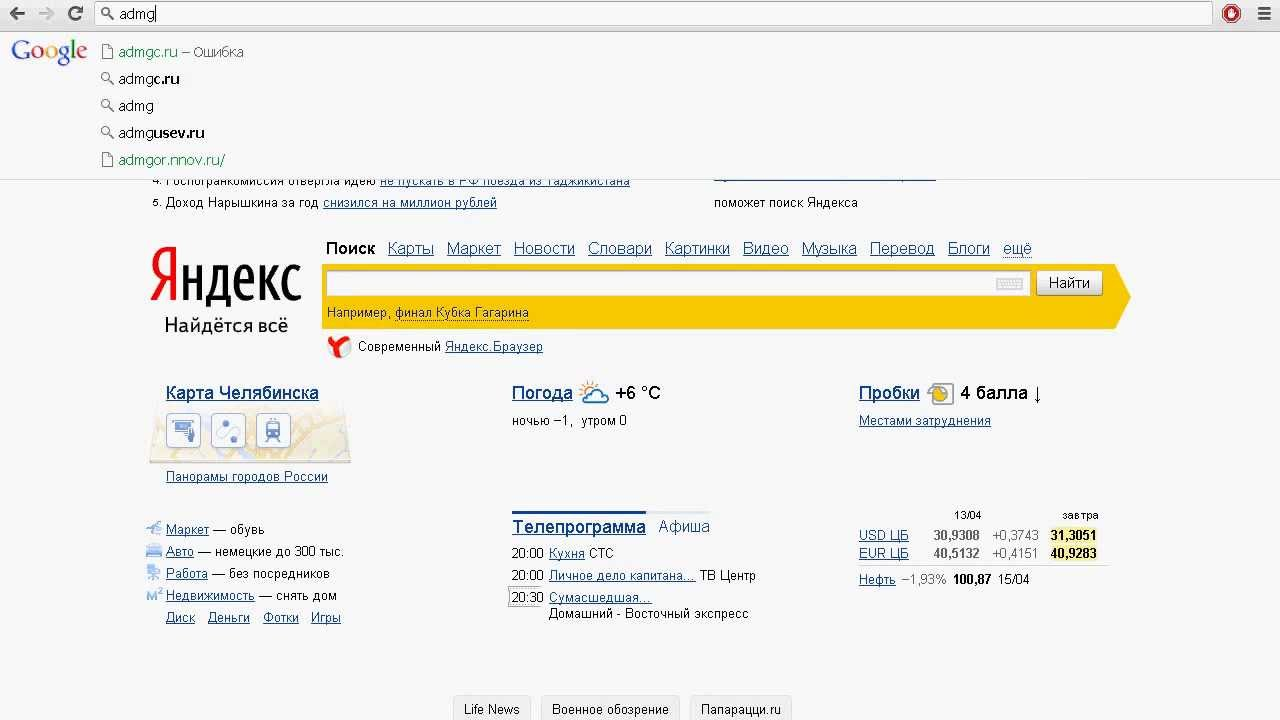
Например, чтобы ускорить поиск информации, появилась функция угадывания запроса пользователя. Специальный алгоритм запоминал, к какому слову привязана самая частая продолжающая связка — с учётом местоположения пользователя, самых частых запросов и множества других факторов. Если человек начинает вводить запрос «кто такой», поисковик мгновенно предлагает несколько вариантов продолжения. Попробуйте проверить это сами — результаты могут удивить.
От единиц к тысячам факторов
По сути, все технологии из «поиска вчера» перекочевали в «поиск сегодня», но на совершенно иных мощностях. Если раньше использовались лишь несколько метрик (вспомните PageRank от Google), то сегодня поисковики оперируют тысячами факторов ранжирования. Давным-давно для присвоения статуса полезности нужна была всего одна метрика — цитируемость ссылки. Теперь же алгоритмы анализируют колоссальное число параметров. MatrixNet от Яндекса, о котором мы уже рассказали, в своё время был именно таким исключением — он опережал эпоху.
Администрировать эти тысячи факторов вручную, естественно, невозможно. И тут на помощь приходит машинное обучение.
RankBrain от Google: поиск вещей, а не строк
Нейросети прочно вошли в нашу жизнь. С их помощью мы генерируем изображения, создаём видео, пишем тексты. И революция, которая происходит вокруг нас сейчас, стала возможной в том числе благодаря поиску в интернете. Ведь прародителями современных нейросетей с начала 2010-х годов стало именно машинное обучение.
Google тоже не стоял на месте. В 2015 году компания представила технологию RankBrain, и поисковик научился искать вещи, а не строки.
Чтобы обучить алгоритмы, инженеры Google сначала «скармливали» ему данные из различных источников, чтобы он начал их сопоставлять и упорядочивать выдачу на основе этих вычислений. Затем RankBrain наблюдал, как пользователи взаимодействуют с результатами поиска, созданными при помощи машинного обучения. Если пользователи оставались довольны результатами, алгоритм продолжал работать в том же направлении. Если результат не устраивал — машина начинала процесс заново.
RankBrain также оценивал релевантность контента на странице. Речь шла не только о сопоставлении ключевых слов, но и о глубоком понимании контекста. Он мог различать фрагменты, которые затрагивают разные аспекты и подтемы, связанные с основной темой запроса.
В целом, RankBrain выполнял две основные задачи. Во-первых, учился понимать поисковые запросы — их смысл и ключевые слова на веб-страницах. Во-вторых, измерял удовлетворённость пользователя результатами и подстраивался соответственно.
Нейросети-трансформеры: поиск по смыслу
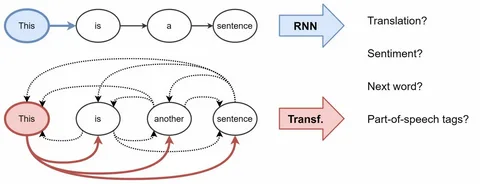
Внедрение машинного обучения многократно улучшило опыт поиска. Он стал значительно персонализированнее и намного умнее. Именно благодаря нейросетям нового типа — так называемым нейросетям-трансформерам — и Google, и Яндекс научились понимать смысл запроса, а не просто искать совпадения слов.
Например, сегодня можно написать в поисковой строке «фильм, где мужчина выращивает картошку на Марсе», и вы получите множество релевантных ссылок с правильным ответом — фильм «Марсианин». Всё это происходит потому, что поисковик понимает смысл запроса, а не просто ищет ключевые слова на страницах.
Поиск завтра: эра искусственного интеллекта
Однако всё вышесказанное — лишь часть картины. Речь не только о машинном обучении. За последние несколько лет произошла настоящая революция — появились чатботы на основе больших языковых моделей.
На самом деле поиск будущего уже среди нас, и его можно смело назвать поиском настоящего. Это третий этап в развитии интернета и в поведении пользователей. Теперь в интернете есть все и всё: бизнес, инвестиции, сильные команды и продукты. Сейчас недостаточно просто находить актуальную информацию быстро. Теперь важно быстро находить самое лучшее из всего существующего контента.
У чатбота можно узнать практически что угодно, причём максимально персонализированно. В последний год компании массово внедряют чатботов в свои поисковые системы.
Экзистенциальный кризис поисковиков
Любопытно, что когда чатботы только начали появляться, поисковые компании пережили своего рода экзистенциальный кризис. Google вообще ввёл «красный код» внутри компании и стал считать ChatGPT своей главной угрозой. Однако спустя время стала очевидна одна крайне важная вещь: чатботы ошибаются. Причём не просто ошибаются, а порой галлюцинируют — выдумывают факты, которых не существует в реальности.
Простыми словами, чатбот, который должен был стать абсолютным поиском, оказался неспособен в одиночку справиться с этой задачей. Однако решение проблемы нашлось: объединить чатбота и поисковую систему.
Симбиоз: чатбот + поисковая система
Выгода от подобного симбиоза получается превосходная. Чатбот естественным языком отвечает на поставленный вопрос, превосходя все алгоритмы прошлого в десятки раз. С ним можно просто разговаривать как с человеком, и нет необходимости переходить по множеству ссылок, потому что вся информация суммируется сразу в один готовый ответ. А технологии поиска, в свою очередь, помогают чатботу находить достоверную и актуальную информацию, подкрепляя ответ релевантными ссылками на источники.
Copilot от Microsoft
Одним из первых представителей такого подхода стал Copilot от Microsoft. Компания инвестировала миллиарды долларов в OpenAI и встроила в свой поисковик Bing на тот момент самый мощный чатбот в истории — GPT-4 Turbo. То есть технология поиска работала совместно с чатботом, чтобы выдать максимально персонализированный результат.
Google AI Overviews и Gemini
Google же решила подойти к проблеме более фундаментально. В мае 2024 года компания представила собственную модель Gemini, специально адаптированную для поиска. Система получила название AI Overviews и работает через так называемые «ИИ-обзоры».
Когда пользователь задаёт вопрос, Gemini не просто ищет информацию, но анализирует её, структурирует и представляет в удобном формате. При этом система всегда указывает источники информации, позволяя пользователю проверить данные.
Одна из самых интересных возможностей — анализ видео для поиска решения технических проблем. Например, если у вас сломался проигрыватель виниловых пластинок, достаточно снять короткое видео проблемы, и система поможет найти решение.
Google также анонсировала системы, которые не только помогают с поиском, но и выполняют действия за пользователя. Например, можно написать: «Купи билет из Москвы в Стамбул», и нейросеть самостоятельно оформит покупку.
SearchGPT от OpenAI
Не остаётся в стороне и сама компания OpenAI. В конце 2024 года она представила собственный поисковик SearchGPT (впоследствии интегрированный в ChatGPT как функция поиска). Он объединяет возможности языковой модели GPT-4o с прямым доступом к актуальной информации из интернета.
SearchGPT работает принципиально иначе, нежели привычные поисковики. Когда вы задаёте вопрос, система не просто выдаёт список ссылок, а сразу формирует подробный ответ, основанный на данных из различных источников. При этом каждый факт в ответе сопровождается ссылкой на первоисточник — будь то новостная статья, научная публикация или специализированный блог.
В SearchGPT также появились специальные визуальные форматы для определённых типов запросов. Например, при поиске погоды пользователь видит детальный прогноз с графиками. При запросе котировок — биржевые данные в реальном времени. Для спортивных событий — актуальное расписание матчей и результаты.
Однако подобные решения, разумеется, есть и у других игроков рынка. И в этом отношении OpenAI пока остаётся в роли догоняющего. Главное преимущество SearchGPT — это возможность вести полноценный диалог: можно задавать уточняющие вопросы, и система будет учитывать контекст всего разговора.
Яндекс и поиск с Нейро
Отечественные разработчики тоже не отстают. В октябре 2024 года Яндекс представил масштабное обновление своего поисковика, интегрировав в него технологию Нейро. Поиск с Нейро работает по той же модели: он сразу даёт ответ на вопрос, ссылаясь на источники в интернете. Система автоматически определяет, когда её помощь будет действительно полезна, и появляется в результатах поиска самостоятельно. Если же нейросетевой ответ не был показан автоматически, достаточно нажать на специальную кнопку под поисковой строкой.
Поиск с Нейро умеет работать со сложными составными вопросами, и с ним можно вести полноценный диалог, поскольку он понимает контекст. Например, вы можете спросить: «Какая сегодня ключевая ставка?» А потом просто уточнить: «А когда изменится?» И поиск ответит датой следующего заседания Центрального банка. Раньше для этого пришлось бы делать два полноценных независимых поисковых запроса.
Кроме того, система научилась работать и с изображениями. В поиске по картинкам или через умную камеру можно задавать вопросы о конкретных деталях на фотографии. Сфотографировали автомобиль — и просто спросили, сколько он стоит. Не нужно знать марку и модель: вы сразу получаете готовый ответ. А если на фотографии рядом с основным объектом присутствует другой предмет — например, велосипед — поиск поймёт контекст и всё равно ответит именно про автомобиль.
Более того, можно сфотографировать задачу по математике для девятого класса, и поиск самостоятельно её решит — даже если такой задачи нет в интернете. (Простите за это опасное знание.)
Поиск завтрашнего дня: AGI и абсолютная персонализация
Всё описанное выше — это поиск сегодня, и мы уже живём с ним бок о бок. Но что ждёт нас в будущем?
По прогнозам экспертов, в ближайшее время поиск сможет давать ответы на основе не только текстовой, но вообще любой информации в интернете — например, на основе содержимого конкретного видеоролика.
Однако использование нейросетей в связке с поиском — это, по всей видимости, промежуточный вариант. Настоящий поиск будущего должен быть связан с AGI — Artificial General Intelligence, то есть так называемым «настоящим» искусственным интеллектом. Не просто алгоритмом, который пытается угадать, что хочет пользователь, а полноценным цифровым разумом, способным мыслить и понимать.
Только представьте, насколько поиск станет совершеннее, когда у вас появится собственный ассистент, который знает вас лучше, чем кто-либо другой, и способен буквально по первым нескольким буквам угадать, что вам нужно. А с учётом того, как стремительно всё развивается в 2025 году, подобный поиск мы, возможно, увидим достаточно скоро.
Судите сами: нынешние технологии уже умеют искать по тексту и изображениям, вести с пользователем полноценный диалог, а персонализированный ИИ-ассистент сможет делать всё это индивидуально для каждого.
Персонализация — вот главная черта поиска будущего, если всё пойдёт так, как предрекают лидеры индустрии.
Заключение
История интернет-поиска — это история человеческого стремления к знаниям. От бумажных каталогов и примитивного Archie в 1990 году — через революцию PageRank и MatrixNet — к нейросетевым ассистентам, которые разговаривают с нами на естественном языке. Каждый этап этой эволюции делал доступ к информации проще, быстрее и точнее.
Сегодня мы стоим на пороге новой эпохи, в которой границы между поисковой системой и интеллектуальным собеседником окончательно стираются. И если прошлое научило нас чему-то, то это тому, что следующий скачок может произойти быстрее, чем кто-либо из нас ожидает
Google запускает $99 Fitbit Air — умный браслет без подписки против WHOOP
Google выпустила Fitbit Air за $99 без подписки — прямой конкурент WHOOP. Трекер здоровья без экрана: пульс, сон, восстановление с интеграцией Gemini.
Google запустила Fitbit Air за $99, главный конкурент WHOOP без обязательной подписки. Это принципиальный разрыв с бизнес-моделью WHOOP, которая требует ежемесячных платежей за доступ к данным. Fitbit Air предлагает базовые метрики: пульс, сон, шаги, восстановление без дополнительных расходов.
Запуск происходит в момент, когда рынок носимой электроники переживает любопытный раскол. С одной стороны — дорогие смарт-часы с экранами, GPS и платёжными системами (Apple Watch Ultra, Galaxy Watch 8 Ultra). С другой минималистичные трекеры без экрана, ориентированные исключительно на здоровье: WHOOP, Oura Ring, теперь Fitbit Air. Google делает ставку на массового пользователя, которому не нужны уведомления на запястье, но важно следить за сном и восстановлением. Интеграция с Gemini для персональных рекомендаций по здоровью очевидное следующее обновление.
Anthropic заключила крупнейшую сделку по вычислительным мощностям с Google и Broadcom
Anthropic зафиксировала несколько гигаватт TPU-мощностей от Google и Broadcom. Крупнейшая сделка в истории компании. Поставки — с 2027 года.
6 апреля Anthropic объявила о подписании нескольких гигаватт мощностей TPU следующего поколения — крупнейшем обязательстве по вычислительным ресурсам за всю историю компании. Партнёрами сделки выступили Google Cloud и Broadcom. Чипы начнут поступать с 2027 года и должны обеспечить рост инфраструктуры пропорционально спросу: годовой объём выручки компании уже превышает $30 млрд.
Стратегический смысл в диверсификации: Anthropic использует одновременно AWS Trainium, Google TPU и GPU от Nvidia — в отличие от OpenAI, жёстко привязанной к инфраструктуре Microsoft. Это снижает зависимость от единственного поставщика и даёт рычаги при переговорах. Для Google сделка подтверждает конкурентоспособность TPU против Nvidia; для Broadcom — гарантирует крупный заказ на специализированную ИИ-логику.
Google Gemini 3.1 Pro скачок разума всего за три месяца
Google выпустила Gemini 3.1 Pro с удвоенным reasoning и 77,1% на ARC-AGI-2. Темпы обновлений ускорились — прямая атака на GPT-5 и Claude.
20 февраля Google выпустила Gemini 3.1 Pro — первый раз в истории компания использует инкремент к приставке «.1» вместо привычного «.5». Модель удвоила мощность рассуждения (reasoning performance) по сравнению с Gemini 3 Pro и достигла 77,1% на ARC-AGI-2 бенчмарке — тесте, который проверяет способность ИИ решать совершенно новые логические паттерны.
Отмечается, что это не просто улучшение показателей для статистики. Google фокусируется на создании полноценного агента с возможностями выполнения разных задач (agentic workflows) и более улучшенными возможностями рассуждений для задач, которые требуют глубокий ответ. Модель умеет генерировать анимированные SVG-изображения с кодом, строить сложные приложения вроде симуляторов городского планирования, синтезировать огромные датасеты.
Gemini 3.1 Pro доступен в Gemini app для всех, с повышенными лимитами для Google AI Pro и Ultra подписчиков, плюс эксклюзивно в NotebookLM для платных пользователей. Разработчики получают доступ через Gemini API, Vertex AI, Google Antigravity и Android Studio.
Почему это важно: три месяца назад вышел Gemini 3 Pro, теперь Google выкатывает «.1» вместо традиционного полугодового цикла. Это ускорение темпов развития — и прямая атака на OpenAI GPT-5 и Anthropic Claude Opus 4.6. Гонка мощностей рассуждения (reasoning) превращается в спринт, где обновления выходят каждые 90 дней, а не раз в полгода.
Alphabet тратит $185 млрд на ИИ — удвоение бюджета за год
Google удваивает расходы в 2026 году до $185 млрд на ИИ-серверы и дата-центры. Акции упали на 5%: инвесторы задаются вопросом — гениальная ставка или
5 февраля Alphabet шокировала Уолл-стрит: капитальные расходы в 2026 году составят от $175 до $185 миллиардов — вдвое больше, чем в 2025 ($91,4 млрд), и в полтора раза выше ожиданий аналитиков ($119,5 млрд). Это больше, чем рыночная капитализация 59 компаний из S&P 500.
Куда уйдут деньги? 60% — на серверы (в основном чипы для ИИ), 40% — на дата-центры и сетевое оборудование. Цель — расширение мощностей Google DeepMind, удовлетворение спроса на облако (бэклог вырос до $240 млрд) и развитие Gemini, который уже насчитывает 750 миллионов активных пользователей.
CEO Сундар Пичаи не скрывает: «Что не даёт мне спать по ночам? Вычислительные мощности. Энергия, земля, цепочки поставок — как успеть за этим безумным спросом?» Акции упали на 5% после объявления, несмотря на отличные результаты квартала. Инвесторы боятся: $185 млрд — это инвестиция в будущее или начало пузыря?
Google покупает Intersect Power за $4,75 млрд, строит собственные электростанции и объявляет гонку мощностей. Meta обещает $115-135 млрд, Microsoft и Amazon тоже наращивают бюджеты. Индустрия тратит полтриллиона в год — и всё ради того, чтобы успеть обучить следующую версию ИИ раньше конкурента.
Как Android получил доступ к AirDrop: история технологического прорыва
Как Google и Qualcomm «взломали» AirDrop: теперь Android передает файлы на iPhone. Обзор технологии, DMA и будущее кросс-платформенного обмена.
Представьте ситуацию: вам нужно быстро передать фотографию или рабочий файл с телефона на телефон. Как вы это сделаете? Вряд ли кто-то вспомнит о инфракрасном порте, которым когда-то оснащались мобильные телефоны.
Если у обоих пользователей устройства Apple — считайте, повезло. AirDrop справится с задачей мгновенно. Всё просто, удобно и быстро. У пользователей Android тоже есть свои решения. Но что делать, когда встречаются Android и iPhone? Вот здесь раньше начинались настоящие мучения. По крайней мере, так было до ноября 2025 года.
В ноябре прошлого года Google, а следом за ней и Qualcomm объявили, что поддержка AirDrop приходит на Android. Это заявление вызвало настоящий шквал обсуждений. Почему? Потому что Apple никогда не давала на это официального разрешения.
По сути, Google нашли способ реализовать совместимость с AirDrop, не спрашивая согласия у компании из Купертино. Но как именно инженерам удалось это сделать? Как устроен протокол AirDrop? И почему европейский закон о цифровых рынках оказался тем самым ключом, который открыл закрытую экосистему Apple?
Архитектура AirDrop: больше, чем просто Bluetooth
Многие полагают, что AirDrop — это всего лишь передача файлов по Bluetooth или Wi-Fi. На самом деле это сложная, многослойная технология, которую Apple разрабатывала не один год.
AirDrop — это закрытая peer-to-peer технология Apple для беспроводной передачи файлов, контактов и другого контента внутри собственной экосистемы. Впервые её представили в 2011 году как революционный и самый простой способ передачи файлов. Проще, чем по электронной почте, проще, чем через мессенджеры.
Принцип работы выглядит элементарно: выбрали файл или фотографию, выбрали устройство рядом, нажали одну кнопку — и файл отправлен. Без интернета, без облачных сервисов. Нужны только два устройства Apple, которые соединяются между собой автоматически. Просто, быстро, безопасно. Та самая фирменная магия Apple.
С точки зрения пользователя всё действительно элементарно. Но под капотом технология устроена куда сложнее, чем кажется.
Первый этап: обнаружение и рукопожатие
Технически AirDrop работает в два этапа. Первый шаг — это поиск и обмен метаданными, так называемое рукопожатие.
В основе этого процесса лежит технология Bluetooth Low Energy. Фактически, ваш iPhone постоянно транслирует в эфир сигнал: «Я здесь! Я iPhone! Кто хочет мне что-то прислать?» Это называют BLE-рекламой.
Другие устройства в радиусе нескольких метров улавливают этот сигнал и реагируют соответствующим образом. Разумеется, имя устройства не передаётся в открытом виде — используется шифрование.
Когда iPhone ищет получателей, он на самом деле не транслирует открытым текстом «Я iPhone Валеры». Иначе это был бы кошмар с точки зрения приватности. Вместо этого он рассылает хеш — обрезанный фрагмент сложной зашифрованной строки, созданной на основе Apple ID и номера телефона.
Устройства вокруг принимают этот код и пытают сопоставить его со своей адресной книгой. Если у получателя в контактах записан ваш номер, то есть если математика сходится, его телефон понимает: «О, это же знакомый!» — и показывает аватарку. Если нет, для него это просто бессмысленный набор байтов.
Второй этап: передача данных
Как только устройства обнаружили друг друга и обменялись кодами, они устанавливают прямой Wi-Fi мост. И вот здесь начинается самое интересное.
AirDrop использует не обычный Wi-Fi Direct, а закрытый протокол AWDL — Apple Wireless Direct Link. Этот протокол отвечает за всю фирменную магию не только в AirDrop, но и в AirPlay, Sidecar и Handoff.
Если упрощать, Apple взяла стандартный протокол 802.11 и добавила в него собственные управляющие фреймы, синхронизацию времени и динамическое переключение между каналами. Затем собрала всё это вместе и получила закрытый высокоскоростной туннель, в который не может войти никто посторонний.
Главный технический трюк здесь — сложная синхронизация. Обычный Wi-Fi работает так: устройства постоянно слушают эфир или договариваются через роутер. Но в AWDL роутера нет, всё работает напрямую между устройствами. Тем не менее выбрать главное устройство всё равно приходится.
Каждые сто-двести миллисекунд устройства в радиусе действия выбирают «мастера» — обычно это самый мощный Mac или iPhone с хорошим зарядом батареи. Этот мастер рассылает остальным специальные синхронизирующие фреймы с инструкциями: «Все активируемся ровно через двадцать три миллисекунды на канале 149, потом через сто двадцать миллисекунд переходим на канал 44, затем на 157» — и так далее.
Все устройства подстраиваются под это расписание. Эта хитрость помогает не только экономить заряд батареи, но и не мешать пользователю работать с интернетом. Несколько раз в секунду модем переключается то на интернет, то на передачу файлов.
Так и работает AirDrop. Устройства сначала знакомятся, а потом вместе начинают переключаться между каналами, словно в синхронизированном танце. И никого постороннего в свой закрытый мир не пускают.
Именно из-за этого двойного барьера — сложной радиосинхронизации AWDL и шифрованного обмена данными — AirDrop так долго оставался неприступной крепостью для Android.
Но в 2025 году стены этой крепости пали.
Европейский закон, который изменил всё
В ноябре 2025 года Google неожиданно объявила, что смартфоны Pixel 10 теперь поддерживают AirDrop. А в будущем, по словам компании, поддержка расширится на все устройства Android.
И самое главное — это произошло не потому, что Apple щедро выдала разрешение. У руководства компании вообще никто не спрашивал согласия.
Как же это произошло? Кто те смельчаки, которые взломали AirDrop? Возможно, вы представляете себе загадочных программистов в чёрных толстовках с капюшонами и масками анонимусов, бесконечно всматривающихся в миллионы строк кода? Нет.
Самую большую роль сыграли… чиновники. В белых рубашках и галстуках, попивающие кофе из кружек с логотипом Евросоюза. Они работают в огромном здании Еврокомиссии и пишут законы длиной в сотни страниц.
Один из таких законов — Digital Markets Act, сокращённо DMA. Документ, который уже заставил Apple установить USB-C в iPhone. Теперь очередь дошла до AirDrop.
Что такое Digital Markets Act
Если коротко, это постановление властей Евросоюза о том, что технологические гиганты должны использовать открытые технологии и делиться своими наработками с более мелкими игроками рынка. В противном случае — огромные штрафы.
В том числе DMA требует от Apple «эффективной интероперабельности». Что это значит?
Переводя с европейско-юридического языка на понятный, закон считает компанию из Купертино gatekeeper’ом — стражем ворот. Ворота в данном случае — это технология обмена файлами. И закон предписывает эти ворота приоткрыть, чтобы туда могли войти и другие игроки рынка.
Это и есть та самая интероперабельность. Или, говоря проще, доступность и совместимость.
Под давлением DMA Apple была вынуждена внедрить в AirDrop поддержку открытого протокола Wi-Fi Aware, а точнее — Neighbor Awareness Networking, сокращённо NAN.
Ирония судьбы: Apple сама участвовала в разработке этого стандарта в 2010-х годах.
Wi-Fi Aware: открытая альтернатива
Что такое NAN? Это открытый стандарт IEEE 802.11. Он позволяет устройствам общаться между собой в режиме одноранговой сети, то есть без подключения к интернету.
Принцип очень похож на AWDL. Устройства обмениваются между собой короткими сообщениями для обнаружения друг друга и устанавливают peer-to-peer соединение. Практически полный аналог закрытого протокола Apple.
Важно понимать, что Apple не убрала AWDL полностью — это сломало бы старые устройства и их взаимодействие внутри экосистемы. Вместо этого компания добавила NAN как параллельный путь: внутри экосистемы Apple всё работает на AWDL — быстро и синхронно, а для сторонних устройств — на открытом протоколе.
Начиная с iOS 26, все устройства Apple поддерживают Wi-Fi Aware. Это стало обязательным требованием Еврокомиссии. В марте 2025 года Европейская комиссия приняла две спецификации, детализирующие меры, которые Apple должна предпринять для обеспечения интероперабельности iOS с устройствами третьих сторон.
Тут-то и подсуетилась Google.
Как Google реализовала совместимость
У Google давно был свой аналог AirDrop — Quick Share. То же самое, только в экосистеме Android. Компания просто обновила его, чтобы он мог распознавать NAN-сигналы от iPhone.
Разумеется, не обошлось без реверс-инжиниринга. Ведь официально Apple не документировала формат своих сообщений. Но основа была открытой благодаря требованиям DMA.
В итоге Pixel 10 получил всё необходимое из коробки. А значит, может без проблем подключаться к AirDrop.
Важно понимать: Google не взламывала AWDL. Зачем, если NAN открыт? Они просто заговорили на языке, который Apple была вынуждена сделать доступным.
В ноябре 2025 года Google опубликовала подробное объяснение безопасности этого решения. Компания провела внутренние тесты, обзоры приватности и тесты на проникновение, а также привлекла независимую компанию NetSPI для оценки безопасности. По результатам проверки система оказалась безопасной и «заметно надёжнее» других отраслевых реализаций.
Google не первые
Интересно, что Google не первые, кто захотел подключиться к AirDrop. Ещё в 2019 году инженеры из немецкой лаборатории SEEMOO Lab представили OpenDrop — полностью открытую реализацию протокола Apple, написанную на Python. Это проект, полученный путём обратного инжиниринга закрытого стека AWDL.
OpenDrop умеет сканировать iPhone и Mac по Bluetooth LE, устанавливать peer-to-peer Wi-Fi канал и передавать файлы с тем же end-to-end шифрованием, что и оригинал. По сути, это первый и до сих пор рабочий «AirDrop для всех», который можно запустить на обычном ноутбуке с Linux и отправить фотографию прямо на iPhone.
Однако это решение не для массового пользователя, скорее для энтузиастов и исследователей. А вот то, что показала Google — это уже совсем другой уровень. Всё работает так же просто, как на iPhone: файлы передаются нажатием одной кнопки.
Как это работает на практике
По состоянию на январь 2026 года функция работает только на линейке смартфонов Pixel 10. И не совсем из коробки, и не так бесшовно, как между устройствами Apple.
Во-первых, на Pixel нужно установить обновление Quick Share Extension из Play Store. Затем включить все необходимые разрешения.
На устройствах Apple ничего устанавливать не нужно, но есть нюанс. AirDrop на iPhone по умолчанию настроен на режим «Только контакты», поэтому Pixel не сможет обнаружить устройство. Чтобы поделиться файлами, в настройках нужно выбрать видимость «Для всех на 10 минут». Тогда iPhone объявит о себе открыто, и Pixel его увидит.
Ещё одна особенность — речь идёт только об iOS и iPadOS. Передать файл с Android на Mac также можно, но на Mac нужно установить настройку AirDrop «Для всех», которая остаётся активной, пока её не выключат вручную.
Скорость передачи
А как насчёт скорости? AWDL — это выделенный скоростной туннель. Сможет ли открытая реализация тягаться с ним?
Удивительно, но да. Тесты показывают, что скорость передачи сопоставима с оригинальным AirDrop. Фотография размером десять-пятьдесят мегабайт передаётся за две-пять секунд. Видео объёмом один гигабайт — за десять-двадцать секунд.
Да, речь идёт об идеальных условиях. В реальности будет чуть медленнее. Но всё же вполне достойно.
Проблема с Wi-Fi
Однако не обошлось без проблем. В конце ноября 2025 года пользователи Pixel 10 начали массово жаловаться на серьёзную ошибку: обновление Quick Share Extension (версия 1.0.815689706) вызывает сбой Wi-Fi подключения.
Как только пользователи открывают меню Quick Share для отправки файла, Wi-Fi немедленно отключается. Сеть исчезает из списка доступных, и подключиться заново можно только после закрытия меню. У некоторых пользователей проблема проявляется именно в момент подготовки файлов к отправке. Другие сообщают, что их телефон вообще отказывается использовать Wi-Fi для передачи файлов на компьютер, переключаясь на мучительно медленный Bluetooth.
Пользователи попытались сообщить о проблеме через официальные каналы Google, но столкнулись с абсурдной ситуацией. Когда кто-то подал заявку в баг-трекер Google Issue Tracker, её закрыли с рекомендацией обратиться на форум поддержки. На форуме же пользователей отправили обратно в баг-трекер. Эта путаница напомнила многим предыдущие проблемы Google с обработкой багов, например, с проблемой заикания телефото-камеры на Pixel.
На момент публикации единственное временное решение — удалить обновление Quick Share Extension. Но при этом теряется возможность обмениваться файлами с устройствами Apple.
Проблема связана с тем, как Quick Share использует комбинацию Bluetooth для обнаружения и Wi-Fi Direct для высокоскоростной локальной передачи. При открытии интерфейса обмена может происходить временный разрыв клиентского соединения, если параллельная работа реализована некорректно. Подобные проблемы с одновременной работой Wi-Fi Direct возникали и в предыдущих версиях Android и обычно устранялись обновлениями Play Services или прошивки.
По данным на январь 2026 года, Google ещё не выпустила официальное исправление этой проблемы.
Надежда на Qualcomm
Хотя у Google возникли технические сложности, есть надежда на более широкое распространение функции.
В декабре 2025 года компания Qualcomm анонсировала, что поддержка AirDrop появится на устройствах с процессорами Snapdragon «в ближайшем будущем». Это означает, что функция станет доступна на большей части устройств Android, так как именно чипы Qualcomm используются в большинстве Android-смартфонов.
Правда, Qualcomm не уточнила, какие именно процессоры Snapdragon получат поддержку — будет ли это прерогативой флагманских чипов вроде Snapdragon 8 Elite или функция дойдёт до среднего и бюджетного сегмента. Также неизвестно, насколько далеко в прошлое распространится эта поддержка для уже выпущенных устройств.
Более того, в начале января 2026 года в сборках Android Canary были обнаружены системные файлы, указывающие на то, что Google готовит расширение поддержки AirDrop на серию Pixel 9. Правда, функция пока не активирована, и неясно, получат ли её более старые модели, такие как Pixel 8.
Что дальше?
Что делать Apple? Срочно латать дыры и закрывать лазейку? Теоретически, компания могла бы попытаться это сделать. Но какой ценой?
Волшебный ключ от AirDrop уже не отобрать без шума и скандала. Скорее всего, Apple постарается превратить ситуацию в преимущество для связей с общественностью, заявив, что всегда стремилась улучшить опыт пользователей разных платформ.
Когда существуют технологические барьеры, которые мешают пользователям, всегда найдутся те, кто их сломает или обойдёт. И не важно, кто это будет — чиновники, регуляторы или талантливые инженеры конкурентов.
По большому счёту, почему производитель должен указывать пользователям, кому они могут отправить видео из отпуска, а кому нет? С этой точки зрения то, что AirDrop стал доступным для Android — хотя и не без технических проблем — это безусловно хорошая новость. Это начало конца одной из самых бессмысленных «экосистемных войн» последних лет.
Что будет в будущем? AirPlay на всех устройствах? Хотелось бы, но пока что верится с трудом. Однако опыт с AirDrop показывает, что правильное сочетание регуляторного давления и технической изобретательности способно разрушить даже самые закрытые стены.
Европейская комиссия продолжает оказывать давление на Apple в рамках DMA. В декабре 2025 года Apple даже опубликовала заявление с критикой закона, утверждая, что он создаёт риски для безопасности и приватности пользователей, задерживает выход новых функций в Европе и несправедлив, так как применяется только к Apple, хотя Samsung является лидером рынка смартфонов в Европе.
Тем не менее в декабре того же года в iOS 26.3 Apple добавила новые функции интероперабельности для устройств третьих сторон в Евросоюзе, включая быстрое сопряжение устройств по аналогии с AirPods и улучшенные уведомления для сторонних умных часов. Это прямой результат требований DMA.
Таким образом, история с AirDrop на Android — это не просто техническое достижение. Это пример того, как законодательное регулирование может изменить расстановку сил в технологической индустрии, заставив даже самые закрытые экосистемы открыться миру.
Квантовый прорыв Google
Квантовый чип Willow от Google выполнил алгоритм в 13 000 раз быстрее суперкомпьютеров. Исследование в Nature и применение в химии.
Квантовый 105-кубитный чип Willow от Google продемонстрировал первое в истории квантовое преимущество. Алгоритм Quantum Echoes (OTOC — out-of-time-order correlator) выполнился в 13 000 раз быстрее, чем на самых мощных классических суперкомпьютерах. Главное достижение: результат можно воспроизвести и независимо проверить.
Ключевой прорыв чипа — преодоление порога квантовой коррекции ошибок, о котором говорили ещё с 1995 года. Чем больше кубитов добавляется, тем меньше становится уровень ошибок — экспоненциально снижается при масштабировании. При тестировании решёток 3×3, 5×5 и 7×7 кубитов, уровень ошибок каждый раз сокращался вдвое. Это доказывает, что можно построить масштабируемый квантовый компьютер.
В доказательство концепции Google применила Quantum Echoes как «молекулярную линейку» для изучения двух молекул (15 и 28 атомов). Результаты совпали с традиционной ядерной магнитно-резонансной спектроскопией (ЯМР), но раскрыли дополнительную информацию, недоступную классическим методам. Технология может революционизировать разработку лекарств и материалов, помогая определять структуру молекул с беспрецедентной точностью.
Чип показал рекордную точность: 99.97% для одно-кубитных операций, 99.88% для двух-кубитных и 99.5% для считывания — всё за наносекунды. За проект выполнено триллион измерений — значительная часть всех измерений, когда-либо проведённых на всех квантовых компьютерах вместе взятых.
Впрочем, эксперты призывают к осторожности: до коммерческих применений ещё далеко. Для решения реальных задач потребуется увеличить количество кубитов в десятки тысяч раз, достигнув уровня ошибок 10⁻⁶. Тем не менее акции Alphabet выросли на 2% после анонса, добавив около $35 млрд к капитализации.