Apple в очередной раз объявила, что выпустила самый мощный чип за всю свою историю. Казалось бы, обычное дело — подобные заявления компания делает при каждом крупном анонсе. Но в этот раз ситуация оказалась куда интереснее, чем обычно: Купертино представила не один, а сразу два чипа, построенных на принципиально разных инженерных философиях. Получилось настоящее противостояние двух подходов к тому, что вообще значит «мощный процессор» в 2026 году.
С одной стороны — M6, первый чип Apple, изготовленный по двухнанометровому технологическому процессу: энергоэффективный, компактный, спроектированный с оглядкой на будущее. С другой — M5 Ultra: огромный, дорогой, прожорливый и невероятно производительный конструктор из нескольких кристаллов, склеенных в единую систему. Вопрос, который напрашивается сам собой: какой из этих чипов на самом деле важнее для Apple и какой подход в итоге победит — расчётливая инженерная элегантность или откровенная вычислительная масса?
Чтобы ответить на него, стоит разобраться, что именно изменилось внутри транзистора, почему цифра «2 нанометра» давно перестала быть буквальной, и почему более старый по техпроцессу M5 Ultra всё равно способен обойти M6 в по-настоящему тяжёлых задачах.
Что на самом деле означает «техпроцесс 2 нм»
Начать стоит с главного заявления: Apple громко говорит о переходе на 2-нанометровый техпроцесс. Но здесь важно понимать один нюанс — сама компания чипы не производит. Apple проектирует архитектуру: центральный процессор, графическое ядро, нейродвижок, контроллеры памяти, медиаблоки. А физическое производство кристаллов берёт на себя тайваньская TSMC. Поэтому правильнее говорить не «Apple перешла на 2 нм», а «Apple перенесла свой дизайн на новый техпроцесс TSMC N2». Это менее эффектная формулировка, зато куда более точная.
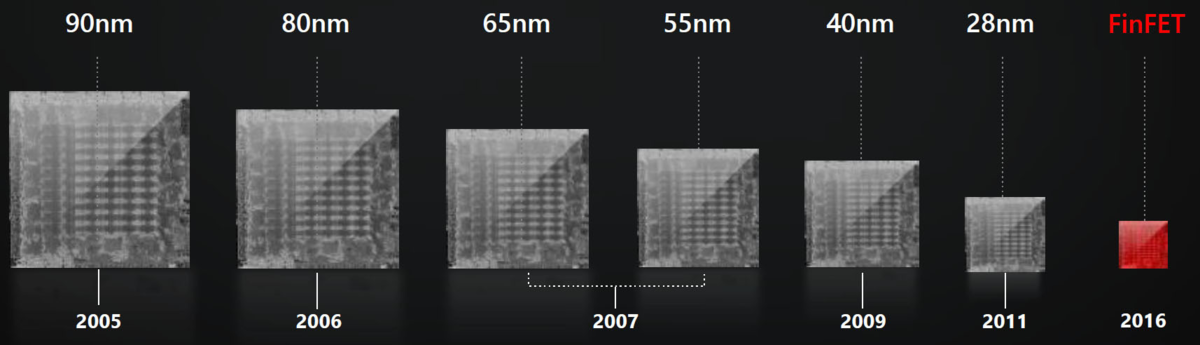
Что тогда означает сама цифра «2 нанометра»? Сегодня — практически ничего в буквальном смысле. Современные обозначения техпроцессов давно перестали быть линейкой, по которой можно измерить реальный размер транзистора. Название техпроцесса превратилось в маркетинговое обозначение целого поколения технологии, примерно как номер модели iPhone.
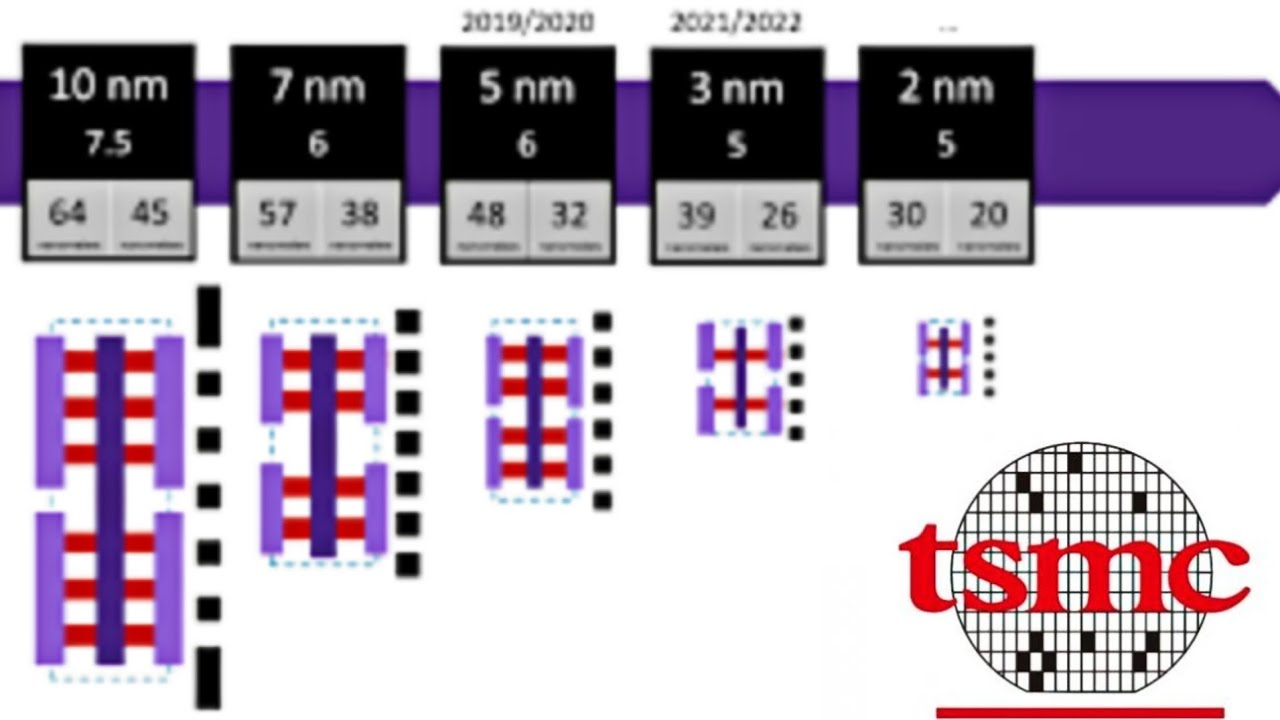
Значит ли это, что никакого реального прогресса нет и «2 нм» — просто красивая цифра? Нет. В случае с M6 и лежащим в его основе техпроцессом TSMC N2 изменения оказались весьма значительными. Причём главное здесь не в том, что транзистор стал ровно два нанометра в поперечнике, а в том, что изменилась сама конструкция транзистора.
От плавника к стопке нанолистов: как работает новый транзистор
Чтобы понять суть изменений, стоит вспомнить, что такое транзистор в принципе. По сути, это микроскопический переключатель: он либо пропускает ток, либо нет — ноль или единица, закрыто или открыто. Миллиарды таких переключателей и создают всю вычислительную работу современного чипа.
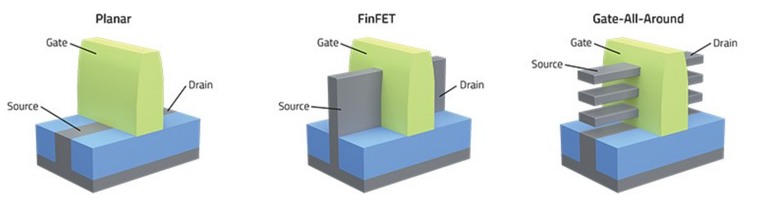
Долгое время в чипах использовалась архитектура FinFET — название происходит от английского fin, «плавник», потому что канал транзистора визуально напоминал тонкую вертикальную кремниевую стенку. Вокруг этой стенки располагался затвор, управляющий прохождением тока. FinFET стал важным шагом вперёд, потому что затвор охватывал канал не с одной стороны, как в ещё более старых плоских транзисторах, а сразу с трёх. Контроль над током улучшился, утечки снизились, чипы стали быстрее и экономичнее.
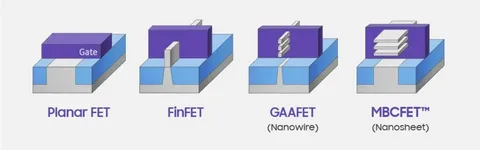
Но когда транзисторы становятся совсем маленькими, у FinFET начинают проявляться проблемы: даже в выключенном состоянии транзистор продолжает немного пропускать ток. Именно для решения этой проблемы была разработана новая архитектура — нанолистовые транзисторы, также известные как gate-all-around, то есть «затвор со всех сторон».
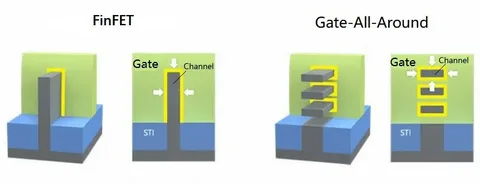
Переход TSMC на техпроцесс N2 означает смену архитектуры транзисторов с FinFET на Gate-All-Around, где тонкие горизонтальные каналы уложены слоями, а затвор соприкасается с каналом сразу с четырёх сторон. Проще говоря, вместо одной вертикальной кремниевой стенки внутри транзистора теперь находится несколько тонких горизонтальных слоёв — что-то вроде стопки крошечных кремниевых «блинчиков», которые затвор окружает полностью, а не частично.
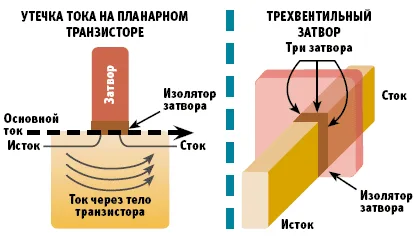
Из этого вытекают три практических следствия. Во-первых, лучший контроль над током: если затвор окружает канал со всех сторон, он точнее включает и выключает транзистор. Во-вторых, меньше утечек тока — а значит, меньше лишнего нагрева и выше энергоэффективность. И, в-третьих, появляется пространство для дальнейшего уменьшения транзисторов без превращения чипа в источник избыточного тепла.
Официальные цифры TSMC подтверждают серьёзность изменений: по опубликованным данным TSMC, техпроцесс N2 обеспечивает до 15% прироста производительности при равном энергопотреблении, либо снижение энергопотребления на 25–30% при равной производительности по сравнению с предыдущим трёхнанометровым поколением. Рост плотности упаковки транзисторов при этом не столь драматичен, сколько может показаться из громких заголовков, — речь идёт не о кратном увеличении, а о заметном, но умеренном шаге вперёд. Тем не менее это серьёзный технологический задел на будущее.
Почему именно эта технология так важна для Apple? Потому что философия Apple Silicon с самого начала строилась вокруг показателя производительности на ватт — цели сделать компьютер мощнее, не превращая его в устройство, которое требует принудительного охлаждения. Архитектура gate-all-around идеально ложится в эту стратегию: лучший контроль транзистора означает меньше утечек и более высокую энергоэффективность.
Путь Apple Silicon: от побега с Intel до второго поколения нейроускорителей
Чтобы оценить масштаб перехода на M6, полезно вспомнить, как Apple шла к этому моменту.
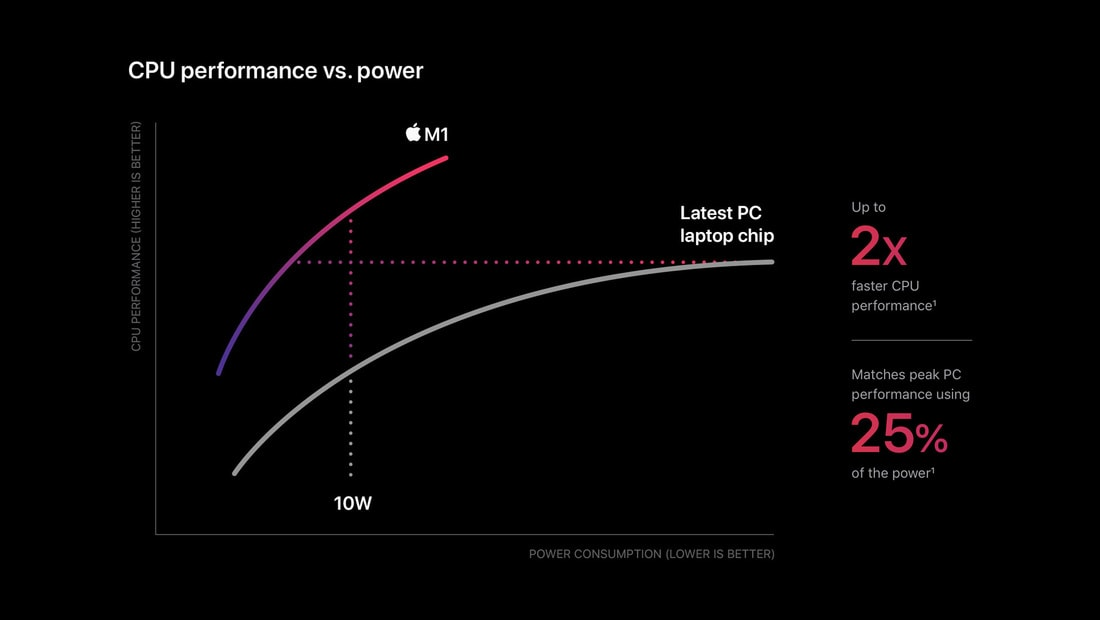
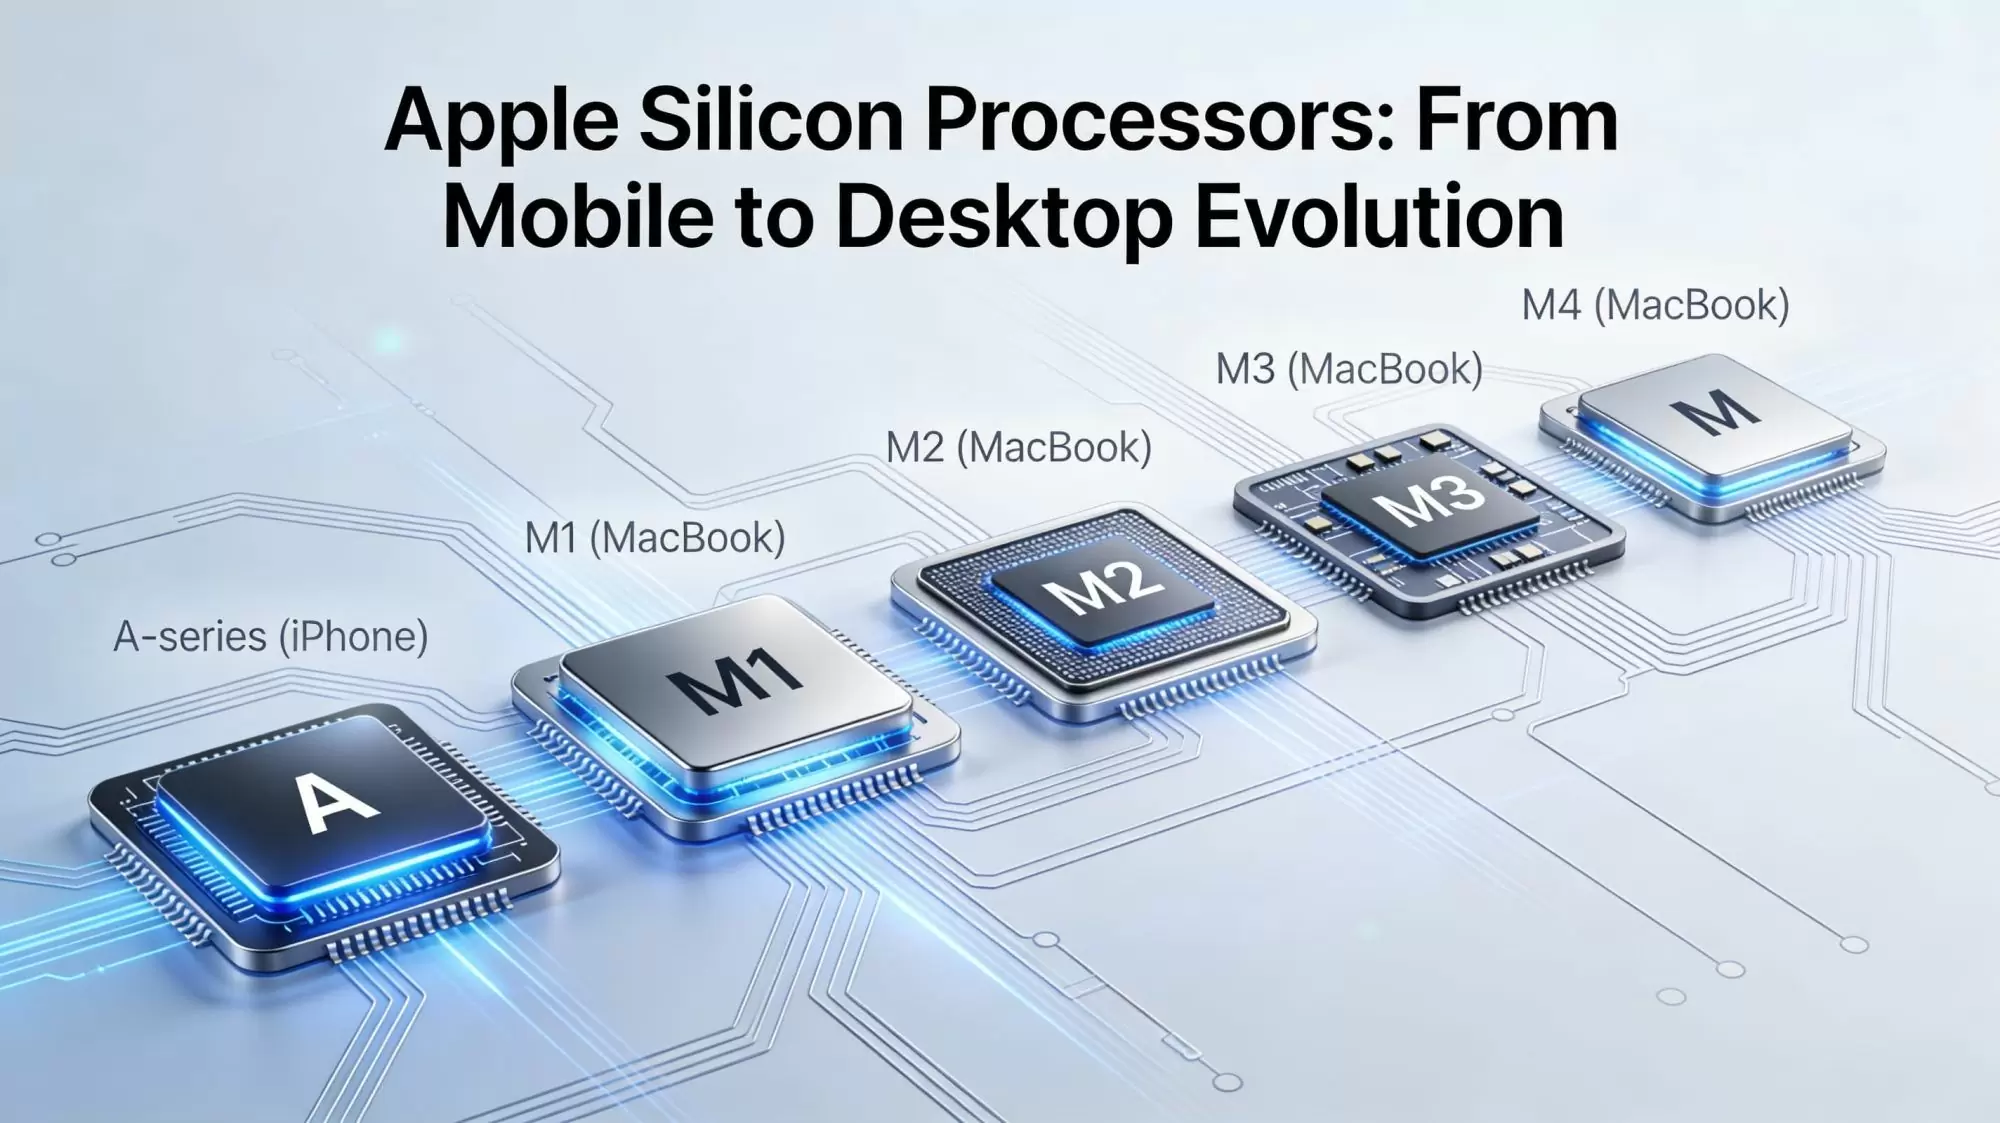
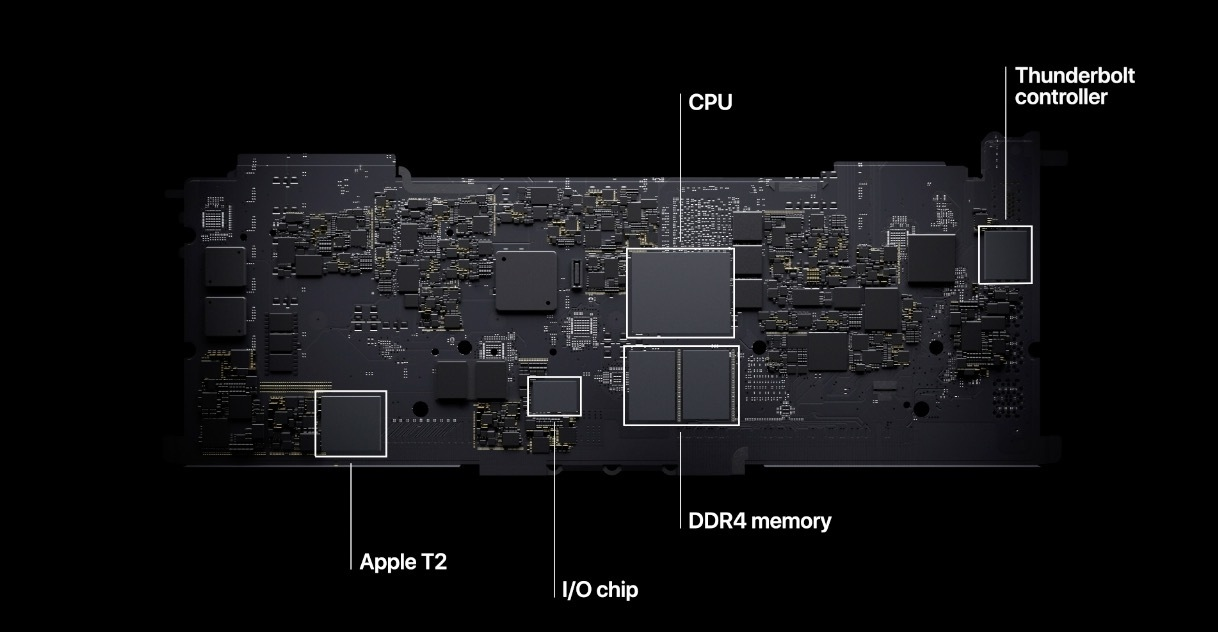
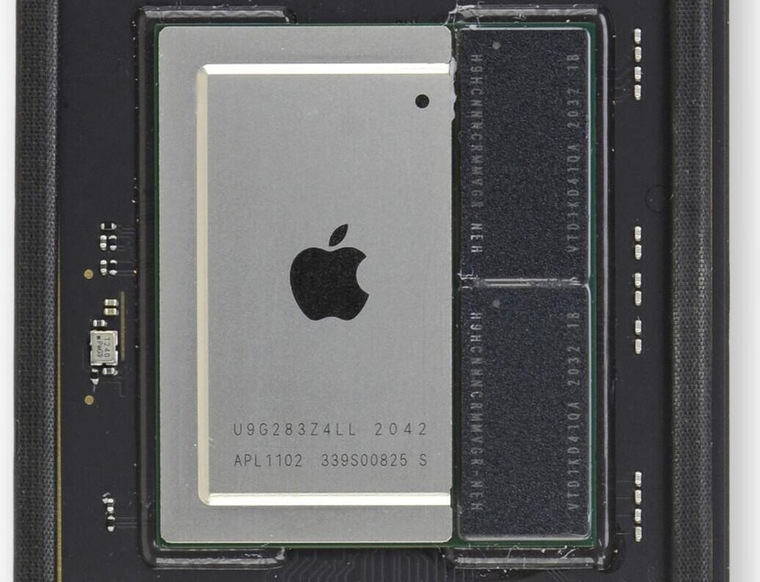
В 2020 году компания совершила решительный «побег» с процессоров Intel, представив первый Apple Silicon для Mac — M1. Это был пятинанометровый чип с 16 миллиардами транзисторов, и именно тогда MacBook Air без вентилятора неожиданно стал мощнее значительной части рынка персональных компьютеров.
M2 стал улучшенной версией той же пятинанометровой технологии: больше транзисторов, выше производительность, лучшая графика, возросшая пропускная способность памяти. M3 ознаменовал переход на трёхнанометровый техпроцесс — это был первый по-настоящему серьёзный архитектурный скачок с новым графическим процессором, технологией динамического кеширования и аппаратной трассировкой лучей. M4 стал вторым поколением на трёх нанометрах, с акцентом на дальнейшее повышение энергоэффективности.
Наконец, M5 представлял собой третье поколение трёхнанометровой архитектуры, и его главная особенность заключалась в том, что графический процессор научился эффективнее справляться с нейросетевыми нагрузками. Графика и раньше умела считать нейросети, но именно в M5 внутри GPU-ядер появились отдельные нейронные ускорители — специализированные блоки, позволяющие обрабатывать ИИ-нагрузки прямо внутри графического блока, а не только через отдельный нейропроцессор.
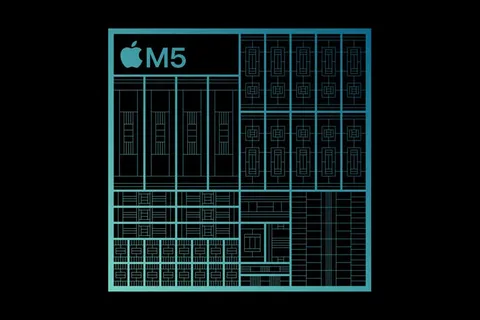
И вот теперь настал черёд M6 — первого двухнанометрового чипа Apple Silicon: новый техпроцесс, новая транзисторная архитектура, ещё больший упор на энергоэффективность, графику и локальный искусственный интеллект.
M6 изнутри: инженерный конструктор нового поколения
Центральный процессор. M6 — это SoC с 12-ядерным процессором, интегрирующим 12 ядер, распределённых по трём кластерам, а именно два сверхбыстрых Super-ядра, четыре производительных Performance-ядра и шесть энергоэффективных Efficiency-ядер. Предварительные данные указывают на тактовую частоту до 4,8 ГГц для двух высокопроизводительных Super-ядер.
Такая конфигурация — не просто добавление ещё пары ядер к прежней схеме, а более ступенчатая лестница производительности. Super-ядра предназначены для задач, где важна максимальная однопоточная скорость; Performance-ядра — для многопоточной работы; Efficiency-ядра — для фоновых процессов. Логика такого деления проста: иногда компьютеру нужно резко выдать максимум мощности — открыть тяжёлый проект, собрать код, обработать фотографию, — а иногда требуется лишь незаметно синхронизировать файлы, поддерживать работу мессенджеров или проигрывать музыку. Гонять для этого самые мощные ядра — всё равно что запускать суперкомпьютер ради открытия калькулятора. Поэтому у Apple есть быстрые ядра для тяжёлых задач и энергоэффективные — для всего остального, а распределяет нагрузку между ними сам чип. Это продлевает автономность ноутбуков и позволяет делать компактные, малошумные устройства вроде Mac mini.
Графический процессор. Новый Mac mini с чипом M6 получил 12-ядерный процессор, 12-ядерный графический процессор с нейронными ускорителями и до 32 ГБ объединённой памяти с пропускной способностью до 170 ГБ/с. Обычный GPU хорошо справляется с параллельным выполнением множества похожих операций — обработкой пикселей, вершин и подобных задач. Нейросеть же по своей сути — это, во многом, огромные матричные вычисления, поэтому Apple всё активнее переносит подобные вычисления не только в отдельный Neural Engine, но и непосредственно в графический процессор. Neural Engine эффективен для оптимизированных моделей, GPU — более гибок, а центральный процессор берёт на себя общую логику.
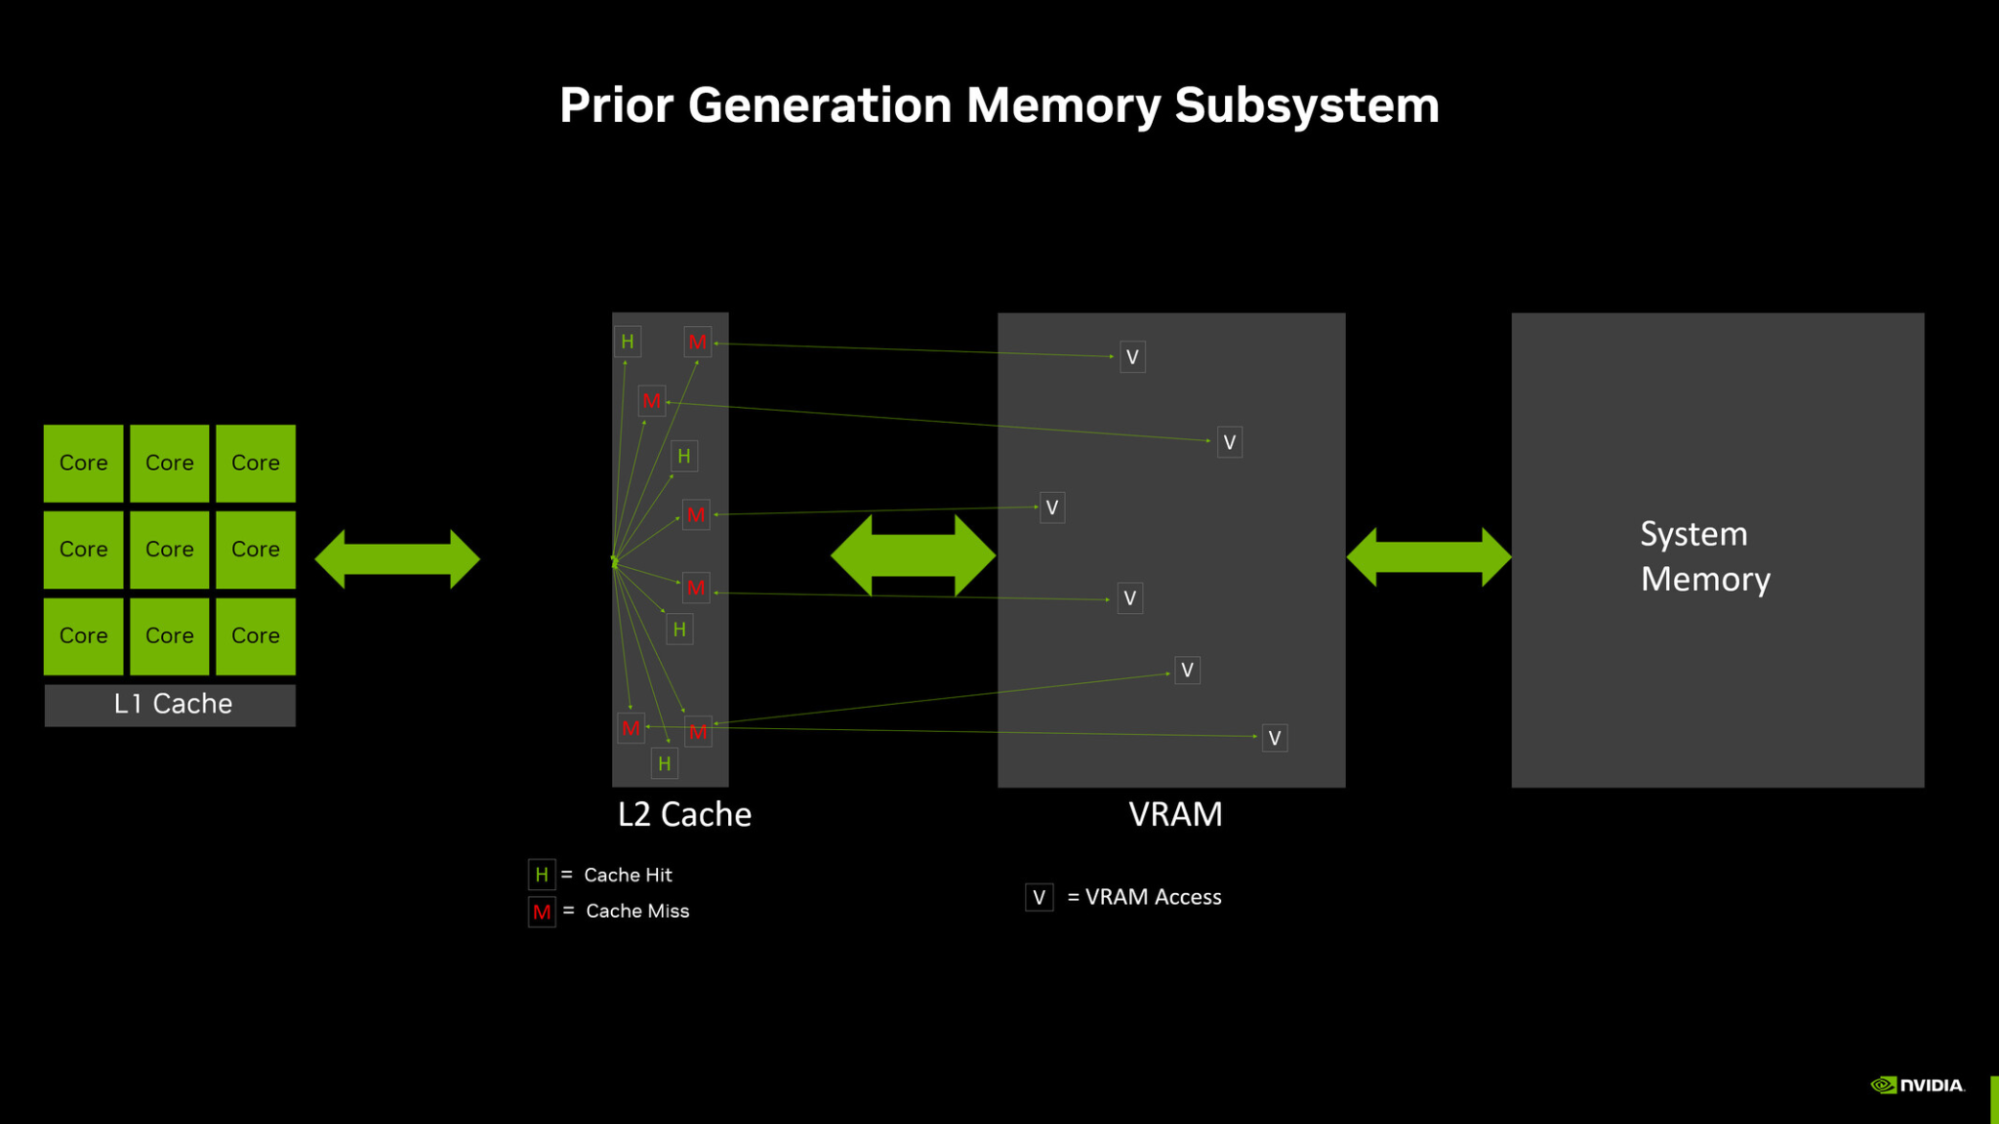
Ключевое нововведение в графической архитектуре M6 — технология динамического кеширования памяти. Обычно, когда GPU выполняет шейдеры, ему нужно заранее выделить ресурсы: регистры, локальную память, кеш. Проблема в том, что разным шейдерам требуется разное количество памяти, и в классическом подходе GPU часто вынужден резервировать её с запасом — даже если реально использует не весь выделенный объём. В результате часть графического процессора простаивает не потому, что ей нечего делать, а потому, что ресурсы распределены не идеально. Динамическое кеширование решает эту проблему, выделяя память гибко, по фактической потребности задач в реальном времени: где нужно больше — туда отдаётся больше, где нужно меньше — лишнее не резервируется. В итоге ядра загружаются плотнее, больше потоков выполняется одновременно, меньше простоев и выше общая эффективность. Возможно, на презентации это звучит не так эффектно, как заявление о «плюс миллион ядер», но именно такие тонкие оптимизации нередко решают исход дела в реальных задачах.
Нейропроцессор. По сравнению с предыдущим поколением M6 получил сдвоенный 16-ядерный нейронный движок для значительно улучшенной производительности искусственного интеллекта на устройстве. Если раньше у чипов Apple был один такой блок, то теперь их два. Задача нейропроцессора — выполнять локальные ИИ-задачи прямо на устройстве, не отправляя их в облако: распознавание речи, обработку изображений, генерацию текста, работу интеллектуальных помощников.
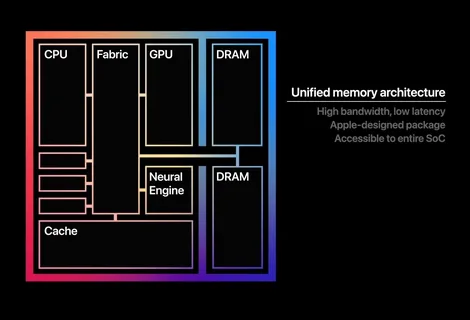
Объединённая память. Это одна из фирменных особенностей архитектуры Apple Silicon. В классическом компьютере центральный процессор, видеокарта и специализированные ускорители нередко работают с отдельными областями памяти, и данные приходится постоянно копировать между этими областями, теряя время и энергию. У Apple схема иная: центральный процессор, графический блок и нейропроцессор используют общий пул памяти. Для задач, связанных с графикой, видео и искусственным интеллектом, это особенно важно, поскольку там постоянно обрабатываются большие объёмы данных, а чем меньше происходит лишнего копирования, тем быстрее и эффективнее работает вся система.
У M6 объединённая память ограничена 32 ГБ. Для базового Mac mini это вполне достаточный объём — браузер, программирование, фотография, монтаж, музыка, офисные задачи и даже часть локальных ИИ-сценариев чип потянет без проблем. Но для больших языковых моделей возможны сложности: модель должна целиком поместиться в память, а на 32 гигабайтах особого простора нет. Здесь стоит понимать: M6 не предназначен для локального запуска флагманских моделей искусственного интеллекта. Это массовый, быстрый и холодный чип, рассчитанный на большинство обычных пользователей.
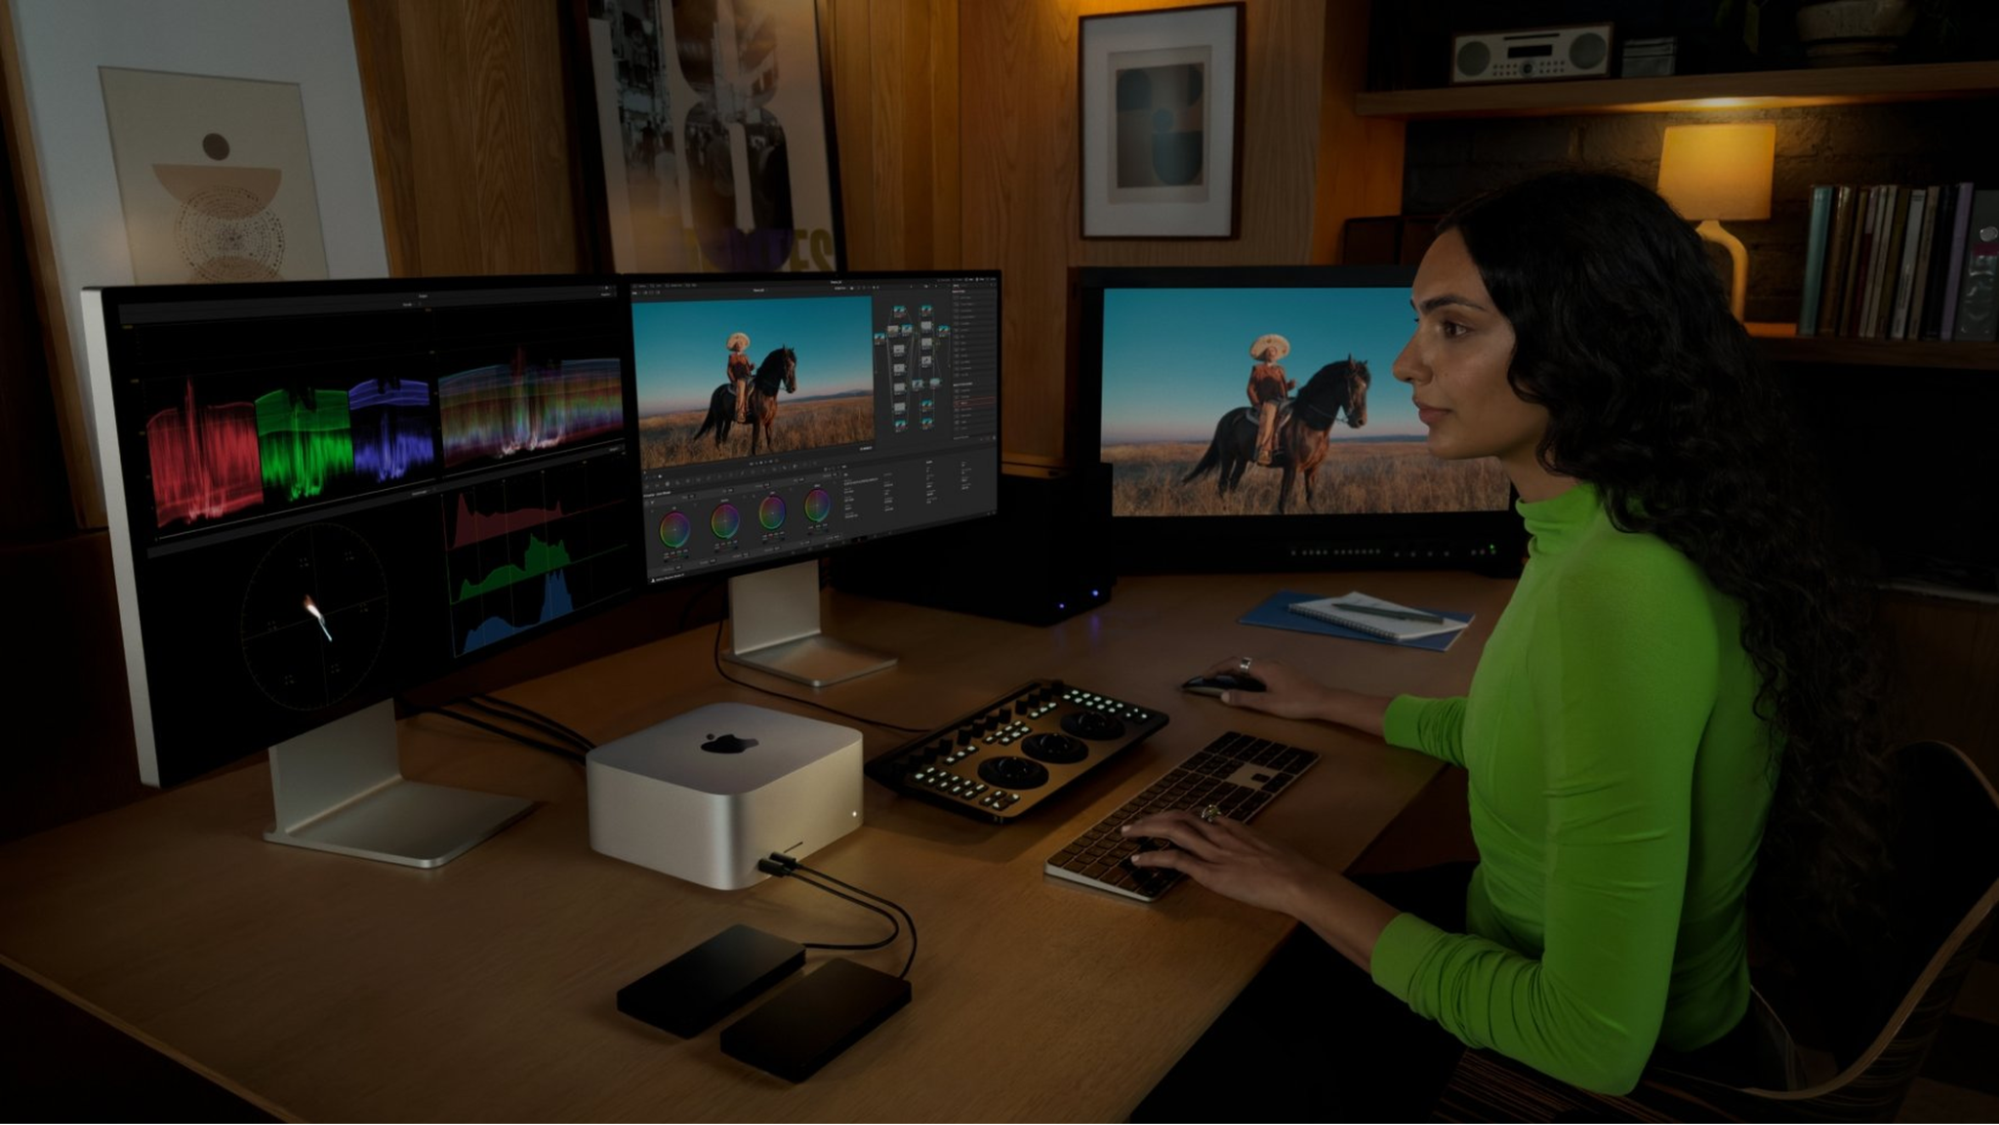
Впрочем, энтузиасты и раньше объединяли несколько Mac mini в небольшие вычислительные кластеры, распределяя нагрузку модели между несколькими машинами. И судя по всему, Apple фактически признала легитимность подобного использования: Thunderbolt 5 с поддержкой Remote Direct Memory Access (RDMA) позволяет объединять в кластер несколько систем Mac Studio, обеспечивая до 3 раз более высокую производительность распределённого ИИ-вывода по сравнению с одной системой. Технология RDMA позволяет напрямую передавать данные из памяти одного компьютера в память другого в обход центрального процессора, что критично для распределённых нейросетевых вычислений — меньше задержек, меньше лишней работы при обмене данными.
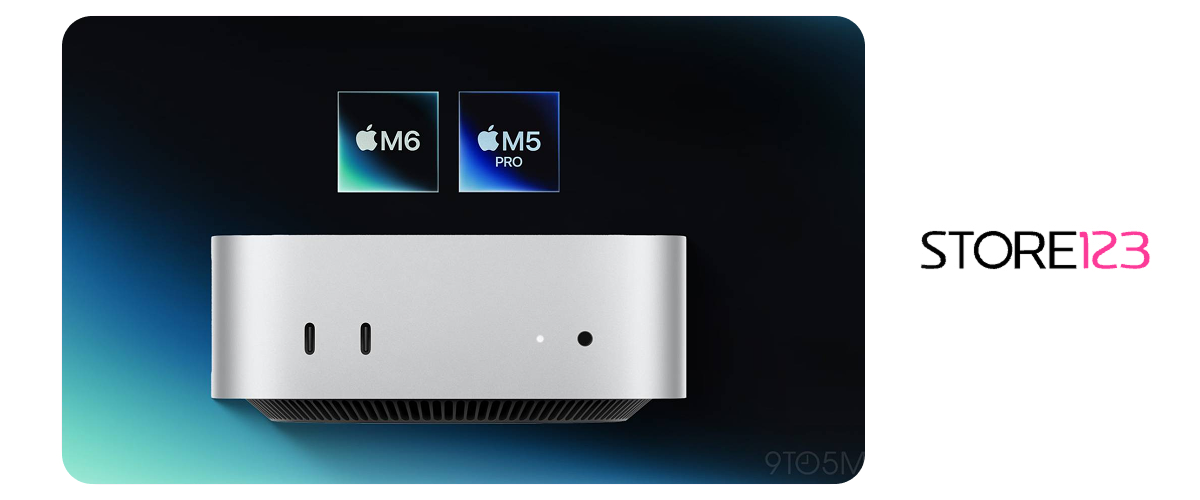
Однако именно здесь базовый M6 остаётся за бортом этого сценария. M6 Mac mini оснащён портами Thunderbolt 4 со скоростью передачи данных до 40 Гбит/с, тогда как Mac mini с M5 Pro получил три порта Thunderbolt 5 со скоростью до 120 Гбит/с, а именно Thunderbolt 5 необходим для кластеризации и работы RDMA. Mac mini с M6 поставляется с портами Thunderbolt 4, поэтому не может использовать функцию кластеризации Apple через Thunderbolt 5 — впрочем, устройство всё равно способно участвовать в обычных распределённых вычислениях через Ethernet, так что это скорее отсутствие удобного short-cut, чем непреодолимая стена. Таким образом, если есть план собрать домашний кластер из Mac mini для запуска крупной модели, стоит иметь в виду: самые доступные версии этого чипа для такого сценария не подойдут — нужен вариант с чипом M5 Pro.
M5 Ultra: ставка на масштаб
Если M6 — история про инженерную аккуратность, то M5 Ultra — история про масштаб в чистом виде. Идея проста и одновременно радикальна: что если взять несколько крупных кристаллов и заставить их работать как единое целое?
Причина такого подхода вполне прагматична. Изготовление одного гигантского монолитного кристалла сложнее и дороже, а вероятность производственного дефекта возрастает — и если брак попадает в важную часть кристалла, отправить в утиль приходится весь чип целиком. Поэтому инженеры пошли другим путём: вместо одного огромного куска кремния собирается система из нескольких кристаллов, будто конструктор.
M5 Ultra использует четырёхкристальную архитектуру, объединённую фирменной технологией UltraFusion, с пропускной способностью межкристального соединения 4,4 ТБ/с и до 1,2 ТБ/с пропускной способности объединённой памяти. По сути, Apple берёт два чипа M5 Max, соединяет их сверхбыстрой шиной — и система воспринимает эту связку как единый процессор: общий центральный процессор, общая графика, общая память, единый нейропроцессор. Задача технологии UltraFusion — обеспечить связь между кристаллами с минимальными задержками, чтобы разные части чипа вели себя как один цельный организм.
Центральный процессор. M5 Ultra масштабируется до 36-ядерного процессора и до 80-ядерного графического процессора, при этом конфигурация ядер здесь принципиально иная, чем в M6: старший чип M5 Ultra оснащён процессором с 12 сверхбыстрыми Super-ядрами и 24 производительными Performance-ядрами — и, что показательно, в этой конфигурации полностью отсутствуют энергоэффективные Efficiency-ядра. Причина логична: Mac Studio на M5 Ultra не пытается быть энергоэффективным ноутбуком. Это стационарная рабочая станция, постоянно подключённая к розетке, задача которой — максимально быстро считать тяжёлые задачи. Поэтому Apple делает ставку исключительно на крупные ядра: Super-ядра — для максимальной однопоточной скорости, Performance-ядра — для задач, которые хорошо распараллеливаются. Смысл такой конфигурации не в том, чтобы мгновенно открыть браузер (с этим прекрасно справляются и куда более скромные чипы), а в том, сколько тяжёлой вычислительной работы система способна переварить одновременно.
Графический процессор. Масштаб здесь ещё нагляднее: если у M6 всего 12 графических ядер, то у M5 Ultra их может быть до 80. И здесь также применяется технология нейронных ускорителей внутри GPU-ядер — Apple продолжает встраивать нейросетевые вычисления прямо в графический блок. Для чипа с 80 ядрами GPU, каждое из которых умеет эффективнее работать с ИИ-операциями, это означает получение весьма мощного локального ускорителя искусственного интеллекта.
Нейропроцессор. M5 Ultra получил 32-ядерный Neural Engine — вдвое больше, чем в базовом M5. Рассказывая о новом чипе, Apple делает особый акцент именно на возможностях искусственного интеллекта: нейродвижок отвечает за специализированные задачи машинного обучения, работу Core ML, Apple Intelligence и всего программного стека, который компания может оптимизировать под собственную архитектуру.
Объединённая память — главный козырь. Но настоящая сенсация M5 Ultra заключается даже не в количестве ядер, а в объёме памяти. Mac Studio с чипом M5 Ultra масштабируется до 36-ядерного процессора, до 80-ядерного графического процессора и до колоссальных 512 ГБ объединённой памяти, что позволяет пользователям запускать огромные языковые модели полностью на устройстве. Ещё десять–пятнадцать лет назад цифра в полтерабайта оперативной памяти прозвучала бы абсурдно. Но для задач искусственного интеллекта это принципиально важный показатель.
Дело в том, что главная проблема больших языковых моделей — их попросту нужно куда-то поместить целиком. Если модель крупная, ей может не хватить и 64, и даже 128 гигабайт памяти. Чем больше доступной памяти, тем более крупную и сложную модель можно запустить без постоянного обмена данными между накопителем и оперативной памятью — а именно такой обмен и создаёт задержки, съедающие скорость работы.
Стоит отметить важный нюанс актуальности: максимальная конфигурация памяти доступна не сразу. Apple подтвердила, что модели Mac Studio с 512 ГБ объединённой памяти начнут поставляться «в конце октября» 2026 года, тогда как остальные конфигурации уже доступны с 22 сентября — то есть на момент выхода этой статьи пользователям, желающим получить топовую версию памяти, придётся ещё немного подождать.
Да, всё это не делает M5 Ultra автоматически быстрее топовых видеокарт NVIDIA во всех задачах искусственного интеллекта — там действует другая экосистема, со своими сильными сторонами и специализированными серверными ускорителями. Но если раньше Mac Studio воспринимался в первую очередь как машина для видеомонтажа, трёхмерной графики, программирования и других тяжёлых профессиональных задач, то теперь Apple явно позиционирует его ещё и как компактную локальную ИИ-станцию — не серверную стойку с ускорителями, а аккуратную, тихую коробку на рабочем столе.
Так кто же сильнее — M6 или M5 Ultra
Здесь мы подходим к главному вопросу: если M6 такой новый, энергоэффективный и построен на передовом двухнанометровом техпроцессе, почему M5 Ultra всё равно может оказаться быстрее в тяжёлых задачах?
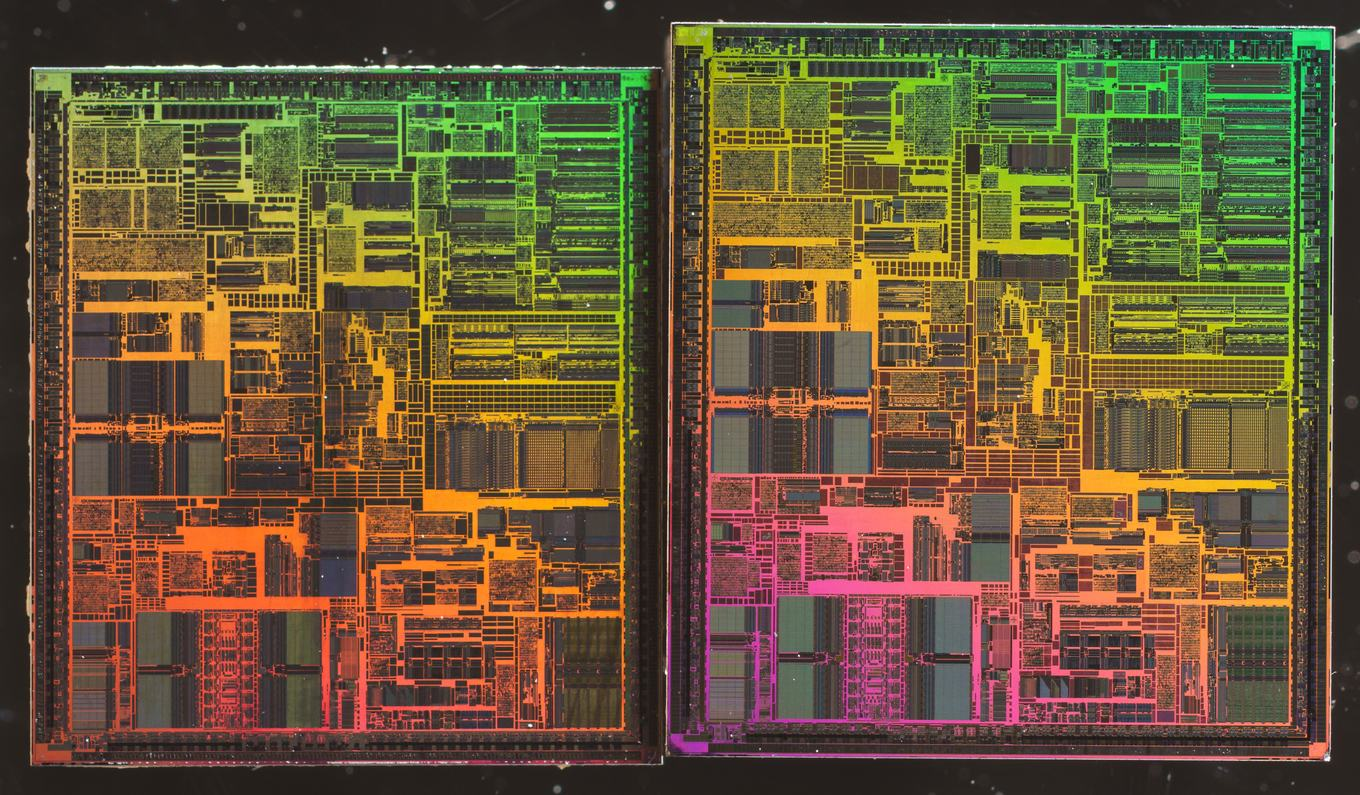
Ответ прост: техпроцесс — далеко не всё. Более совершенный транзистор делает эффективнее каждый отдельный вычислительный блок, но если у конкурирующего чипа этих блоков попросту намного больше, а лимиты по энергопотреблению значительно выше, он способен взять свою мощь массой. Это похоже на сравнение экономичного электромобиля с тяжёлым грузовиком: мотор электромобиля может быть технологичнее и эффективнее, но если необходимо перевезти десять тонн груза, полезнее окажется именно грузовик.
M6 — это быстрый, умный и энергоэффективный чип для массовых компьютеров. M5 Ultra — это настоящая вычислительная громадина. Если вопрос звучит «какой чип мощнее» — ответ очевиден: M5 Ultra. Но если спросить, какой из двух анонсов важнее для будущего направления развития Apple, ответ будет другим — это M6, поскольку именно он открывает дорогу новому поколению транзисторной архитектуры, на которой в перспективе будут построены все последующие чипы компании.
Революция ли это — и что с ценами
Стоит ли обычному пользователю ждать революции от этого обновления? Скорее нет. Если у вас уже есть Mac на чипе четвёртого поколения, мир не перевернётся: с обновлением компьютер станет немного быстрее, холоднее и «умнее», но назвать это революционным скачком было бы преувеличением.
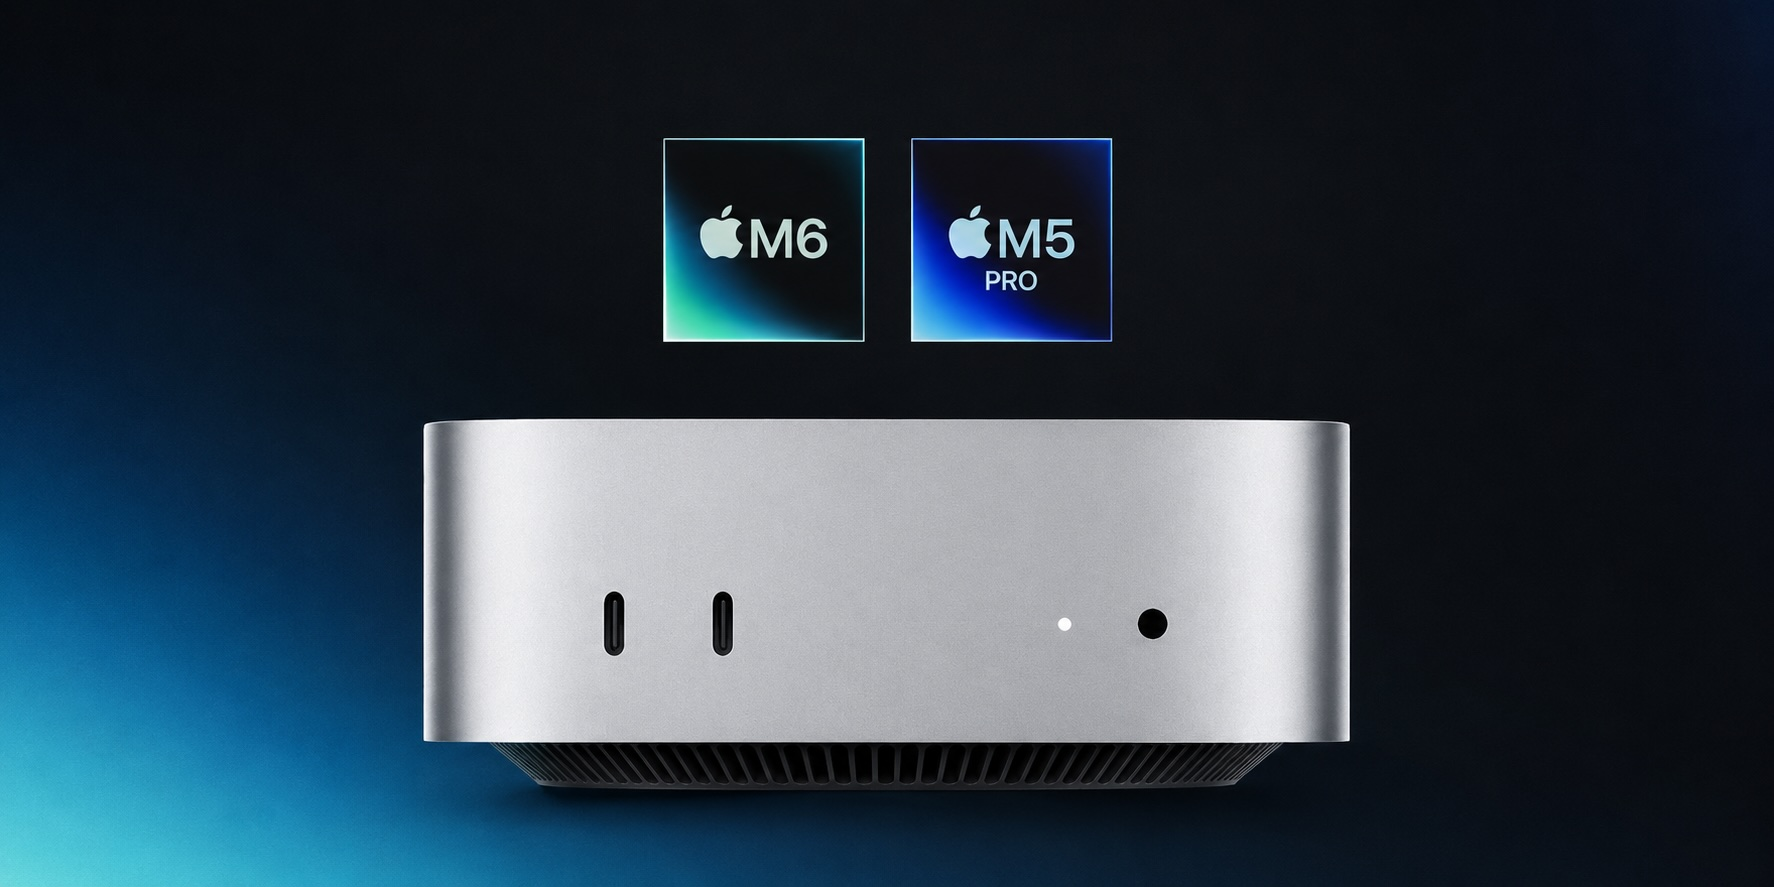
Зато настоящая революция в этом году случилась в ценах. M6 Mac mini начинается с 899 долларов, тогда как модель с M5 Pro стартует с 1699 долларов — обе цены на 100 долларов выше по сравнению с показателями предыдущего поколения. При этом предыдущий базовый Mac mini на чипе M4 стартовал с отметки в 599 долларов. Таким образом, самый доступный Mac mini подорожал сразу на существенную долю от прежней цены — и, судя по всему, именно этот скачок обычные покупатели заметят гораздо быстрее, чем переход с трёхнанометрового техпроцесса на двухнанометровый.
Подорожал и старший сегмент: цены на новый Mac Studio стартуют с 2499 долларов за версию с чипом M5 Max и с 5499 долларов за версию с M5 Ultra. Причина роста цен — не только в новых технологиях, но и в глобальном дефиците чипов памяти, который затронул весь компьютерный рынок и заставил производителей, включая Apple, повышать цены на память практически повсеместно. Именно нехватка памяти, к слову, стала одной из причин, почему конфигурация на 512 гигабайт для Mac Studio оказалась отложена до конца октября.
Что дальше: дорожная карта до M7
Финальный сюжетный поворот в этой истории касается будущего модельного ряда. По имеющимся сведениям, Apple впервые за всю историю Apple Silicon не выпустит версии Pro и Max для линейки M6 — это станет первым случаем, когда чип выходит без старших модификаций. Вместо этого компания решила ускорить переход к следующему поколению — линейке M7, ориентированной в первую очередь на задачи искусственного интеллекта.
Согласно имеющимся данным, базовый процессор M7 ожидается в первой половине 2027 года с пропускной способностью памяти около 240 ГБ/с, старшие версии M7 Pro и M7 Max должны выйти в конце 2027 года, а версия M7 Ultra — уже в 2028 году, с поддержкой до 1,5 терабайта оперативной памяти. Получается, что M6 может оказаться не полноценным семейством чипов, а своего рода переходным звеном, тогда как по-настоящему масштабная линейка стартует уже с M7. И когда это случится, фраза «самый мощный чип в истории Apple» неизбежно прозвучит снова — просто на этот раз речь пойдёт о совершенно другом порядке величин.
Оба анонса, о которых шла речь в этом материале, важны, но по-разному. M5 Ultra демонстрирует, какая вычислительная мощь доступна уже сегодня, тогда как M6 указывает направление, в котором будет двигаться вся архитектура Apple Silicon в последующие годы. Индустрия явно нацелена на постепенное объединение двух подходов — компактных энергоэффективных транзисторов нового поколения и многочиповых конструкций колоссального масштаба — и вопрос лишь в том, когда именно эти две философии сойдутся в одном чипе.

