Универсальный процессор умеет выполнять множество разных задач. Специализированный чип, напротив, проектируют под определённый вид вычислений. Такой подход давно применяют, например, в оборудовании для майнинга: если алгоритм стабилен и повторяется миллиарды раз, его можно воплотить непосредственно в устройстве и сократить лишние операции.
На обычном процессоре алгоритм выполняется как последовательность инструкций. В специализированной схеме значительную часть логики можно разместить непосредственно в аппаратуре. Такой чип не так гибок, зато при подходящей нагрузке может выполнять нужную работу с меньшим количеством лишних операций. Разработка обходится дорого, поэтому она имеет смысл, если задача повторяется в большом масштабе и ожидается, что её основные принципы не изменятся слишком быстро.
Искусственный интеллект тоже включает разные этапы работы. Во время обучения модель меняет параметры и требует гибкого оборудования. При инференсе уже обученная модель отвечает на запросы пользователей. Этот процесс повторяется постоянно, поэтому скорость отклика, пропускная способность памяти и стоимость каждого ответа становятся особенно важными.
Языковая модель генерирует ответ последовательно: следующий фрагмент текста зависит от предыдущего. Для этого система хранит контекст диалога, включая так называемый KV-кэш. По мере удлинения разговора объём данных растёт, и ускорителю приходится всё больше взаимодействовать с памятью. Поэтому высокая пиковая вычислительная мощность сама по себе не гарантирует быстрого ответа.
Можно представить себе задачу как написание длинного письма, где перед каждым новым словом приходится учитывать уже написанный текст. Модель использует сохранённый контекст, чтобы не пересчитывать его полностью заново, однако этот кэш всё равно нужно хранить и перемещать между компонентами системы. Поэтому в инференсе узким местом часто оказывается не умножение чисел, а скорость доступа к данным.
Именно здесь у специализированного чипа появляется потенциальное преимущество: архитектуру можно построить так, чтобы модельные данные находились ближе к вычислениям. Но ускорение зависит от всей системы — памяти, соединений между чипами, программного обеспечения и способа распределения запросов. Сравнить только пиковую производительность недостаточно.
Что известно о Jalapeño
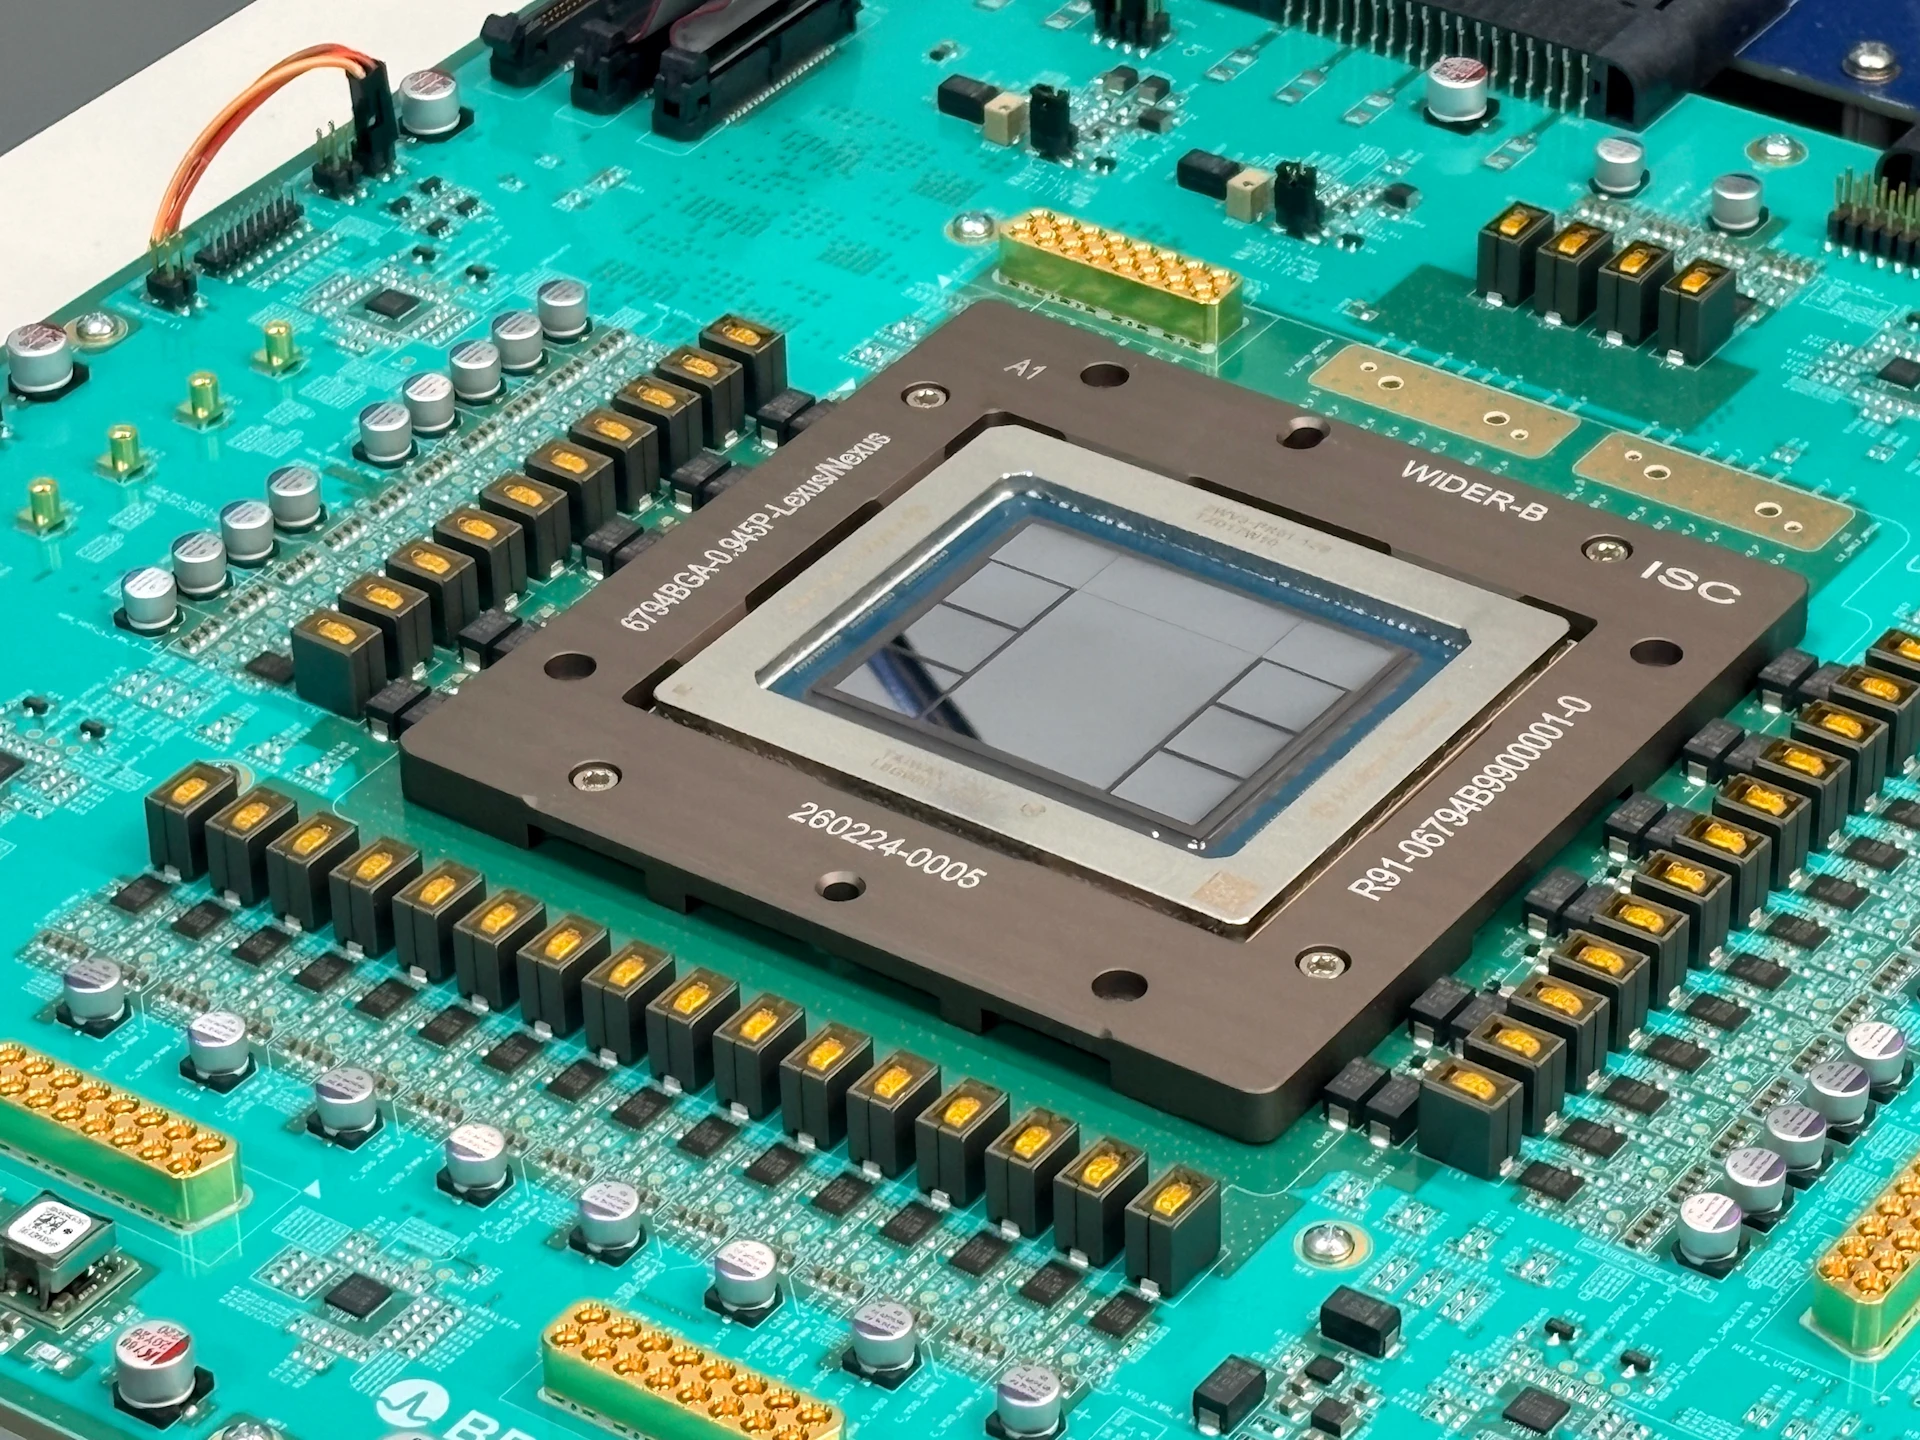
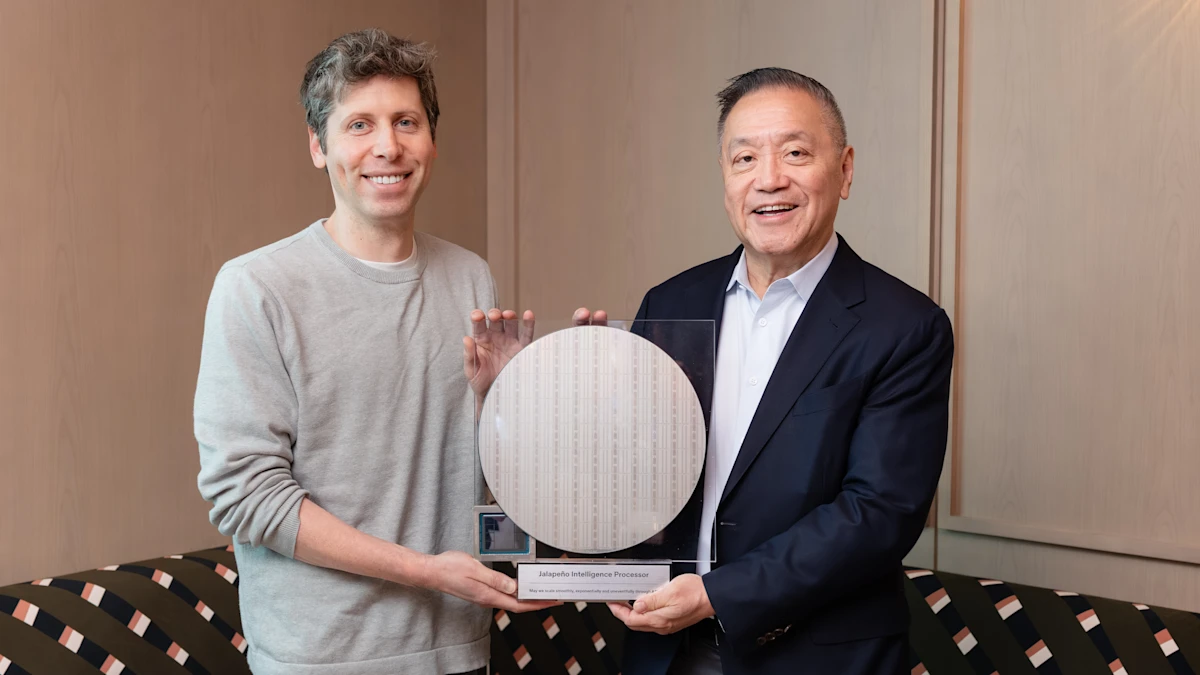
24 июня 2026 года OpenAI и Broadcom объявили о Jalapeño — первом разработанном OpenAI ускорителе для инференса. OpenAI отвечает за проектирование чипа, Broadcom участвует в его реализации и сетевых технологиях, а Celestica помогает с платами, стойками и системной интеграцией. Инженерные образцы, по сообщению OpenAI, выполняют задачи машинного обучения в лаборатории.
Архитектура рассчитана на языковые модели. OpenAI пишет, что команда проектировала чип, память, сеть и программную систему вместе, чтобы сократить перемещение данных. В частности, модельное состояние и KV-кэш можно размещать локально, ближе к вычислительным блокам. Компания также описывает разные режимы инференса: обработка входного запроса больше зависит от вычислений, а последовательная генерация ответа — от скорости памяти.
OpenAI сообщает, что Jalapeño прошёл путь от первоначального проекта до передачи дизайна на производство за девять месяцев. Компания использовала свои модели для ускорения отдельных этапов проектирования, оптимизации и проверки. При этом полный набор технических характеристик чипа публично не раскрыт. Поэтому точные цифры о конфигурации памяти, числе ускорителей в кластере или его общей вычислительной мощности, встречающиеся в пересказах, следует считать неподтверждёнными, пока их не опубликует компания.
Передача дизайна на производство не означает, что чип уже массово выпускается или развёрнут во всех дата-центрах. В июне 2026 года OpenAI говорила об инженерных образцах в лаборатории и планировала первые внедрения к концу года. В августе компания сообщила о подготовке программного обеспечения, квалификации производства и масштабирования. Это показывает продвижение проекта, но ещё не даёт полной картины его выхода на промышленный объём.
По заявлению OpenAI, модели помогали исследовать возможные варианты реализации, ускорять циклы измерений и проверки, а также оптимизировать отдельные схемы. Это интересная часть проекта: ИИ использовали при разработке аппаратуры, которая затем должна обслуживать будущие модели. Но девять месяцев — срок от начала разработки до передачи проекта на производство, а не подтверждённый срок от идеи до массового выпуска.
Что показали испытания
В августе 2026 года OpenAI опубликовала первые результаты Jalapeño в публичном тесте InferenceX, разработанном SemiAnalysis. В испытаниях использовались GPT-OSS 120B, DeepSeek R1 670B и Kimi K2.5 1T. По опубликованным компанией данным, на пиковых режимах чип обеспечил в 1,5–1,9 раза больше полезной работы на ватт и в 1,7–3,6 раза меньшую задержку до завершения запроса, чем системы сравнения.
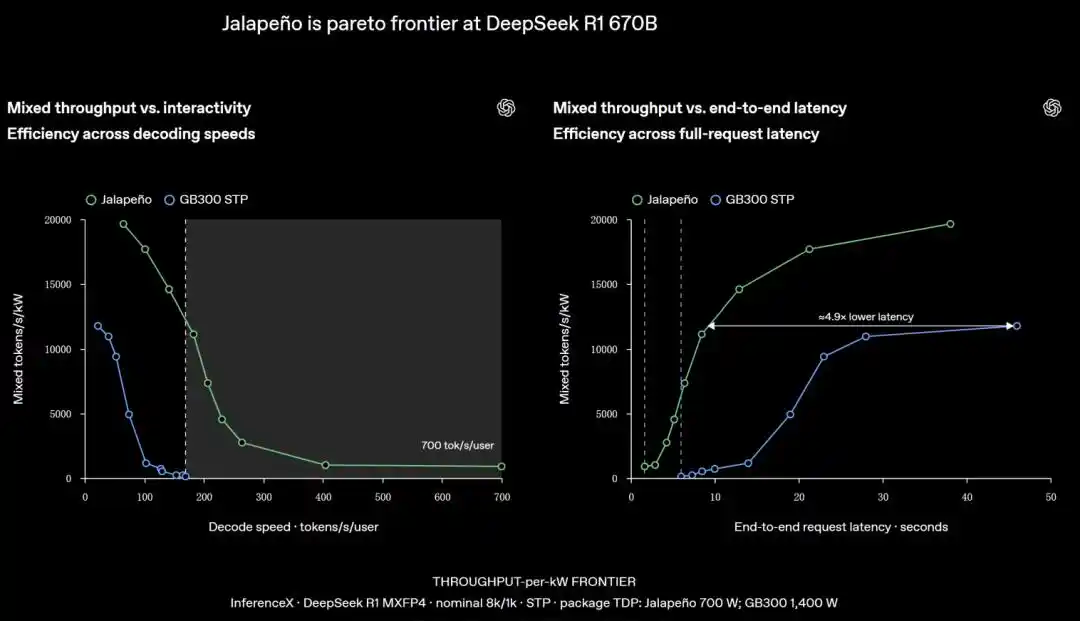
Самая громкая цифра — преимущество примерно в 104 раза по пропускной способности на киловатт в одном режиме DeepSeek R1. Это сравнение выполнено при заданной скорости выдачи токенов на пользователя и относится к конкретному сценарию, а не означает, что Jalapeño в сто раз быстрее любого ускорителя. В той же публикации OpenAI приводит более умеренное преимущество по пиковой производительности на ватт — около 1,7 раза для DeepSeek R1. Измеренное потребление самого Jalapeño на испытанных нагрузках, по данным компании, не превышало 550 ватт при заявленном тепловом пакете 700 ватт.
Эти результаты выглядят многообещающе, но их нужно читать с учётом условий теста и источника: показатели опубликованы OpenAI, а сравнение зависит от модели, конфигурации системы и целевой задержки. Для массового применения важны не только результаты стендовых испытаний, но и стабильность производства, программная поддержка и работа в больших кластерах.
Почему это не означает конец универсальных ускорителей
Собственный чип может снизить стоимость конкретной повторяющейся задачи, но специализация всегда несёт риск: оборудование труднее перенастроить, если модели и алгоритмы изменятся. Поэтому Jalapeño пока следует рассматривать как специализированный инструмент для инференса, а не замену всему оборудованию для обучения и исследований.
OpenAI планирует начать развёртывание платформы до конца 2026 года и расширять её в последующие годы. На 21 октября компания сообщала о подготовке программной системы, производственной квалификации и масштабирования. Значит, это уже не только проект на бумаге, но и его массовое внедрение ещё предстоит подтвердить.
Наиболее реалистично видеть Jalapeño частью вычислительной инфраструктуры OpenAI. Он может взять на себя повторяющиеся задачи обслуживания моделей, тогда как универсальные ускорители останутся полезны для обучения, экспериментов и новых видов вычислений. Объявление о собственном чипе само по себе не означает отказа от оборудования других производителей.
У специализированного кремния есть и долгосрочный риск: модели и методы работы могут измениться быстрее, чем оборудование. OpenAI утверждает, что Jalapeño рассчитан на широкий круг современных и будущих языковых моделей, но это обещание предстоит проверять на практике по мере появления новых архитектур.
Если специализированные чипы снизят цену вычислений, пользоваться ИИ могут начать чаще и для большего числа задач. Это может увеличить общий спрос на вычислительные мощности, даже если каждый отдельный запрос станет дешевле. В этом состоит парадокс Джевонса: повышение эффективности иногда приводит к росту суммарного потребления ресурса. Для индустрии главный вопрос теперь в том, удастся ли совместить более доступные ответы с устойчивым ростом вычислительной инфраструктуры.

